直接答案:判断过拟合要同时看训练集和未参与参数更新的验证集。若训练损失持续下降,而验证损失在某个检查点后反弹,或训练指标明显优于验证指标,才有了过拟合证据。不要只凭“模型很大”“训练很久”或一次验证波动下结论。
过拟合、欠拟合和正常泛化怎么区分
| 观察 | 训练集 | 验证集 | 优先判断 |
|---|---|---|---|
| 两边都差 | 损失高或任务指标低 | 同样差 | 欠拟合、特征不足或优化未完成 |
| 训练好、验证差 | 持续改善 | 停滞或恶化 | 过拟合,也要先排除泄漏与分布差异 |
| 两边同步改善 | 改善 | 改善 | 仍在学习可泛化模式 |
| 验证突然跳变 | 可能稳定 | 单点异常 | 先查评估管线、NaN、样本变化 |
Google 的机器学习课程把过拟合概括为训练数据表现好、对新样本表现差,并强调训练、验证、测试和真实世界分布之间的可比性。这个定义给出了边界:训练分数高只是现象的一半,另一半必须来自独立数据。
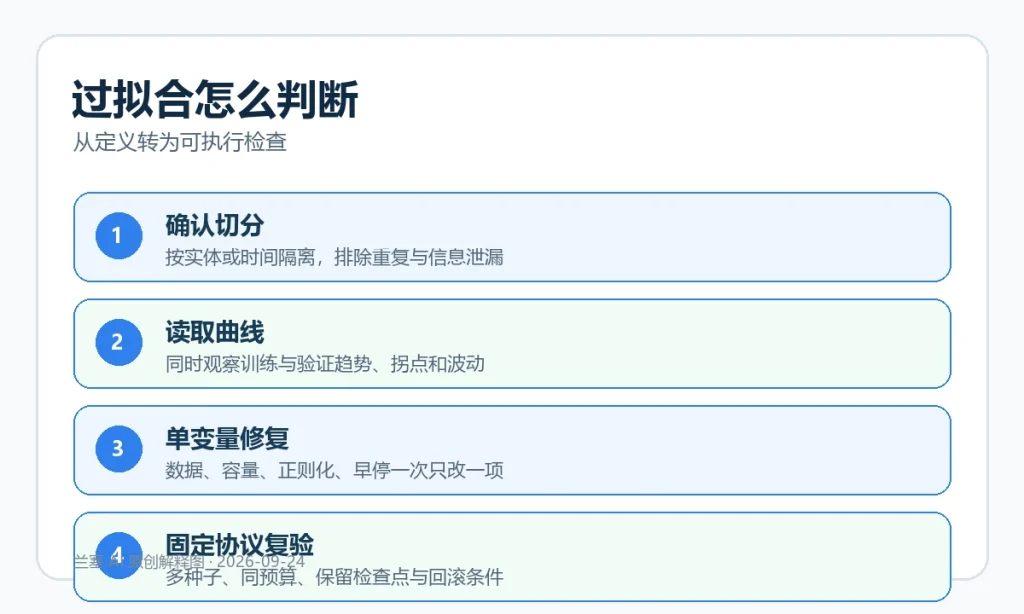
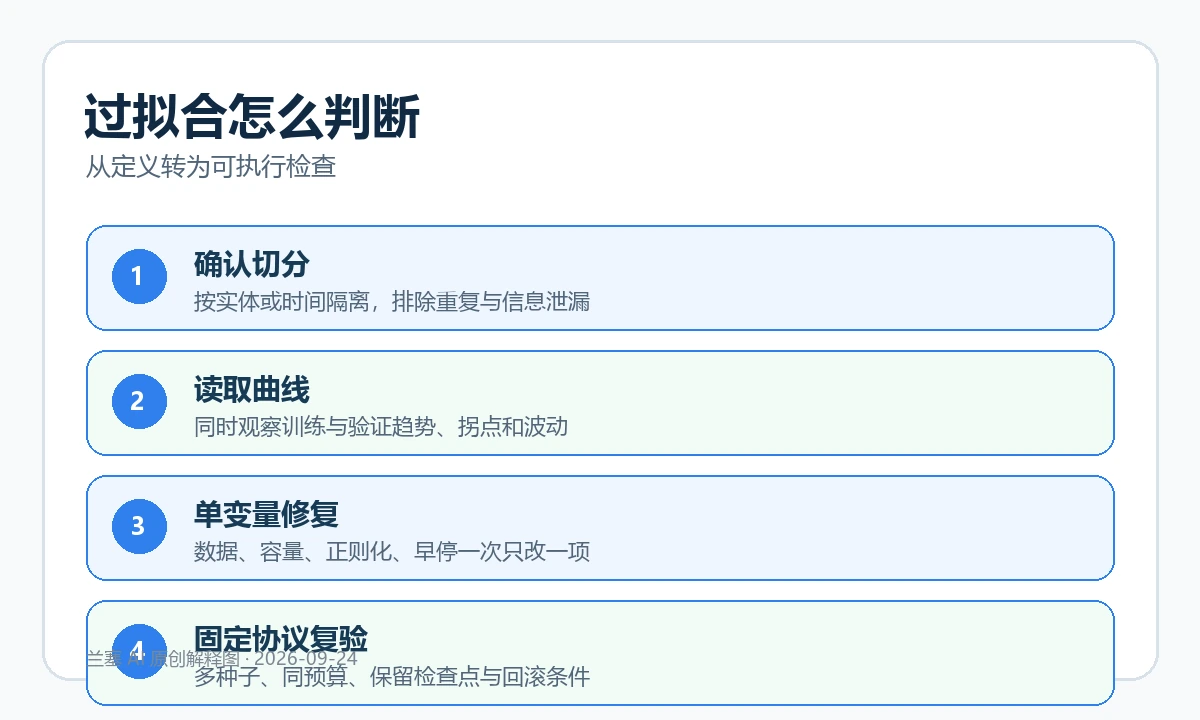
第一步:先证明验证集真的独立
- 按实体切分:同一用户、设备、文档片段或相邻帧不能跨训练和验证两边,否则模型可能记住实体特征。
- 按时间切分:预测未来时,应让验证窗口晚于训练窗口;随机切分可能把未来信息泄漏给训练。
- 只在训练集拟合预处理:归一化统计量、词表、特征选择和缺失值填充都不能偷看验证集。
- 保留最终测试集:验证集用于选方案;测试集只在方案冻结后使用。反复查看测试集会把它变成另一个验证集。
第二步:用曲线而不是单个数字诊断
每个检查点记录训练损失、验证损失、主任务指标、样本版本和随机种子。重点看趋势与拐点:验证损失最低的检查点常是早停候选,但不能机械地把任意一次反弹当成拐点。至少复跑多个种子,报告均值与波动,并确认指标方向一致。
下面的离线小工具读取成对损失序列,输出最小验证损失所在轮次、末轮泛化差距和一个可解释的诊断标签。它只验证判定逻辑,不是生产模型实测,也不能代替领域指标。
python diagnose-overfitting.py --train 0.90,0.62,0.43,0.31,0.24 --valid 0.94,0.70,0.58,0.61,0.69第三步:原因不同,修复顺序也不同
- 先修数据:去重、改正泄漏、改善标签和补足目标分布。若验证集不可信,正则化只会掩盖问题。
- 再做容量基线:减少层数、宽度、特征或训练轮次,观察验证指标是否稳定。简单模型是诊断工具,不一定是最终方案。
- 单独调正则化:L2 会惩罚大权重;Dropout 在训练时随机置零元素、评估时为恒等映射。两者机制不同,不要一次同时改。
- 设置早停规则:提前写明监控指标、最小改善量、耐心轮数与恢复最佳权重方式,避免看完曲线后挑最漂亮的点。
四个常见误判
训练准确率接近 100%,就一定过拟合?
不一定。任务可能很容易,或训练集本来可分。还要看独立验证结果和数据切分。
增加更多数据总能解决?
不一定。重复、错标或不代表目标场景的数据不会自动提升泛化;先检查质量与覆盖。
验证集更好是不是不正常?
可能来自训练阶段的数据增强、Dropout 或更难的训练样本,也可能是验证集太小。应核对评估模式和样本构成。
正则化越强越安全吗?
过强会造成欠拟合。修复应在同一任务指标、同一预算下做可回滚比较。
可复核的最小实验记录
- 数据快照、实体/时间切分规则和去重结果;
- 模型版本、代码提交、随机种子与训练预算;
- 训练/验证曲线以及最佳检查点选择规则;
- 唯一变化项、预期机制、结果与回滚条件;
- 最终测试只运行一次的时间和签名。
如果曲线问题来自学习率而非泛化,可转到学习率选择与可回滚实验;若怀疑批归一化训练/推理状态不一致,参见批归一化状态检查。准备上线时,再按模型部署验收与回滚清单固化门禁;GPU 环境问题可对照CUDA 兼容性检查。
核验边界与一手来源
本文于 2026-09-24 核对 Google Machine Learning Crash Course 的过拟合、L2/早停与损失曲线页面,以及 PyTorch Dropout 文档。官方材料说明机制和接口;本站给出的流程与脚本是编辑部的可复核整理,不代表对你的数据、模型或线上收益做过实测。
- Google 过拟合说明(2026-09-24 核验)
- Google L2 与早停(2026-09-24 核验)
- Google 损失曲线解读(2026-09-24 核验)
- PyTorch Dropout(2026-09-24 核验)