
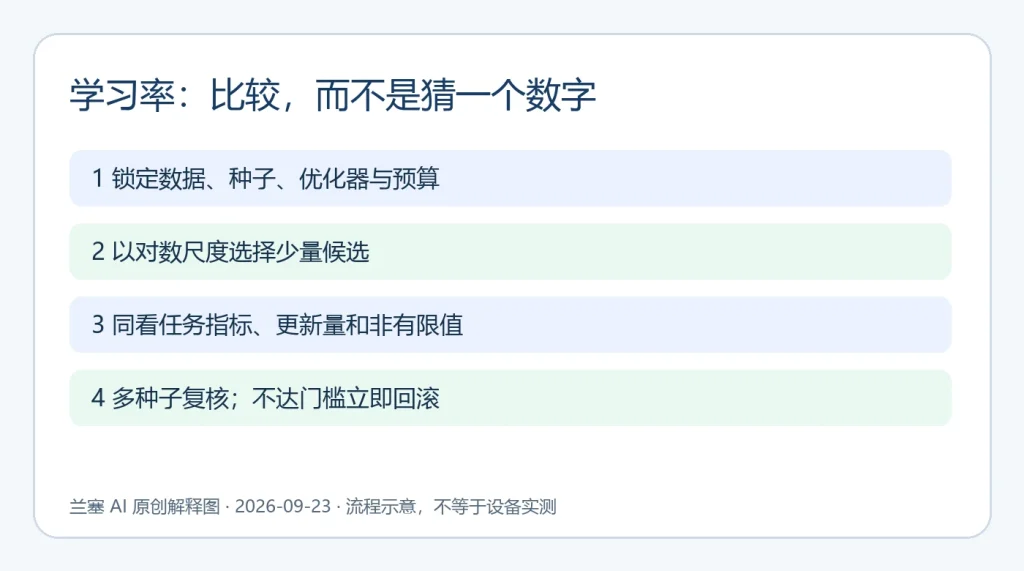
学习率决定优化器把当前梯度换成多大的参数更新,但它不是“越小越稳、越大越快”的单向旋钮。合适范围取决于损失尺度、批量、优化器、参数化、调度器与训练阶段。可靠做法是先锁定数据和随机性,以任务指标、损失轨迹、更新量和非有限值共同判断,再逐项调整。
学习率到底控制什么?
以最基础的随机梯度下降为例,参数更新可写成“新参数等于旧参数减去学习率乘梯度”。PyTorch SGD 文档给出含动量、权重衰减和 Nesterov 的完整更新规则。加入这些机制后,不能再把日志中的梯度值直接乘学习率当成所有参数的实际更新;应同时记录更新前后参数差。
学习率过大时,常见现象是损失强烈震荡、快速出现非有限值、验证指标反复退化;过小时可能长时间没有有意义的任务改善。但“损失不降”也可能来自标签、归一化、冻结参数、断开的计算图或错误目标,因此现象只能触发排查,不能单独定罪。
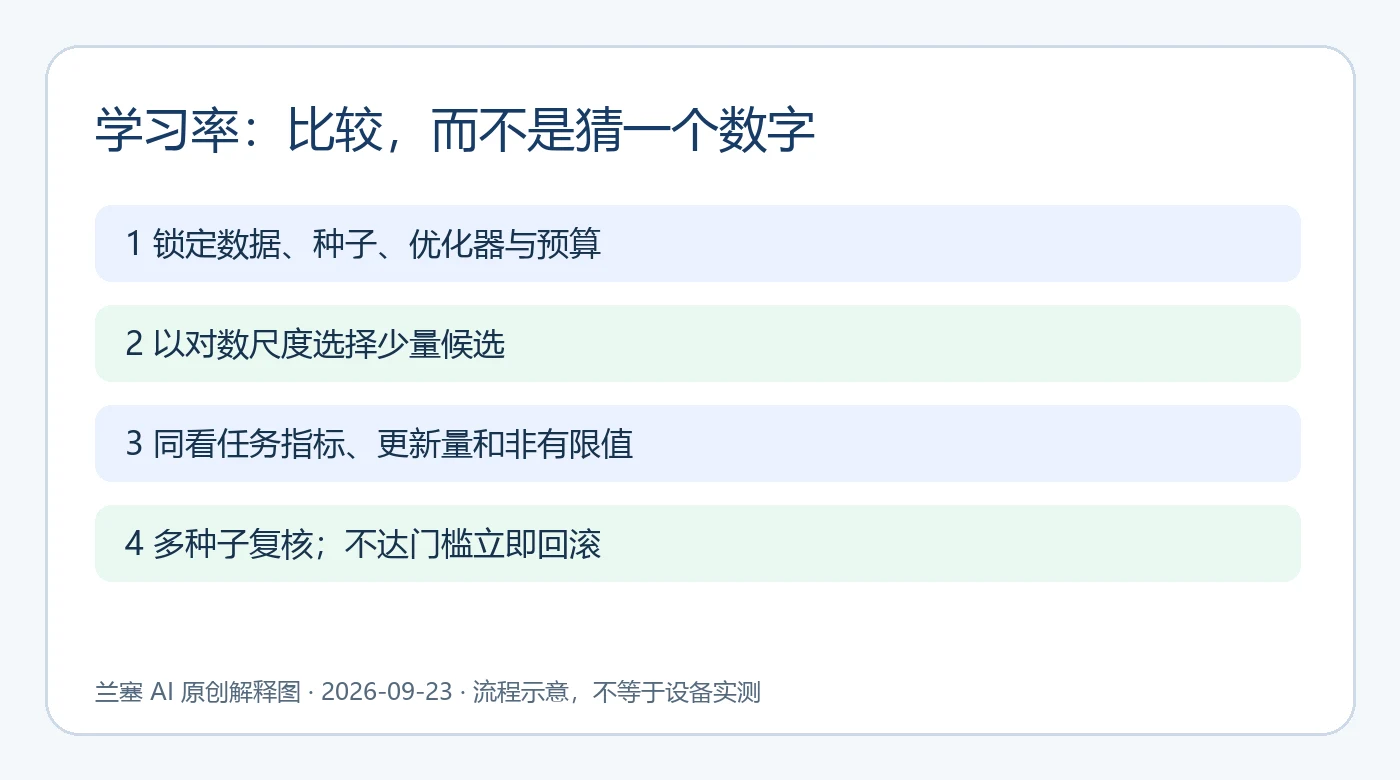
如何建立可比较的基线?
- 固定代码版本、模型初始化、训练与验证划分、数据顺序、批量、优化器及精度设置,保存随机种子和环境摘要。
- 确定主任务指标与不可接受条件,例如验证集准确率、生成质量人工检查点、非有限值次数和最长训练预算。
- 记录每步或固定间隔的训练损失、验证指标、梯度范数、参数更新范数与当前学习率。只看最后一个损失值会掩盖震荡和过拟合。
- 以对数尺度选择少量候选,例如相邻候选相差三倍或十倍;每次只改变学习率。
- 至少重复多个种子,报告中位趋势与离散程度,不挑最好一次作为结论。
PyTorch 超参数调优教程展示了把学习率等配置作为试验参数并报告中间结果的基本方式。教程中的搜索空间与结果属于示例,不能原样当成你的模型推荐值。
一个不冒充训练实测的最小算术夹具
设一维参数为 2,梯度为 0.5。忽略动量、权重衰减和缩放时,学习率 0.1 的单步更新量是 0.05,新参数为 1.95;学习率 0.01 的更新量是 0.005,新参数为 1.995。这个例子只验证更新式和日志口径,不能证明哪个学习率在真实任务上更好。
真实训练中建议计算“更新范数除以参数范数”,并同时保存梯度范数。若混合精度启用了梯度缩放,要明确记录是在取消缩放前还是之后观察。若存在梯度累积,要标记一次优化器更新包含多少微批次,否则步数无法横向比较。
调度器应该何时加入?
先用固定学习率得到可解释基线,再引入调度器。PyTorch 优化器文档列出按里程碑、余弦、指标停滞等调度方式。调度器的调用顺序、单位是 step 还是 epoch、恢复检查点后的状态都会改变曲线;保存模型时也要保存优化器与调度器状态。
预热可以限制训练初期的骤大更新,但不能修复错误标签、断图或错误损失。降低学习率可能让曲线更平滑,却也可能在预算内毫无进展。任何策略都应回到同一验证集和任务门槛,不以“曲线好看”替代结果。
什么时候保留,什么时候回滚?
- 若候选在相同预算和多个种子上改善主任务指标,同时没有增加非有限值、显著拉长训练或破坏关键子集,可进入更长验证。
- 若只有训练损失更低而验证指标退化,按过拟合或目标错配排查,不宣布学习率更优。
- 若一次运行改善、其余运行无效,应报告不确定性并扩大重复,不把偶然结果包装成结论。
- 若恢复训练后曲线跳变,先核对优化器与调度器状态、全局步数和数据位置。
最终回执至少包含代码与数据版本、候选值、种子、有效批量、训练预算、主指标、失败次数和回滚阈值。本文没有在读者的模型和数据上训练,因此不提供通用最佳学习率。若梯度为 None 或接近零,先参照梯度消失与计算图排查,不要单靠放大学习率掩盖根因。





