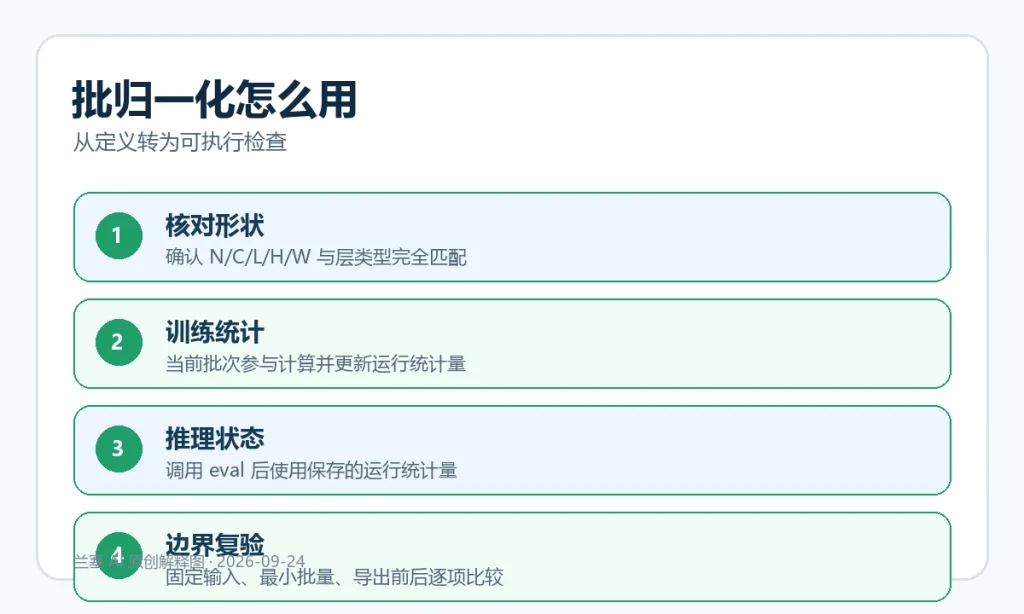
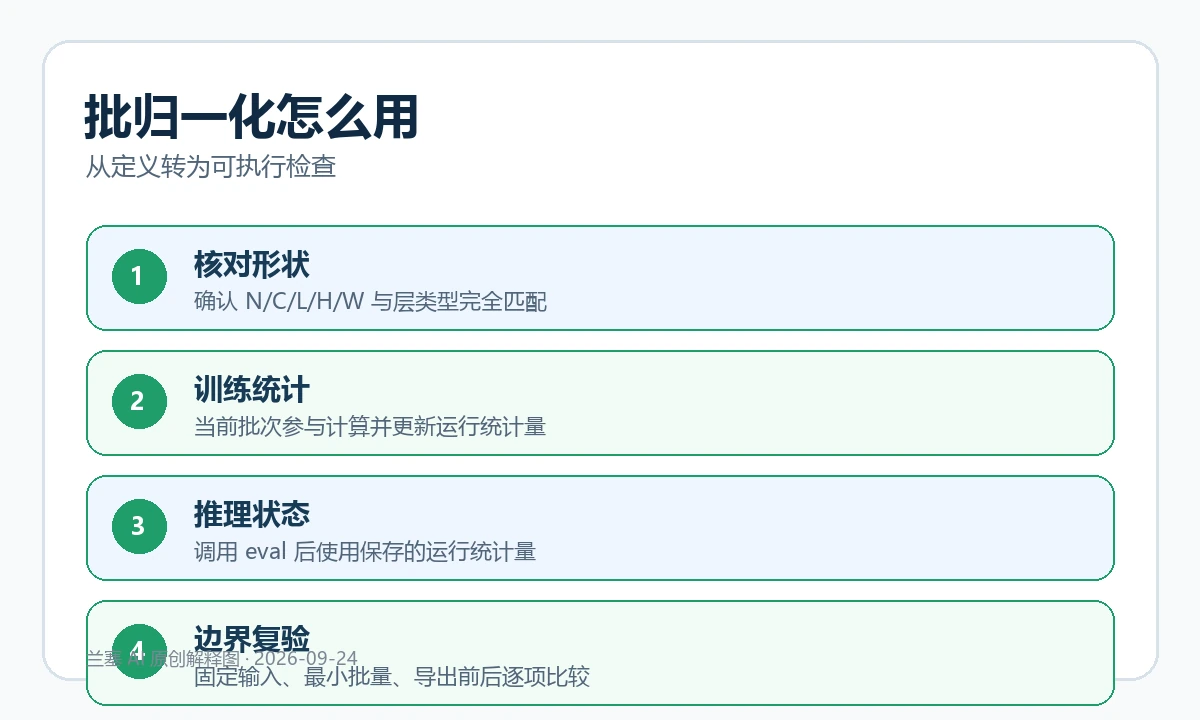
直接答案:批归一化(Batch Normalization)不是一句“把数据变成均值 0、方差 1”就能用对。工程上最重要的是区分训练与推理:训练阶段通常用当前小批量统计量并更新运行统计量;调用 eval() 后,推理通常使用保存的运行统计量。状态、维度或批量条件不一致,都可能让离线结果与线上输出发生偏差。
BatchNorm 实际计算了什么
对一个通道,BatchNorm 先根据指定维度上的样本计算均值与方差,再做标准化,最后用可学习参数 γ 与 β 缩放和平移。ε 用于数值稳定。这里的“指定维度”取决于层类型,不能把 BatchNorm1d 与 BatchNorm2d 只当作名字不同。
| 层 | 常见输入 | 统计粒度 | 常见错误 |
|---|---|---|---|
| BatchNorm1d | (N,C) 或 (N,C,L) | 每个 C 通道 | 把特征维放错位置 |
| BatchNorm2d | (N,C,H,W) | 每个 C 通道,跨 N/H/W | 把 NHWC 直接输入 NCHW 层 |
| GroupNorm | (N,C,*) | 每个样本的通道组 | 组数不能整除通道数 |
训练模式与推理模式为什么会不同
PyTorch 文档说明,BatchNorm 默认在训练时维护运行均值和运行方差,并在评估时使用它们。Module.eval() 会把模块设为评估模式,这只影响 Dropout、BatchNorm 等有训练/评估差异的模块,不会自动关闭梯度;需要节省推理内存时还应使用 torch.no_grad() 或推理模式。
- 训练前:确认模型处于
train(),参数与缓冲区被正确保存。 - 验证/推理前:调用
eval(),固定同一输入并重复运行,检查输出是否稳定。 - 加载权重后:核对 state_dict 的 missing/unexpected keys,尤其是 running_mean、running_var 与 num_batches_tracked。
- 导出后:用相同样本比较框架内输出和导出运行时输出,并给出允许误差。
最小状态检查脚本能证明什么
随文脚本在本地 PyTorch CPU 上用固定张量运行 BatchNorm1d:先在训练模式更新运行统计量,再切换评估模式,用完全相同的输入运行两次并比较结果。通过表示状态切换和确定性检查逻辑可复现,不表示你的模型精度、吞吐或线上分布已经通过验收。
python check-batchnorm-state.py小批量时为什么容易出问题
批次很小时,当前批次统计量可能波动较大;最后一个不足批次、分布高度相似的样本或多卡拆分后的局部小批量,也会改变统计条件。不要只把 batch size 从 64 改成 2 然后比较最终精度,还要记录每层实际看到的局部批量、数据采样方式和累积统计量。
可选动作不是自动替代答案
- 增加有效批量或使用同步 BatchNorm,但要评估通信开销与全局样本是否同分布;
- 冻结已有运行统计量,前提是目标数据与统计量来源匹配;
- 考虑 GroupNorm 等不依赖批次统计量的层,但必须重新训练并验证,不能在已训练模型中随意替换;
- 若只有最后一个小批次异常,检查 DataLoader 的
drop_last与采样策略,同时评估丢样本的代价。
六项上线前验收
- 记录框架版本、层类型、num_features 与输入形状;
- 确认训练、验证、导出和服务入口各自的 train/eval 状态;
- 保存运行统计量摘要及权重文件哈希;
- 用固定样本重复推理,检查输出稳定性;
- 比较常规批量、最小批量和真实服务批量;
- 准备关闭新版本或恢复旧权重的回滚条件。
与相邻问题如何分工
BatchNorm 状态错误可能造成验证波动,但训练与验证长期分叉还要按过拟合诊断流程排查;若损失振荡或发散,先检查学习率实验。准备发布时,把状态、固定样本与权重哈希放入模型部署验收记录;GPU 运行环境不一致则按CUDA 四层兼容性定位。
核验边界与一手来源
本文于 2026-09-24 核对 PyTorch BatchNorm1d、BatchNorm2d、Module.eval 与 GroupNorm 文档。接口行为会随框架版本变化,请以目标环境安装版本为准。本站的检查顺序和脚本属于编辑部整理,不构成对特定模型性能的实测结论。
- PyTorch BatchNorm1d(2026-09-24 核验)
- PyTorch BatchNorm2d(2026-09-24 核验)
- PyTorch Module.eval(2026-09-24 核验)
- PyTorch GroupNorm(2026-09-24 核验)