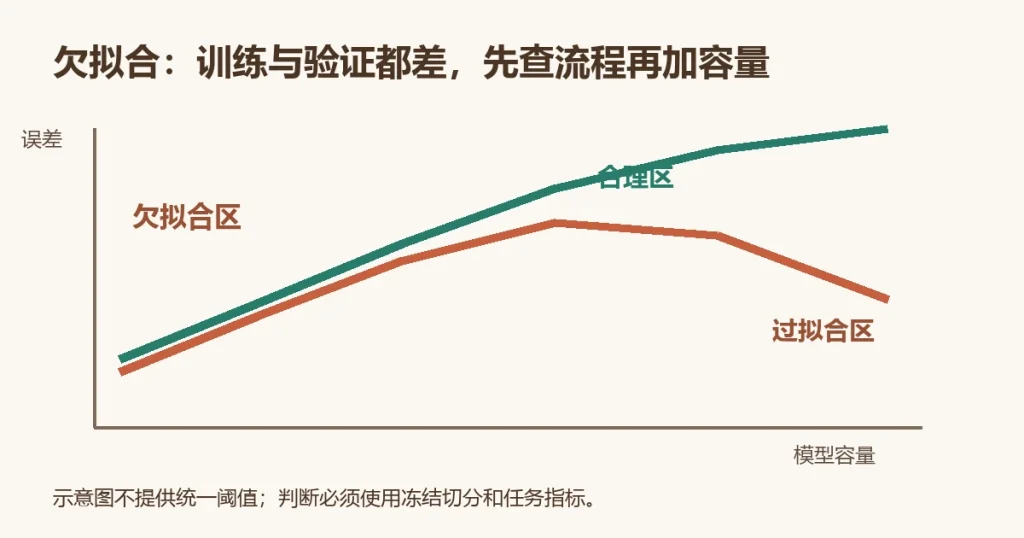
直接答案:欠拟合是模型连训练数据中的主要规律都没有学到,通常表现为训练指标和验证指标都低于预设门槛,而且两者差距不大。不要看到低分就立刻换大模型:先排查标签、特征流水线和指标,再逐步增加有效特征、容量或训练强度,每次保留对照和回滚点。
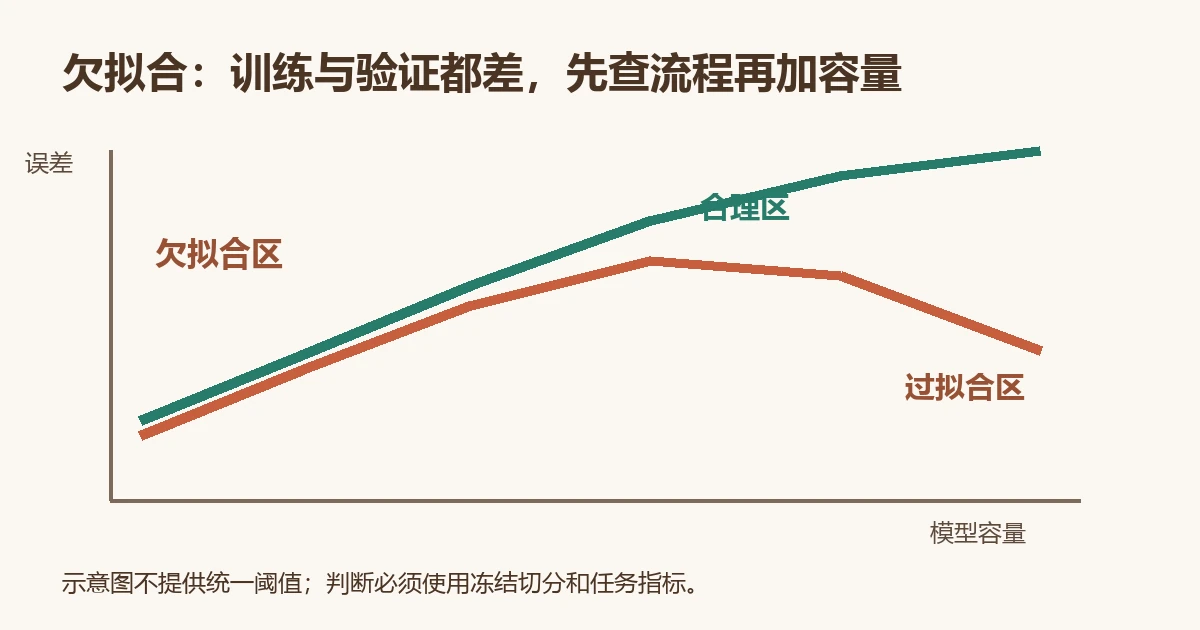
先用训练—验证组合判断
| 训练表现 | 验证表现 | 更可能的问题 | 下一步 |
|---|---|---|---|
| 差 | 差且接近 | 欠拟合或流水线错误 | 查标签/特征/指标,再增加学习能力 |
| 好 | 明显较差 | 过拟合、泄漏或分布差异 | 固定切分,查泄漏和泛化 |
| 都好且稳定 | 接近任务门槛 | 合理拟合 | 锁定测试集,进入独立验收 |
| 整体波动大 | 随切分大幅变化 | 样本不足或切分不稳 | 分组/时间切分并报告不确定性 |
五步诊断,不把所有改动一起上
1. 验证标签与评价指标
确认标签没有反转、错位或大量缺失,指标与任务一致。类别不平衡时,只看准确率可能掩盖少数类完全失败;回归任务也要确认单位和缩放。
2. 检查特征流水线
查看训练前后的样本数、缺失率、取值范围和特征方差。列名漂移、全部填零、错误归一化或文本被截断,都可能让模型看不到有效信号。
3. 画样本量学习曲线
scikit-learn 的学习曲线用不同训练样本量记录训练与交叉验证分数。两条曲线都停在低水平,说明增加同类样本未必够;若验证分数仍随样本量上升,补代表性数据可能有效。
4. 画容量或超参数验证曲线
逐步改变树深、正则强度、特征数或网络宽度,只动一个主因素。训练和验证同时改善说明原容量可能不足;训练继续改善而验证转差,已经越过合理区。
5. 检查优化是否真正收敛
学习率不合适、训练轮次太少、梯度或数值异常也会伪装成容量不足。先看损失曲线和停止原因,再决定是否增加轮次或改变优化器。
修复顺序与停止条件
- 修正数据、标签、特征和指标错误。
- 加入有依据的有效特征,删除把信号抹平的处理。
- 适度放宽正则或早停限制。
- 增加模型容量或改用更匹配的模型族。
- 调整优化与训练预算,并监控验证曲线。
- 在冻结测试集上做一次最终确认;若验证不再改善就停止扩容。
增加复杂度会提高训练能力,也可能快速转为过拟合。每一步都要保存数据版本、随机种子、参数、训练/验证结果和旧模型;没有对照的“大改一轮”不能说明是哪项措施有效。
什么时候不要继续调模型
- 标签本身不可重复或任务目标尚未定义。
- 训练数据与上线人群、时间或设备不一致。
- 模型已经达到技术指标,但业务失败来自界面、规则或人工流程。
- 高风险错误没有人工接管、权限限制和回滚路径。
一手资料
- Google:拟合、过拟合与欠拟合(核验于 2026-09-13)
- Google:模型复杂度(核验于 2026-09-13)
- scikit-learn:学习曲线(核验于 2026-09-13)
- scikit-learn:交叉验证(核验于 2026-09-13)
- scikit-learn:模型评价(核验于 2026-09-13)