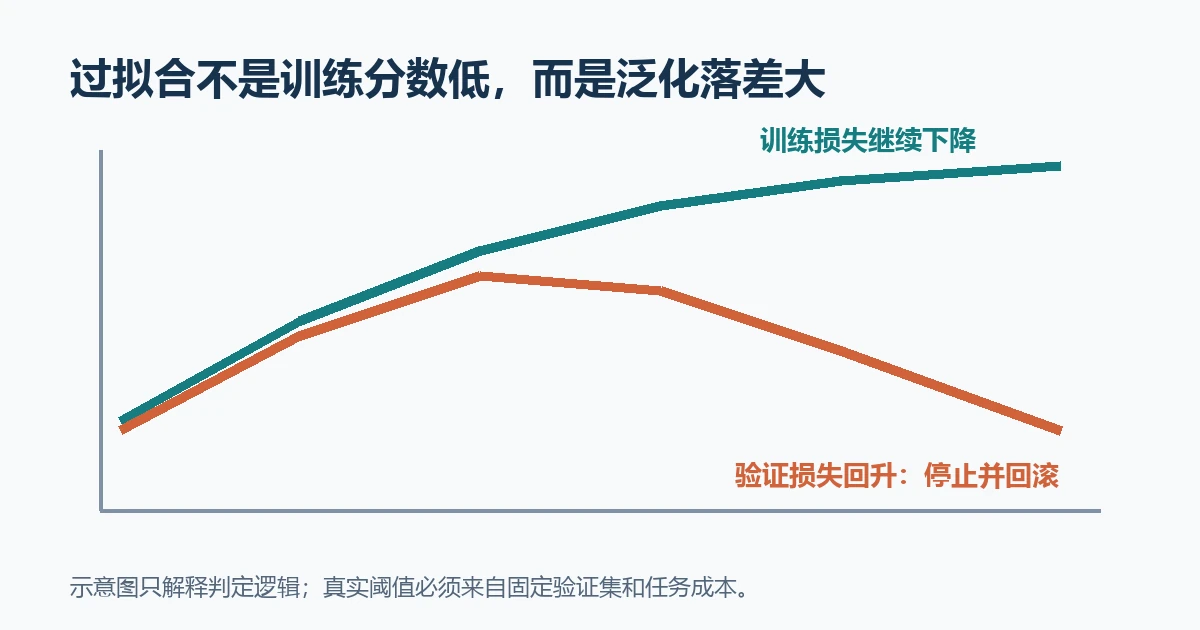
直接答案:过拟合不是“训练没练好”,而是模型把训练样本的偶然细节、噪声或泄漏当成规律,导致训练指标很好、验证或真实数据明显变差。先固定数据切分和评价指标,再看训练—验证差距;确认问题后依次排查数据泄漏、样本代表性、模型复杂度与训练轮次,而不是一次叠加所有正则化技巧。
先区分过拟合、欠拟合和正常泛化
| 状态 | 训练集 | 验证/测试集 | 优先动作 |
|---|---|---|---|
| 欠拟合 | 也很差 | 很差 | 检查特征、模型容量与优化是否足够 |
| 合理拟合 | 达到目标 | 接近训练表现且稳定 | 冻结基线,进入独立测试和部署验证 |
| 过拟合 | 继续改善 | 停滞或恶化 | 先排泄漏,再控制复杂度、轮次或补代表性数据 |
Google 的机器学习课程把泛化定义为对新数据作出良好预测;因此“训练准确率 99%”本身既不能证明模型好,也不能证明过拟合。必须同时记录验证集的抽样规则、指标、置信区间或多次切分波动。类别严重不平衡时,准确率还可能掩盖召回率或代价敏感错误。
用四步证据链判断,而不是凭感觉
- 冻结切分。在调参前保存训练、验证、测试样本 ID;时间序列按时间切分,用户级数据按用户分组,防止同一主体跨集合泄漏。
- 冻结指标。分类任务预先选准确率、F1、AUROC 或业务代价;回归任务选 MAE、RMSE 等。选择应由错误成本决定。
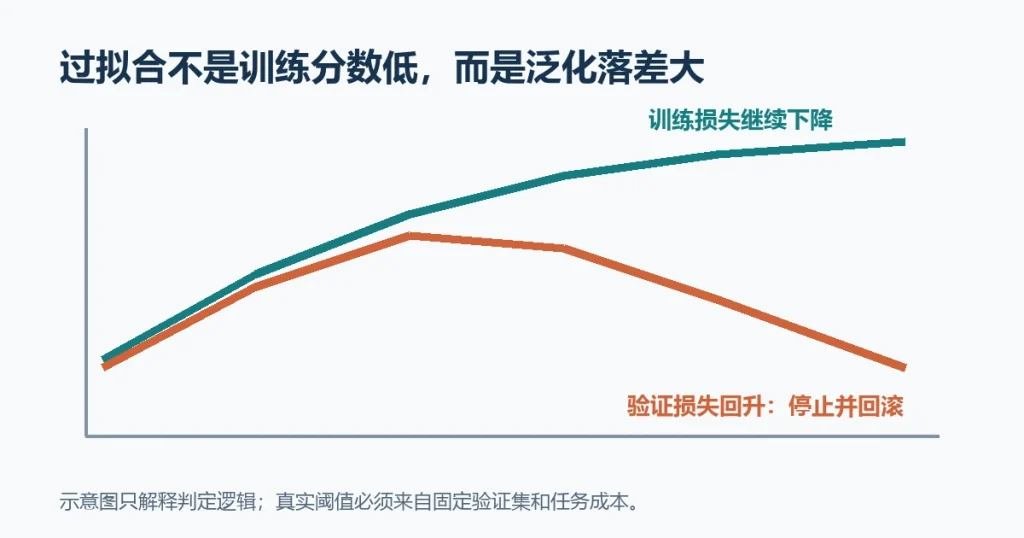
- 画学习曲线。同时记录训练与验证指标随样本量、轮次或模型容量变化。训练继续变好而验证转差,才形成较强的过拟合信号。
- 最后一次独立测试。测试集不参与特征、阈值和超参数选择;否则它会逐渐变成第二个验证集。
修复顺序:先修数据,再调模型
1. 排除泄漏和错误切分
目标字段的未来信息、同一用户的重复记录、归一化时先看了全量数据,都会制造虚假的高分。修正泄漏常使训练分数下降,但可信度上升。
2. 增加代表性,而不只是增加数量
更多重复样本未必有用。应补足将来真实输入中的地区、设备、时间段、长尾类别与失败条件,并保持采集和标注规则可追踪。
3. 控制复杂度和训练轮次
可减少无效特征、限制树深、加强 L1/L2、使用 dropout 或在验证指标恶化前早停。每次只改变一组因素,保留对照,避免无法判断哪项措施有效。
4. 重新验证而不是宣告治愈
同一验证集反复调参也会被过拟合。重要模型需要嵌套交叉验证、时间外样本或后续生产真实标签;部署后还要监控输入、输出和业务结果。
常见误区
- 训练和验证都差时盲目加强正则化,实际会加重欠拟合。
- 把一次随机切分的高分当稳定结论,不看不同折或不同时间段波动。
- 先用测试集选模型,再把测试分数写成独立证据。
- 把数据增强等同于真实新数据;增强规则不合理也会改变标签语义。
发布前检查表
- 切分规则、样本 ID、随机种子和特征流水线已冻结。
- 训练、验证、测试指标及差距同时保存。
- 没有使用未来信息、重复主体或全量预处理造成泄漏。
- 修复动作可单独回滚,最佳检查点可恢复。
- 结论写明任务、数据日期和不适用范围。
一手资料
- Google ML:过拟合(核验于 2026-09-12)
- Google ML:模型复杂度(核验于 2026-09-12)
- Google ML:L2 与早停(核验于 2026-09-12)
- scikit-learn:交叉验证(核验于 2026-09-12)
- scikit-learn:学习曲线(核验于 2026-09-12)