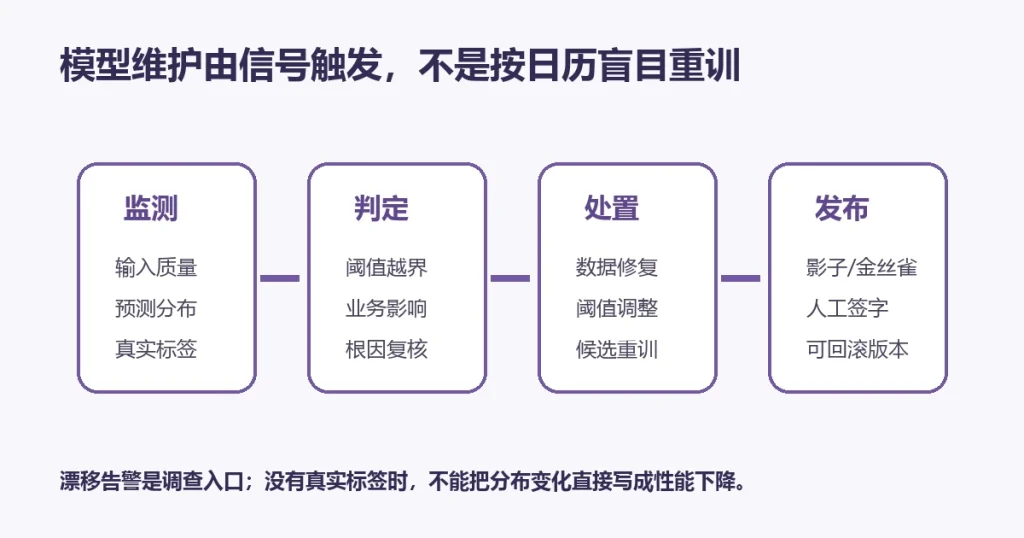
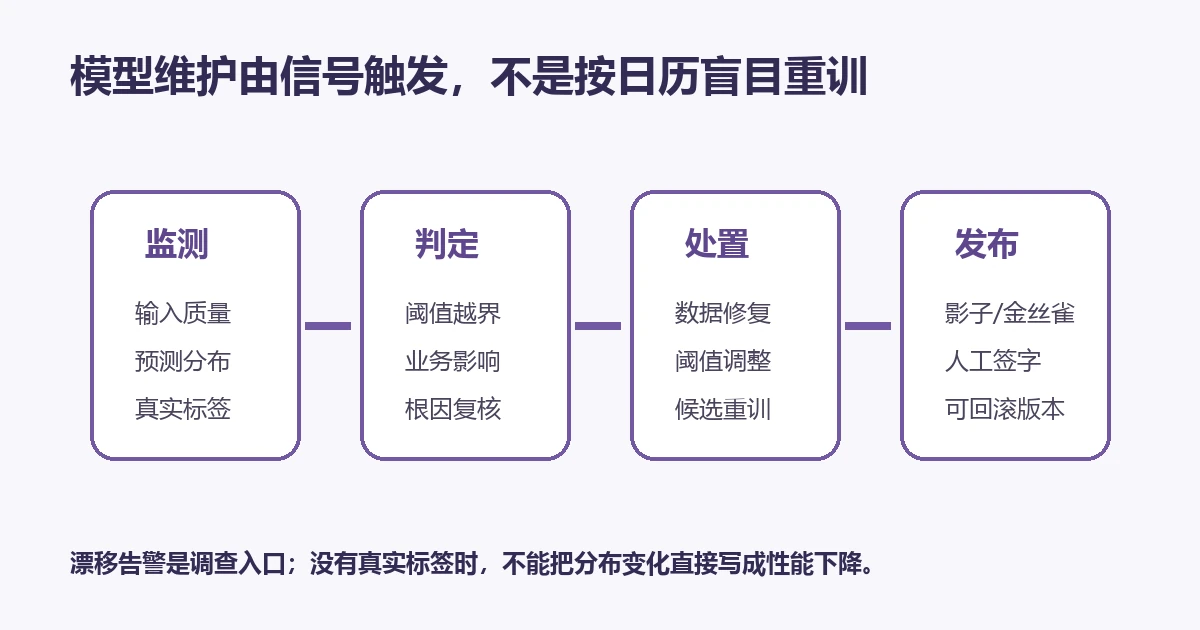
直接答案:AI 模型需要持续维护,但不应因为“到了每月一号”就自动重训。维护包括数据质量、预测与真实结果、接口健康、安全和版本依赖的监测;当信号越界时先确认影响和根因,再决定修数据、调阈值、回滚或训练候选版本。
“定期维护”真正要定期做什么
- 每天或每批:检查输入缺失、类型、范围、延迟、错误率和异常流量。
- 按标签到达:计算准确率、召回率、MAE 等真实性能,记录标签延迟和抽样偏差。
- 按数据量:比较输入、预测和特征贡献分布;样本太少时延长窗口,避免噪声告警。
- 按版本或事件:依赖、特征流水线、政策、上游数据或攻击模式变化时启动专项复核。
- 按风险:高影响场景增加人工复核、申诉、偏差与安全测试,不能只看平均性能。
四类信号不能互相冒充
| 信号 | 能说明什么 | 不能直接说明什么 |
|---|---|---|
| 数据质量 | 缺失、类型错误、越界、格式变化 | 模型准确率一定下降 |
| 数据/预测漂移 | 生产分布与参考分布不同 | 变化必然有害或必须重训 |
| 真实标签性能 | 在已标注样本上的任务表现 | 未标注人群同样表现 |
| 服务指标 | 延迟、吞吐、错误、资源与可用性 | 输出内容正确、安全或公平 |
Azure 文档区分数据漂移、预测漂移、数据质量、特征归因漂移和带真实标签的模型性能。AWS 的模型质量流程也需要把推理结果与 Ground Truth 合并后比较。没有真实标签时,应写“发现分布变化,需调查”,不能直接写“准确率下降”。
从告警到上线的七步维护单
- 确认告警可重复。固定时间窗、样本量、参考集、指标和阈值,排除采集故障。
- 判断业务影响。定位受影响人群、错误类型、金额或安全等级,不只看总体平均。
- 追根因。检查上游字段、标签流程、特征代码、依赖版本、接口和攻击输入。
- 选择最小处置。数据管道错误先修管道;阈值错配先验证阈值;只有关系变化且有合格新数据时才考虑重训。
- 离线验收候选。复用冻结测试集,增加新失败样本,并与当前生产版本逐项比较。
- 影子或金丝雀发布。限制流量和权限,保留当前版本、特征契约与一键回滚。
- 关闭事件。记录原因、动作、验证、负责人、复查时间和未解决风险。
什么时候不应重训
采集器故障、标签迟到、上游字段改名、样本量不足、季节性变化或服务超时,都可能触发告警。此时立即重训会把坏数据固化进新模型。先恢复可信数据和对照基线;若当前版本仍满足业务门槛,可以继续观察而不是制造不必要的发布风险。
生成式 AI 还要增加哪些维护项
除传统指标外,应固定提示与任务集,跟踪事实支持、引用可达、拒答、越权工具调用、提示注入、敏感信息泄露和成本。模型供应商版本变化、系统提示、检索库和工具权限都可能改变结果;因此必须把“模型版本”扩展为完整运行配置。
最小回滚包
- 生产模型、代码、依赖、特征契约和配置的不可变版本。
- 参考数据、测试集、阈值、审批人和上线时间。
- 候选与当前版本逐项对比,不只保留汇总分数。
- 回滚触发条件、执行命令、数据兼容性和恢复验证。
- 事件结束后的复盘与下一次阈值调整依据。
一手资料
- Azure ML:生产模型性能监测(核验于 2026-09-12)
- Azure 架构中心:MLOps(核验于 2026-09-12)
- Azure Well-Architected:ML 架构(核验于 2026-09-12)
- AWS SageMaker:模型质量(核验于 2026-09-12)
- NIST AI RMF 1.0(核验于 2026-09-12)