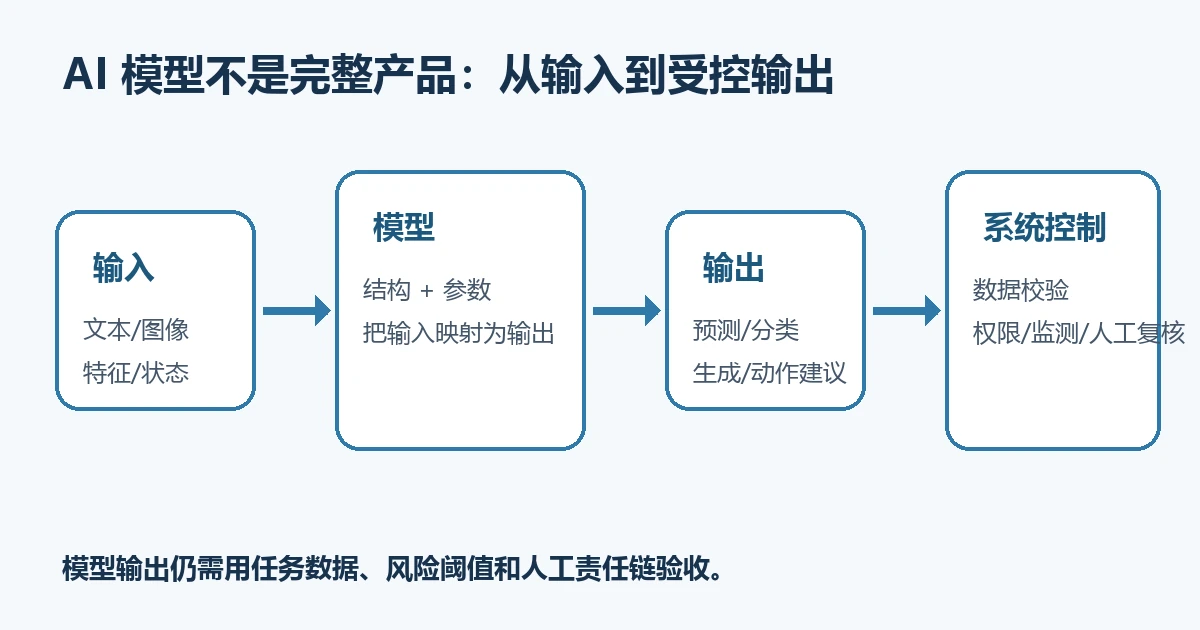
直接答案:AI 模型是接收一组输入,并用计算、统计或机器学习方法产生输出的组件。对机器学习模型而言,核心通常是结构与训练得到的参数。它不是数据集、提示词、业务流程或完整产品;真实系统还包括输入校验、检索、工具权限、人工复核、监测和回滚。
模型、算法、数据和系统分别是什么
| 对象 | 主要作用 | 不能替代什么 |
|---|---|---|
| 算法 | 规定怎样学习、搜索或更新参数 | 不等于训练后的具体模型 |
| 训练数据 | 提供样本、标签或反馈 | 不能代表所有未来输入 |
| AI 模型 | 用结构和参数把输入映射为输出 | 不包含完整业务责任与权限控制 |
| AI 系统 | 组合模型、数据管道、界面、工具、监测和人工流程 | 不能因使用模型就自动可信或合规 |
NIST 的术语把 AI 模型描述为信息系统中的组件:它实现 AI 技术,并从给定输入产生输出。这个定义的重要边界是“组件”。聊天产品可能在模型外加入系统提示、检索库、内容过滤、工具调用和账户权限;同一基础模型置于不同系统中,行为、风险和可用能力都可能不同。
机器学习模型怎样形成输出
- 定义任务。先明确输入、期望输出、错误成本和不适用场景。
- 准备数据。记录来源、许可、抽样范围、标签规则和时间边界。
- 选择结构与目标。线性模型、树、神经网络等结构表达能力不同;损失函数决定训练优化什么。
- 训练参数。算法根据样本更新权重、阈值或树结构。
- 独立评估。验证集用于选择,测试集用于最终检查;不能用训练分数冒充泛化能力。
- 推理与监测。上线后记录版本、输入质量、输出、延迟、失败与真实反馈。
常见模型类型按任务区分
- 分类与回归模型
- 输出类别、概率或数值,适合有明确标签和评价指标的任务。
- 聚类与表示模型
- 在缺少标签时寻找结构或生成向量;聚类结果仍需人工解释,不能自动当作真实人群类别。
- 生成模型
- 生成文本、图像、音频或其他序列。流畅输出不等于事实正确,必须设计来源、拒答和人工复核。
- 策略或控制模型
- 根据状态选择动作;若能调用外部工具,还要单独限制身份、权限、预算和可逆性。
选择模型前先回答六个问题
- 任务是否真的需要学习型模型,还是规则和检索更透明可靠?
- 输入和输出能否被清楚定义,真实标签何时取得?
- 错误由谁承担,哪些错误必须拒绝或转人工?
- 数据能否依法、按许可和目的使用,敏感字段怎样最小化?
- 延迟、成本、设备、地区和离线要求是什么?
- 怎样固定版本、回放样本、监测变化并回滚?
最小验收记录
至少保存模型名称与版本、结构或供应商、训练或来源说明、输入输出契约、评价数据、指标与阈值、已知限制、权限、负责人、上线时间和回滚版本。仅记录一个营销名称,无法重现或追责。
一手资料
- NIST:人工智能模型术语(核验于 2026-09-13)
- NIST SP 800-218A(核验于 2026-09-13)
- Google 机器学习术语表(核验于 2026-09-13)
- Google:机器学习简介(核验于 2026-09-13)
- NIST AI 风险管理框架(核验于 2026-09-13)