梯度消失指反向传播到较早层或较早时间步时,梯度相对后层持续变小,使这些参数难以从当前损失信号中有效更新。它不是“训练慢”或“损失不降”的唯一解释:冻结参数、断开计算图、数据问题和学习率设置也可能产生类似表象。排查应先量测每层梯度,再只改一个因素。
梯度消失是什么,不是什么?
在链式法则中,损失对早层参数的导数包含中间雅可比矩阵的连乘。当沿路径的收缩作用持续存在时,梯度可能衰减;网络深度、时间展开长度、权重谱、激活饱和和归一化位置都会影响结果。单说“Sigmoid 一定消失”也不严谨:它的导数上界为 0.25,但整个梯度还取决于权重和路径。Tanh 的导数上界为 1,不能把它写成总在 0 到 0.25 之间。PyTorch 自动微分机制解释了计算图与叶参数的梯度累积。
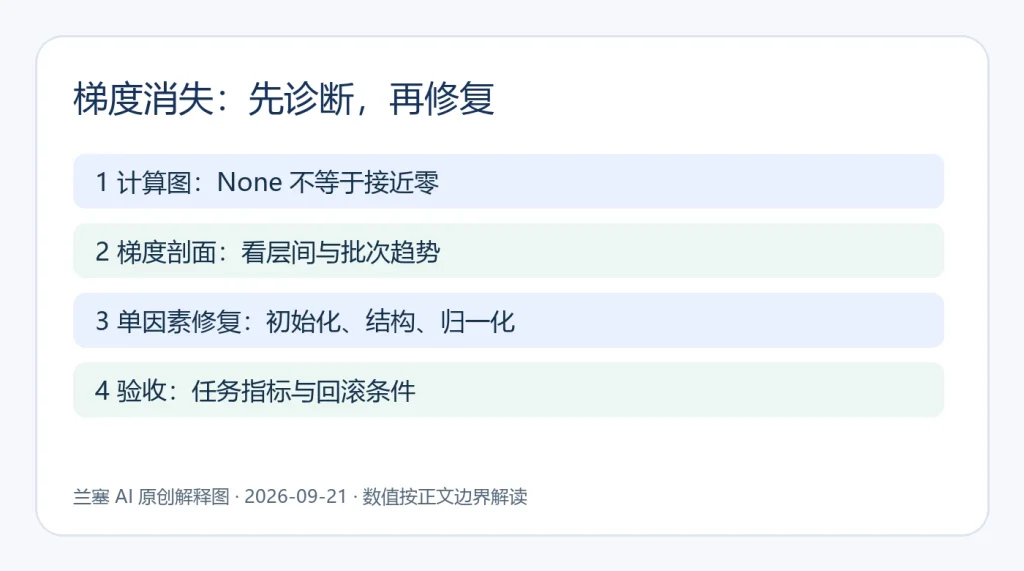
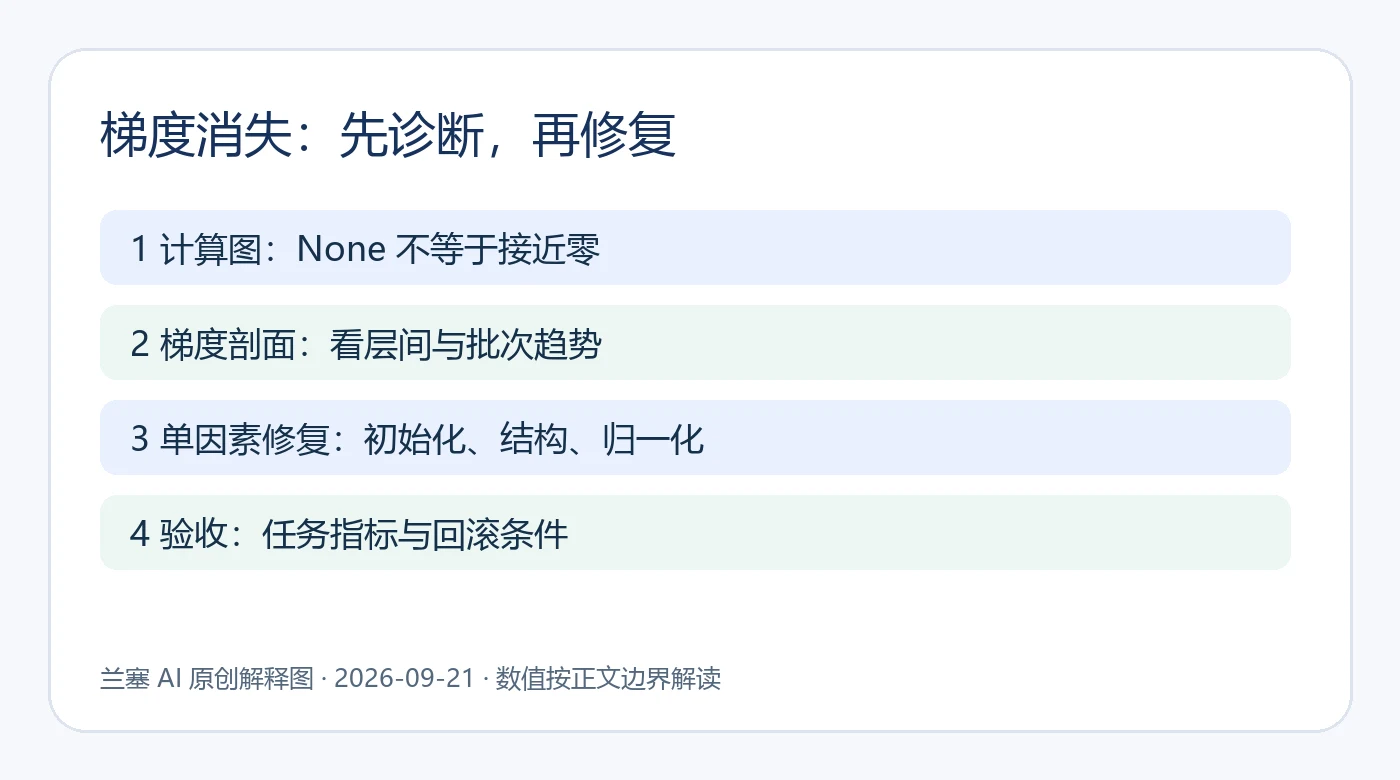
梯度为 None 与梯度数值接近零不是同一件事。前者可能表示未参与当前反向图、被冻结、在无梯度模式下计算,或尚未执行 backward();后者才需要进一步看数值尺度和层间趋势。损失平台也不能单独作证:标签错误、数据分布、优化器和饱和输出都可能造成平台。
如何做第一轮定位?
- 固定一个合法的小批次、随机种子、模型版本和损失函数;确认前向输出与标签形状正确。
- 调用
optimizer.zero_grad(set_to_none=True),执行前向和loss.backward();在optimizer.step()前记录各层参数梯度。 - 分开记录
None、非有限值、零值比例、平均绝对值和范数;同时保存参数范数与层次顺序。 - 用同一个批次重复,检查早层与末层的梯度比例及连续多个批次趋势。不存在通用的“低于某数就是消失”阈值。
- 检查
requires_grad、detach()、no_grad()、inference_mode()、损失到目标参数的计算路径,再考虑改架构。
PyTorch 官方梯度可视化教程使用钩子收集层输出的反向梯度并比较有无 BatchNorm 的网络;教程结果只适用于其示例设置,不等于所有网络加 BatchNorm 都更好。实际工程还应把参数梯度与激活梯度分开记录。eval() 切换模块行为,但不会像 no_grad() 那样自动关闭梯度记录;两者不可混为一谈。
最小可复核记录怎么写?
import torch

def gradient_report(model):
    rows = []
    for name, parameter in model.named_parameters():
        grad = parameter.grad
        if grad is None:
            rows.append((name, "None", None, None))
            continue
        values = grad.detach().float()
        rows.append((name, "finite" if torch.isfinite(values).all().item() else "nonfinite",
                     values.abs().mean().item(), torch.linalg.vector_norm(values).item()))
    return rows
请在 loss.backward() 之后、optimizer.step() 之前调用,并保存模型版本、批次哈希、种子、损失和上述记录。
这段代码只量测参数梯度;共享参数、稀疏梯度和混合精度训练需按具体框架调整。在混合精度训练中,还要区分缩放前后数值;不要用未还原的梯度与全精度基线直接比较。出现 NaN 或 Inf 时先处理非有限值和损失稳定性,而非把它称为梯度消失。
确定为梯度衰减后,按什么顺序修?
先修计算路径。如果梯度是 None,检查冻结、断图和模式设置。把这类错误留着再更换激活函数,无法恢复不存在的路径。确认损失真的依赖目标参数,并在同一批次观察修复后的梯度。
再修初始化与激活匹配。PyTorch 初始化文档提供 Xavier 与 Kaiming 方法,并说明增益与非线性函数的关系。对 ReLU 类层考虑与其相符的初始化;对 Sigmoid/Tanh 架构需结合目标输出范围和结构做实验。初始化改善的是起点,不能保证训练中始终稳定;改动后记录早期和后期梯度,而不仅看第一步。
最后考虑结构与归一化。残差路径可以提供较短的反向路径,但跳跃连接的维度、缩放和归一化顺序会改变效果。BatchNorm 对批量统计敏感,微批次、序列模型或推理分布变化时需谨慎;LayerNorm 按指定末尾维度计算统计,两者不是任意互换的药方。RNN 长期依赖可评估门控结构,同时记录序列长度和截断反向传播边界。LayerNorm 官方文档给出了它与 BatchNorm 的统计维度差别。
三类常见误修
- 对消失梯度直接裁剪。梯度裁剪主要限制过大的梯度范数;它不会把接近零的梯度变大。若记录显示爆炸或非有限值,再按 官方裁剪 API处理,并保留裁剪前范数。
- 只加大学习率。学习率改变参数更新尺度,但不能修复计算图断裂,也可能把后层推入不稳定区。比较相同批次、相同种子下的梯度和验证损失。
- 只看训练损失。需要同时看早层与末层梯度、权重实际更新量、验证集和任务指标;损失下降也可能掩盖早层未学习。
验收与回滚
保留修改前的模型、优化器状态和固定样本。每次只试一个变更:初始化、激活、残差或归一化。记录每层梯度分布、前若干步损失、验证任务指标与非有限值次数。如果早层梯度改善但验证指标恶化,不能宣布“已解决”;撤回该变更,寻找数据或目标函数原因。本文是可复用的诊断路径,没有声称对读者模型做过实测。部署还需要在目标模型和数据上复现。
延伸阅读:KV 缓存是推理阶段的中间状态,与这里的训练反向梯度是两个不同问题。