
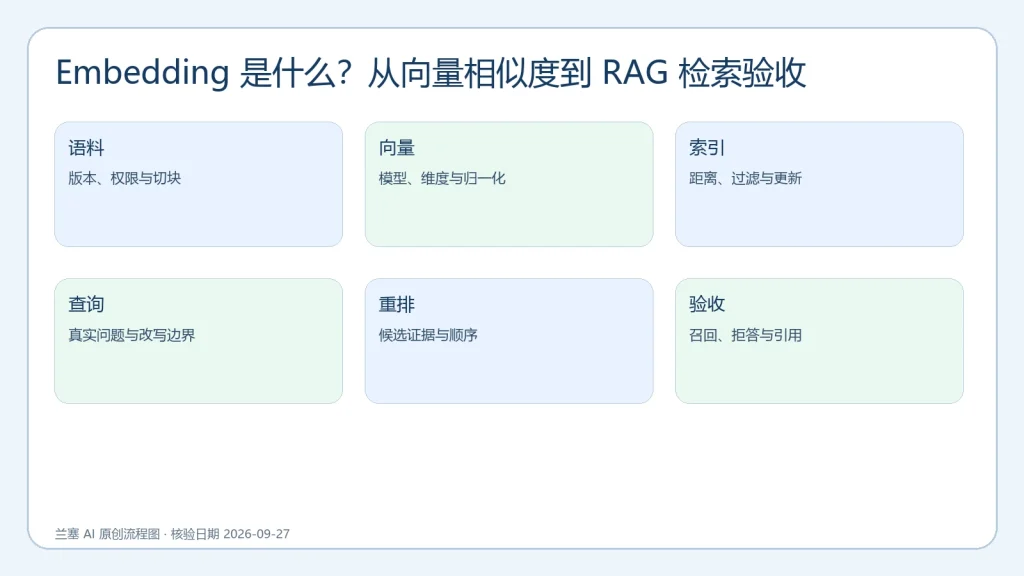
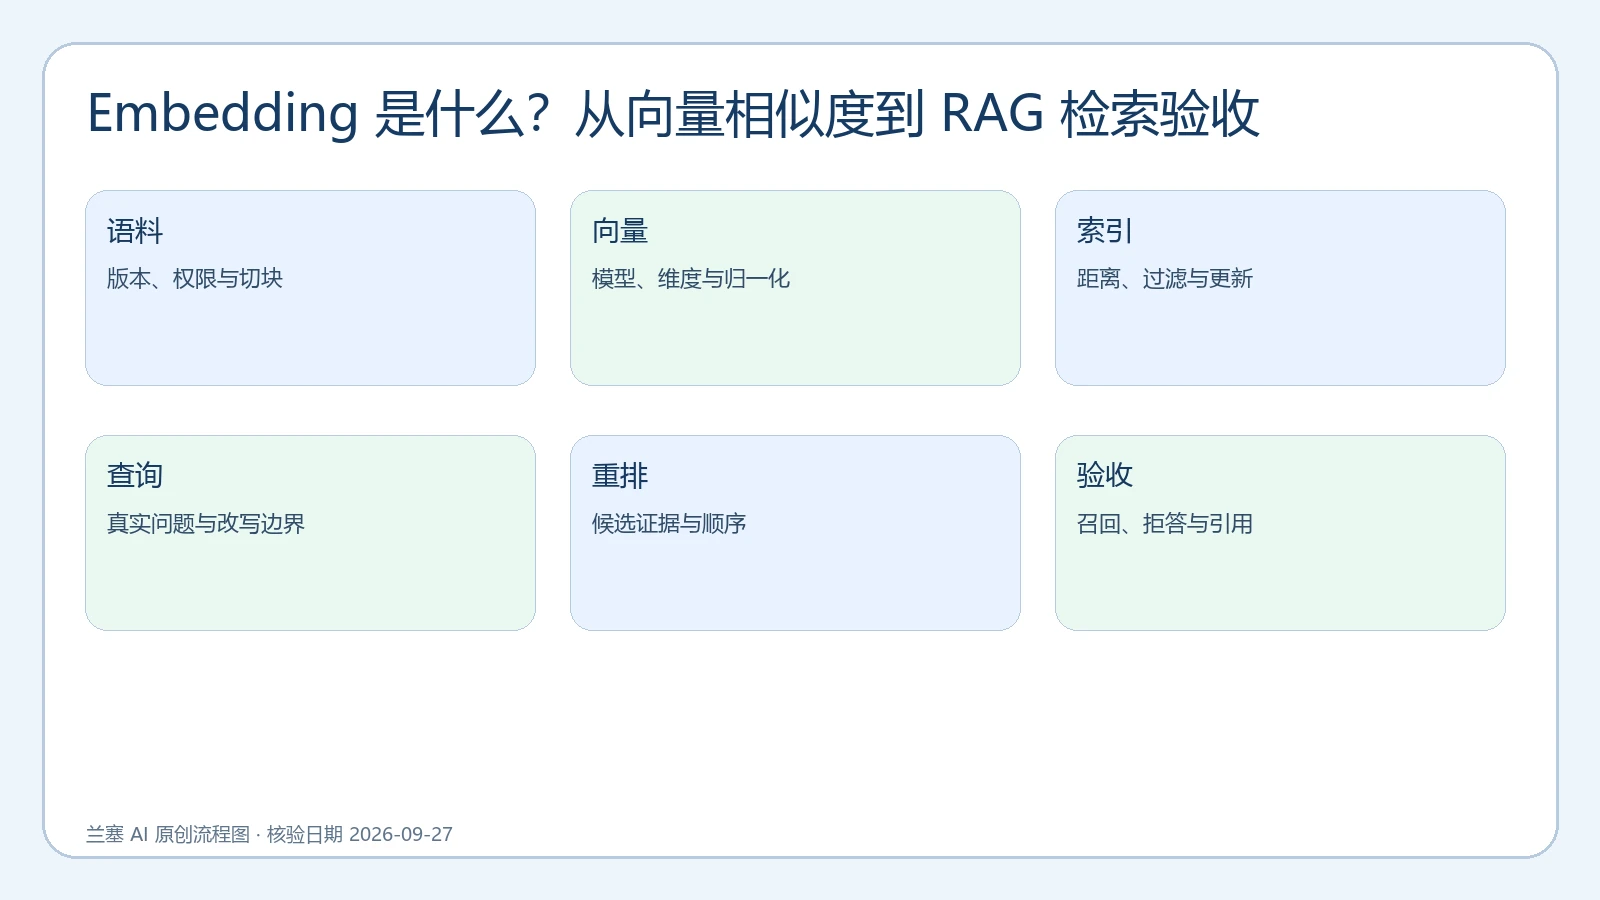
直接答案:解释 Embedding、余弦相似度、切块、索引、过滤和重排,并用小型检索夹具建立可复现的 RAG 召回验收。
本文于 2026-09-27 核验官方一手资料。所有接口、支持范围和默认行为在实施当天仍需重查;本站没有把公开文档整理写成生产实测。
直接定义
Embedding 是把文本、图片或其他对象映射成固定长度向量的模型输出,用于计算相似性、检索、聚类或分类。向量距离表达训练数据和模型学到的关系,不是事实数据库,也不保证相近内容对当前用户有权限或能直接回答问题。
不要混淆三类向量
词表中的 token embedding、模型内部上下文表示和面向检索的句子/文档 embedding 用途不同。不能把语言模型隐藏层随意平均就当作稳定检索服务,也不能根据维度大小判断效果。选型要核对模型卡、输入限制、语言与任务。
距离与归一化
余弦、内积和欧氏距离的排序关系取决于是否归一化。索引配置、向量生成和查询端必须使用一致约定。迁移模型后维度和分布会变化,旧向量通常不能与新查询向量混用;应建立双索引或完整重建并保留切换回滚。
切块决定可检索单元
过大切块会把多个主题混在一起,过小则丢失定义、条件和例外。按文档结构、任务与引用粒度选择切块,并保存文档 ID、版本、标题路径、更新时间和权限。重叠只是缓解边界问题,不应无限增加重复内容和成本。
过滤必须早于泄露
企业 RAG 不能先全库向量召回再在生成端隐藏无权结果。权限、租户、地区、时间和文档状态应进入检索过滤或隔离索引,并测试拒绝路径。日志也要避免记录无权文本。召回正确但权限错误仍是发布失败。
用真实问题验收
建立来自支持记录、站内搜索或业务流程的查询集,为每个查询标注可接受文档、拒答条件和时间边界。报告 Recall@k、MRR、错误权限结果、空结果和延迟;指标只能描述该集合,不能直接等同最终答案正确或用户满意。
混合检索与重排
向量检索擅长语义近似,关键词检索对编号、错误码、人名和精确短语更可靠。混合召回后可用重排模型排序,但要记录候选集合、重排模型与阈值。重排不能找回第一阶段没有召回的文档。
更新与删除
源文档变化时,要能定位受影响切块、重新生成向量并删除旧版本。删除账号或受限资料时同时处理对象存储、索引、缓存、评测集和备份策略。只删除数据库正文却保留向量和片段,可能继续暴露信息。
独立任务资产
配套 JSON 定义两条查询、相关文档、访问范围和待填写指标。它帮助团队在换模型或索引前后保持同一口径,但不包含真实向量、不运行第三方 API,也不证明任何模型效果。
Embedding 模型选型先看任务,不看榜单单分
区分对称语义相似、短查询到长文档、代码检索、多语言、图文跨模态和聚类。模型卡的平均分只描述其评测集合与设置;你的文档长度、中文术语、否定表达和权限过滤可能完全不同。先用小规模真实问题比较召回与错误,再考虑维度、延迟、部署方式、许可和数据发送边界。
查询与文档可能需要不同前缀
一些检索模型要求 query 与 passage 使用不同提示或任务前缀。遗漏前缀可能不报错,却改变向量分布与召回。把模板、大小写、清洗、语言和截断规则视为模型版本的一部分。离线建库和在线查询必须使用同一发布契约;变更任何预处理时重新生成候选索引并与旧基线对比。
截断会让关键信息消失
模型输入长度有限,长文档在向量化前可能被截断。保存每个切块的 token 数、截断标记和标题路径;重要条件、表头与例外不能只存在被截掉的末尾。对超长文档按结构分段,并测试跨段问题。返回结果时展示原文范围和文档版本,让人工能核对向量命中的实际证据。
近似索引要在速度和召回之间验收
HNSW、IVF 等索引用近似搜索换取规模与速度,参数会影响构建时间、内存、查询延迟和召回。先保留小规模精确检索作为参考,再在相同查询集比较近似索引的 Recall@k。不要只测平均延迟;报告高分位、空过滤结果和更新期间行为。索引压缩或量化也要检查关键小类是否更易丢失。
相似度阈值不是通用常数
不同模型、归一化、语料和查询类型产生不同分数分布。用已标注查询分别观察相关与不相关结果,选择阈值并保留灰区处理。阈值太高会造成无结果,太低会把弱相关片段送入生成。对于需要拒答的系统,把“没有足够证据”作为正常输出,不用大模型凭常识填补私有资料缺口。
RAG 答案质量要拆层定位
最终回答错误可能来自文档不存在、切块丢上下文、Embedding 未召回、过滤排除、重排错误、提示未使用证据或模型错误引用。回执要保存每层输入与候选 ID,才能定位。只评价最终回答会把检索和生成混在一起;只评价召回也不能证明答案忠实。两层都要有固定样本和独立指标。
模型迁移需要双写与可回滚
新模型可能改变维度、距离分布、语言能力和成本。先离线重建新索引,保持旧索引可读;对一小部分查询双路运行,比较召回、权限错误、延迟与空结果。切换时用版本化别名,不覆盖唯一索引。确认删除、增量更新和回滚都能工作后再扩大,不让在线请求混用新旧向量。
隐私和许可边界
调用托管 Embedding API 前识别文档与查询是否包含个人、商业或受限数据,核对地区、保留、训练、子处理方和删除条款。本地模型也要核对权重、代码与数据许可。向量并非天然匿名,仍可能泄露语义或被关联;访问控制、日志最小化、加密和生命周期策略同样适用。
发布前验收清单
- 任务、输入、版本、依赖和权限可追踪;
- 基线与候选使用同一测试集和指标;
- 边界、失败和拒绝路径已覆盖;
- 独立加载或重建可以复现;
- 回滚对象、负责人和触发条件明确。
官方来源与下一步
一手资料:Sentence Transformers Semantic Search、FAISS official wiki、OpenAI Embeddings Guide、Azure AI Search relevance。站内下一步:企业 RAG 权限治理、本地大模型配置与显存估算、AI 指标证据边界。
证明边界:本页的夹具只验证记录结构或本地最小流程,不证明真实业务质量、GPU 性能、搜索排名、用户效果或生产安全。





