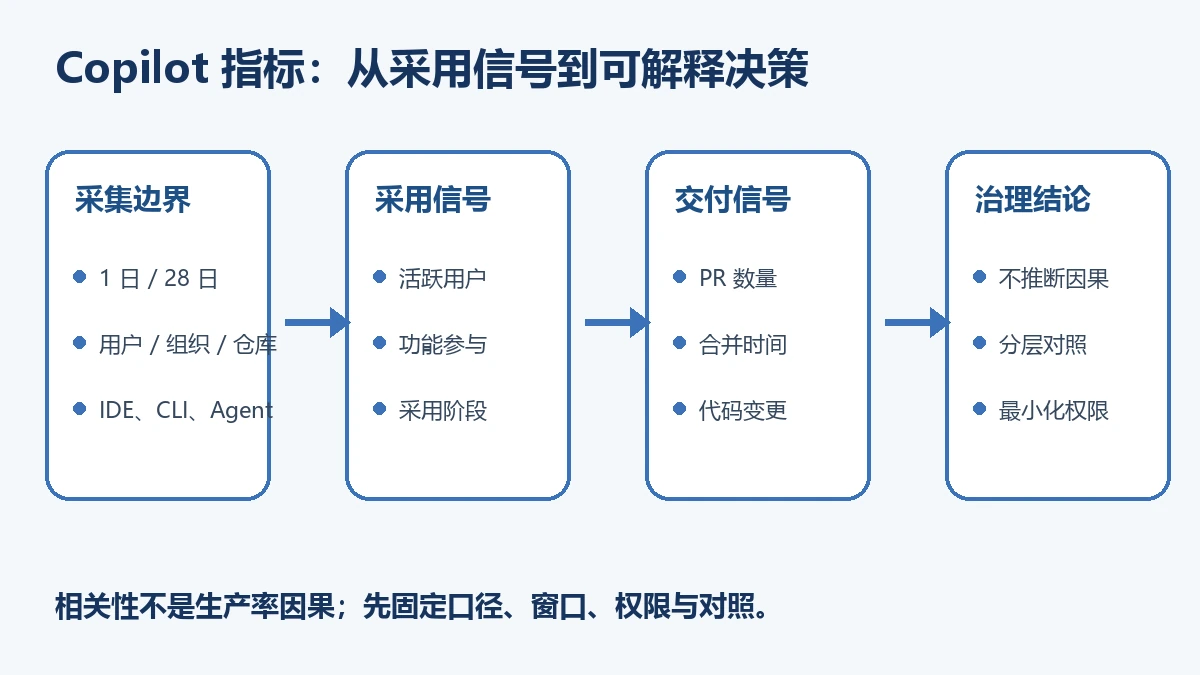
直接答案:GitHub Copilot usage metrics 适合回答“哪些席位在使用、使用了哪些表面、代码建议被接受多少、PR 流程发生了什么”,但不能单独证明“Copilot 让团队生产率提高了多少”。Impact dashboard 把采用阶段与 PR 产出放在一起比较,展示的是组织内相关性。要做采购、扩容或流程决策,仍需固定时间窗、团队和仓库范围,并结合缺陷、返工、变更规模、交付类型和人工调查。
Copilot usage metrics 能回答哪些问题
GitHub 当前把数据分为 dashboard、NDJSON 导出和 API 报告。企业或组织层可以看活跃用户、模型、语言、功能与代码活动;用户层报告包含登录名、AI credits、主动交互、生成与接受事件;仓库层报告围绕 PR 创建、评审和合并。不同报告形状不同,不能把一个范围里的字段直接当成另一个范围的分母。
| 问题 | 优先指标 | 不能直接推出 |
|---|---|---|
| 席位是否被使用 | 日活、月活、last_activity_at | 使用有效、代码质量改善 |
| 团队在用什么能力 | feature、model、language、chat mode | 某模型更准确或更省 |
| 建议是否进入代码 | generation、acceptance、LOC | 被接受的代码最终正确 |
| Agent 是否参与交付 | cloud agent、CLI、code review、PR activity | PR 全由 Agent 完成或节省了固定工时 |
| 采用是否更深入 | AI adoption phase | 阶段越高一定越好 |
AI adoption phase 到底怎样分
官方口径按最近 28 天内不同功能的参与信号把用户划入 No Cohort、Phase 1、Phase 2 或 Phase 3。关键条件是某个功能在至少两个不同日期出现符合资格的活动。只打开聊天、切换模式或复制回答,不一定形成代码补全或 agent edit 信号;因此“经常聊天”也可能仍显示为被动用户。
阶段是使用方式分类,不是员工绩效等级。团队有大量文档、研究、评审或低代码任务时,低阶段也可能符合岗位;反过来,高阶段只能说明使用了更多 Agent 表面,不能自动说明缺陷更少。
Impact dashboard 的 adoption multiplier 为什么不是因果
Impact dashboard 比较参与用户与被动用户的每人每月合并 PR 和合并时间。这个比较容易受到岗位、经验、仓库、任务难度、审查规范和团队成熟度影响。高产出的工程师可能更愿意采用 Copilot;更成熟的团队也可能同时拥有更好的工具推广与交付流程。指标显示同一组织内的关联,不是随机对照实验。
最低限度的分层办法
- 按团队、仓库类型和岗位分层,不把应用开发、数据、平台和文档团队直接混合。
- 固定至少一个发布周期,记录功能开关、模型和政策变化。
- 同时观察合并 PR、变更规模、返工、回滚、缺陷和人工审查时间。
- 保留未采用或晚采用的可比组;若没有,就只报告前后趋势,不写因果百分比。
- 访谈成员,区分学习成本、重复劳动减少和新增审查负担。
代码接受率应该怎样读
接受事件记录的是内置 apply、插入、终端插入或 Copy 等动作;一个提示可能产生多个代码块,一次接受也不代表所有建议进入最终分支。它更适合判断交互是否顺畅、哪些语言或表面被采用,不适合作为个人绩效或代码正确率。
如果接受率上升但回滚、缺陷或审查时间也上升,团队得到的可能只是更多草稿。相反,低接受率可能来自用户把 Copilot 用于解释、设计或测试建议。应把接受率与具体任务、代码评审和最终交付结果连接。
数据缺口和口径变化怎么处理
GitHub 文档说明部分活跃用户来自服务端遥测,而 IDE、功能、模型和语言等细分可能仍缺失。第三方 IDE 的遥测也可能不完整;部分预览功能不会全部进入 activity report。遇到总活跃增长而细分未同步时,应标注“未归因”,不能把差额分配给某个团队或功能。
每次导出要保存报告类型、范围、开始与结束日期、生成时间、政策状态和字段版本。官方字段处于预览时,历史仪表板应保留原始文件与转换脚本,避免文档更新后回溯重算却没有口径记录。
权限、隐私与员工关系边界
- 只给需要的人 View Copilot Metrics 等最小权限,不把用户级导出广泛共享。
- 向员工说明采集目的、字段、保存期限、访问人和申诉/纠错渠道。
- 团队级分析优先于个人排名;小团队或可识别切片应合并或隐藏。
- 不要把提示词、源代码或 Agent 会话日志与 usage metrics 混成一个无限期数据湖。
- 企业政策、内容排除和功能开关影响可用表面,比较前必须记录。
一个可执行的 30 天评估设计
- 第 0 天:定义两个真实交付任务、质量门槛和停止条件,锁定团队、仓库与指标。
- 第 1 周:只看席位激活、访问问题和权限,不急于评价生产率。
- 第 2 周:观察功能参与、接受动作、人工审查和失败类型。
- 第 3 周:按可比仓库对照 PR 周期、返工、回滚与缺陷。
- 第 4 周:结合访谈和成本,决定保留、扩大、限制或停止;记录无法解释的缺口。
一手资料
- GitHub:Copilot usage metrics 字段(核验于 2026-09-18)
- GitHub:Copilot usage metrics 使用说明(核验于 2026-09-18)
- GitHub:Metrics data properties(核验于 2026-09-18)
- GitHub:企业与组织 Copilot policies(核验于 2026-09-18)
- GitHub:Copilot billing and usage(核验于 2026-09-18)