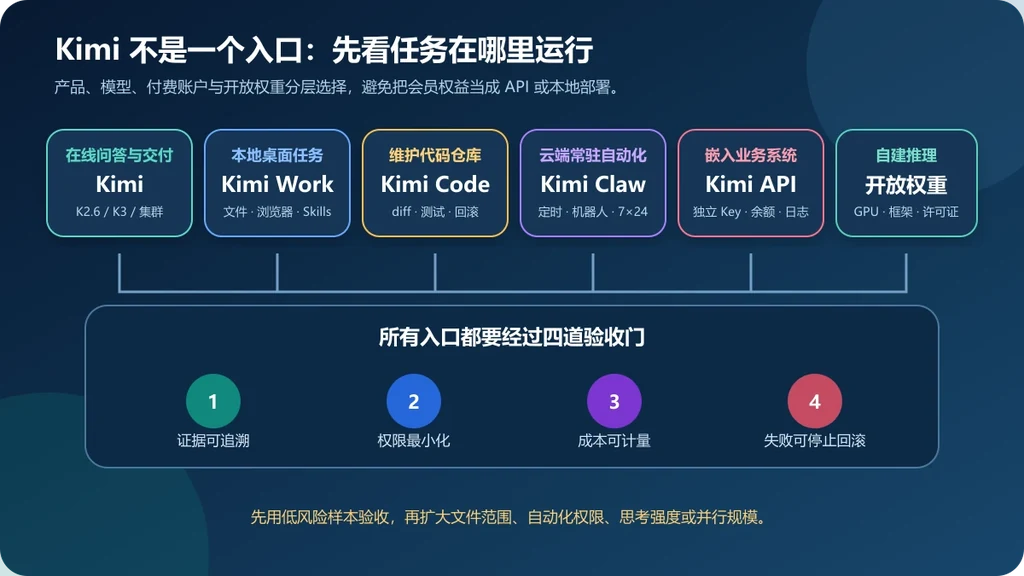
一句话答案:Kimi 现在是一套覆盖在线问答、复杂 Agent、本地桌面自动化、编程、云端常驻自动化、API 与开放权重的产品体系,而不是一个固定模型。截至 2026 年 10 月 6 日,日常快速问答优先选 K2.6,复杂对话、可编辑文档和多步骤任务选 K3,海量搜索与批处理选 K3 集群;需要操作本地文件用 Kimi Work,维护代码库用 Kimi Code,7×24 云端自动化用 Kimi Claw,嵌入业务系统则使用独立计费的 Kimi API。
Kimi 到底是产品、模型,还是一家公司?
Moonshot AI(月之暗面)是研发和运营主体,Kimi 是面向用户与开发者的产品品牌,K2.6、K3 等是模型名称。同一账号里看到的网页按钮、会员额度、Agent 工具,不等于开放平台的 API 参数;下载到本地的权重也不等于获得网页端的搜索、插件、PPT 或文件工作流。
Kimi 官方产品对比把当前入口分为 Kimi 网页/App、Kimi Work、Kimi Code 与 Kimi Claw;官方模型选择说明则把在线模型分为 K2.6、K3、K3 集群三档。开发者还可以使用Kimi 开放平台 API,或从Kimi K3 官方仓库获取开放权重。
| 层级 | 代表名称 | 你实际得到什么 | 最容易混淆的边界 |
|---|---|---|---|
| 公司/研发主体 | Moonshot AI / 月之暗面 | 模型研发、产品和服务运营 | 公司资料不等于某个产品当前功能 |
| 用户产品 | Kimi、Kimi Work、Kimi Code、Kimi Claw | 不同设备、权限和工作流入口 | 产品会员不等于开放平台余额 |
| 在线模型/模式 | K2.6、K3、K3 集群 | 速度、推理强度、上下文和并行规模 | 界面模型名不等于固定 API 请求参数 |
| 开发接口 | kimi-k3、kimi-k2.6 |
可记录、回归和集成的云端 API | API 不自动带入网页端插件、PPT和深度研究 |
| 开放权重 | Kimi K3、Kimi K2.6 等 | 自行下载、部署与适配的模型文件 | 权重可下载不等于普通电脑可运行 |
Kimi、Kimi Work、Kimi Code、Kimi Claw 与 API 怎么选?
先判断任务运行在哪里、需要什么权限、谁承担失败责任,再看模型版本。只是问答或生成一次性交付物,网页/App 通常足够;要读写本机文件和跨桌面应用,才需要 Kimi Work;要持续维护仓库,使用 Kimi Code;要让自动化长期驻留云端,使用 Kimi Claw;只有需要把能力嵌入自己产品并保存请求、用量和错误日志时,才选择 API。
| 入口 | 最适合 | 运行位置与权限 | 验收重点 |
|---|---|---|---|
| Kimi 网页/App | 问答、搜索、写作、文档/PPT/表格与一次性 Agent 任务 | 云端;上传文件和插件按当前账号授权 | 来源、事实、格式和额度消耗 |
| Kimi Work | 本地文件整理、跨桌面应用、浏览器操作和长交付物 | Windows 10+ 或 Apple 芯片 Mac;可接触本地文件和命令 | 工作目录、授权级别、修改清单与回滚 |
| Kimi Code | 阅读、修改和测试真实代码库 | CLI / VS Code;可执行命令和修改仓库 | diff、测试、密钥隔离和分支回退 |
| Kimi Claw | 7×24 云端自动化、定时任务和消息机器人 | 云端常驻;可连接飞书、微信等入口 | 触发条件、权限、重复执行与停止开关 |
| Kimi API | 嵌入产品、批量调用、结构化输出和可观测服务 | 你的服务端调用开放平台;独立 Key 和余额 | 模型 ID、schema、限速、成本、日志和降级 |
| 开放权重 | 研究、自建推理和合规隔离环境 | 自有或托管 GPU 集群 | 许可证、硬件、部署版本、性能与安全运维 |
Kimi Work 官方说明明确它是面向知识工作者的本地 Agent,支持本地文件、WebBridge、Skills、插件、定时任务和 Agent 集群;它仍处于 Beta 高频迭代阶段。高权限模式不应作为默认值:先限定工作目录并使用逐次批准,确认修改范围、备份与恢复路径后,再考虑扩大自动执行权限。
K2.5、K2.6、K2.7 Code 与 K3 有什么区别?
Kimi K2.5 官方仓库将它描述为原生多模态 Agent 模型,支持思考/非思考、图像/视频和工具任务。随后发布的 K2.6 延续 K2 家族并强化代码和长程 Agent;K2.7 Code 是代码专项变体。7 月 16 日发布的 K3 则成为当前旗舰,官方写明 2.8 万亿总参数、原生视觉、最高 1M token 上下文,并面向长程编程、知识工作与推理。版本号只代表产品演进,迁移仍要按具体模型 ID、接口和真值集验证。
| 版本 | 官方定位 | 当前选择建议 | 必须重新验证 |
|---|---|---|---|
| K2.5 | 原生多模态与 Agent,提供思考/非思考模式 | 复现实验或维护已锁定的 K2.5 系统 | revision、推理引擎、模板、工具消息和视频支持范围 |
| K2.6 | 通用多模态与 Agent 模型;API 最高 256K 上下文 | 速度或成本敏感任务,以及现有 K2.6 集成 | 思考模式与 tool_choice、reasoning_content、内置搜索兼容性 |
| K2.7 Code | 基于 K2.6 的代码专项 Agent 权重 | 长程软件工程候选,与 K2.6 在同一仓库任务集上对照 | 非代码任务退化、模板、服务框架、许可证和资源成本 |
| K3 | 旗舰模型;原生视觉、始终思考、最高 1M 上下文 | 新的复杂 Agent、知识工作、视觉与长程编程候选 | 产品额度、API 价格、effort、完整权重和部署条件 |
K3 API 始终开启思考,支持顶层 reasoning_effort 的 low、high、max 三档,默认 max;多轮与工具调用时必须保留完整 assistant message。K2.6 的思考开关与工具兼容规则不同,生产环境不能只把模型 ID 从旧值替换为 kimi-k3。详细选择、价格与迁移检查见站内的K3、K2.6 与 K3 Cluster 对比。
“200 万字”“256K 上下文”和“10 万汉字”为什么会同时出现?
这些数字来自不同时间、不同计量单位和不同产品模式。旧版 Kimi 曾以汉字口径宣传长文本;K2.6 与产品 Chat/Agent 有各自口径;K3 官方写明最高 1M token,但产品帮助页同时把最高窗口与会员权益关联。token 与汉字没有固定一比一关系,文件解析、图片 OCR、系统提示、工具结果、对话历史、推理和模型输出都可能占用窗口。
因此,长文档验收不能只看“上传成功”。建议为每个文件记录页数、字节、解析后字符/token、页码或段落 ID,并在开头、中间和结尾各埋入可核对问题。若模型答不出中间证据,应先缩小输入或建立检索流程,而不是宣称模型“不会中间遗忘”。需要把大量私有资料接入稳定问答时,可参考站内的Haystack RAG 与检索评测指南。
| 检查项 | 最低记录 | 失败信号 | 修复方向 |
|---|---|---|---|
| 输入身份 | 文件名、哈希、页数、解析时间 | 拿错版本或重复文件 | 先去重并锁定快照 |
| 解析覆盖 | 每页字符数、表格/图片/OCR状态 | 空白页、乱码、表格列错位 | 分类型解析并保存原页区域 |
| 证据召回 | 头/中/尾问题与页码答案 | 只会总结开头、引用错页 | 分块、检索、缩短历史 |
| 字段正确 | 逐字段真值与允许误差 | 数字、日期、主体被补全 | 规则校验、双模型或人工复核 |
| 引用可达 | URL、标题、日期、原文片段位置 | 链接与结论无关或来源过期 | 回到一手来源逐条打开 |
| 可复现 | 模式、模型、提示、参数、日期 | 同任务无法解释地漂移 | 固定 API 模型与回归集 |
Kimi 会员、Kimi Code、API 与本地部署怎么计费?
这些路线的计费账户和成本单位不同,不能只比较一个月费。截至 2026 年 10 月 6 日,官方说明显示网页/App 的 K2.6、K3、K3 集群均按会员额度计;Kimi 会员功能共享账号额度池,Kimi Code 另有自身限制。开放平台 API 是独立按量计费系统,会员额度、Kimi Code 权益、API 余额和 API Key 不互通。
| 路线 | 主要成本单位 | 是否与其他产品互通 | 采购前必须核对 |
|---|---|---|---|
| Kimi 会员 | 订阅档位、共享额度与思考强度 | 覆盖网页/App及部分 Work 能力;不转成 API 余额 | 当前套餐、剩余额度、模型和单次上下文权益 |
| Kimi Code | 独立计划或会员内的编程权益与周期限制 | 与开放平台 Key、余额不互通 | 模型、周期限额、仓库权限和命令批准 |
| Kimi API | 缓存命中输入、未命中输入、输出 token 与附加工具 | 中国站与国际站的账号、余额和 Key 也相互隔离 | 区域端点、GET /v1/models、限速等级和价格页日期 |
| 开放权重 | 下载、存储、GPU、网络、推理框架和运维 | 不包含官方网页、插件或 API 服务 | 许可证、硬件拓扑、部署版本、监控和故障恢复 |
Kimi K3 官方发布页列出的国际 API 启动价为缓存命中输入 0.30 美元/百万 token、未命中输入 3 美元/百万 token、输出 15 美元/百万 token;这不是中国开放平台的长期人民币报价。中国站应以当前 API 计费说明及登录后的价格页为准,联网搜索还会产生独立调用费用。
真实成本应按“完成一个通过验收的任务”计算:模型费用 + 工具费用 + 重试 + 人工复核 + 失败回滚。长上下文如果重复发送相同材料,应评估上下文缓存;输出过长时先设置预算和停止条件,而不是只追求最大窗口。
开发者怎样建立最小可复现 API 调用?
官方 Chat Completions 文档使用与 OpenAI SDK 兼容的接口。下面的 canary 只发送低风险文本,验证模型 ID、响应结构和用量字段;它不是性能测试,也不会替你验证联网搜索或工具调用。密钥只能放在环境变量中,不能写入 WordPress、截图、日志或前端 JavaScript。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.cn/v1",
)

response = client.chat.completions.create(
    model="kimi-k3",
    reasoning_effort="low",
    messages=[
        {"role": "system", "content": "只回答输入中明确给出的事实。"},
        {"role": "user", "content": "资料:项目代号为蓝鲸,截止日期为7月31日。请返回JSON。"},
    ],
    max_completion_tokens=128,
)

print(response.model)
print(response.choices[0].message.content)
print(response.usage)
验收时不要只看是否返回 200。应检查 JSON 是否可解析、字段是否来自输入、模型名是否符合预期、token 用量是否出现、错误是否能安全重试。加入工具后,再分别测试超时、重复调用、越权参数、工具失败与幂等性。若需要把检索和生成拆成可审计流水线,可继续阅读RAG Pipeline 生产验收;若在本地、云端或混合部署间选择,可参考大模型部署决策指南。
隐私、记忆与开放权重许可证有哪些边界?
记忆空间说明表示,用户可查看、关闭或删除记忆,且“记忆”本身不用于模型训练;这句话不能自动外推为所有聊天、上传文件、Agent 工作区和 API 数据都遵循完全相同政策。处理身份证件、健康、合同、未公开代码或客户数据前,应重新阅读当前隐私政策、企业协议和对应产品的数据条款,并做最小化、脱敏和授权。
删除也要区分对象:删除记忆、删除某段对话、删除 Agent 工作区和注销账号不是同一操作。对组织数据,不能把个人界面里的“删除成功”当作合规销毁证明;应保存数据清单、处理者、保留期限、备份与审计要求。
开放权重方面,K2.6 与 K2.7 Code 模型卡标注 Modified MIT,并包含第三方声明;K3 使用单独的Kimi K3 License,不能沿用 K2 系列许可证。该许可证允许使用、修改、部署和再分发,但对年收入超过 2000 万美元的 Model-as-a-Service 经营者设置单独协议要求,并对月活超过 1 亿或月收入超过 2000 万美元的商业产品设置显著展示“Kimi K3”的条件;内部使用及通过官方产品或认证推理伙伴访问另有例外。团队应由法务按完整原文判断自身场景,并保存具体 revision、LICENSE、第三方声明和权重哈希;“开放权重”不等于没有商标、输出责任、第三方组件或所在地法律限制。不了解量化和权重格式时,可先阅读站内的模型量化说明与Hugging Face 平台指南。
怎样验证 Kimi 的搜索、文档与 Agent 结果?
- 定义完成标准:写清交付格式、必备字段、事实截止日期、允许误差和禁止动作。
- 建立小型真值集:选 10–30 个能人工确认的代表样本,包含正常、边界、反例和敏感输入。
- 保存输入证据:文件哈希、提示词、模式、模型、套餐、工具、参数与执行时间必须可追溯。
- 逐字段核验:把回答拆成事实、计算、引用、推断和行动;推断不得伪装成来源事实。
- 测试失败路径:断网、工具超时、文件解析失败、上下文过长、额度耗尽和人工中断都要有返回状态。
- 受控扩大:先只读,再沙箱写入,再人工审批,最后才允许低风险自动化;持续监控质量与成本。
联网回答带链接也不代表结论已经核实。至少打开关键来源,核对主体、日期、统计口径和原文是否支持结论。站内的Perplexity 引用核验方法同样适用于 Kimi 搜索结果:引用是线索,不是证明。

常见故障如何定位?
| 症状 | 先检查 | 常见原因 | 处理 |
|---|---|---|---|
| 长文档只回答前几页 | 解析页数、token、历史与输出预算 | 窗口被系统提示/历史占用或中间证据未召回 | 分块、页码索引、检索和头中尾探针 |
| Agent 卡住或一直执行 | 任务进度、工具日志、额度与停止按钮 | 子任务过大、工具失败或后台仍在运行 | 按官方建议拆成 2–3 阶段;不要盲目重复提交 |
| API 工具调用报错 | 模型、effort、tool_choice、完整 assistant message | 把 K2.6 的思考开关和工具规则直接套到 K3 | 回到当前 K3 快速开始,建立单工具 canary |
| 网页与 API 回答不同 | 模型 ID、模式、搜索、系统提示与历史 | 两个入口不是同一执行链 | 不要比较品牌名;固定 API 请求做回归 |
| 本地权重无法装入 | 总参数、量化、GPU/内存、推理引擎 | 把 32B 激活参数误当作 32B 总权重 | 按官方部署矩阵估算完整权重与 KV cache |
| 引用存在但结论错误 | 原文、发布日期、主体和口径 | 搜索摘要误读、来源冲突或模型补全 | 优先一手来源,保留不确定与人工复核 |
这次更新依据了哪些官方变化?
| 复核项 | 2026-10-06 结论 | 官方依据 |
|---|---|---|
| 在线模型 | K2.6、K3、K3 集群;思考强度为标准/进阶/极致 | 模型与模式选择 |
| 产品入口 | Kimi、Kimi Work、Kimi Code、Kimi Claw 分工明确 | 产品对比 |
| 桌面 Agent | Kimi Work 面向 Windows 与 Apple 芯片 Mac,仍处 Beta 迭代 | Kimi Work 介绍 |
| API | kimi-k3最高1M token;会员与 API 计费不互通 |
API 概览 |
| 开放权重 | K3 完整权重已发布;本站未声称完成部署实测 | Kimi K3 仓库 |
复核边界:价格、会员额度、客户端版本、模型列表、区域端点与限制属于强时效信息。本文记录的是 2026 年 10 月 6 日公开页面状态;实际付费或上线前,应重新查看官方页面和账号控制台。
常见问题
Kimi 现在还是“长文本助手”吗?
长文本仍是能力之一,但 Kimi 已覆盖在线问答、K3 Agent、K3 集群、Kimi Work、本地桌面自动化、Kimi Code、Kimi Claw、API 与开放权重。只用“长文本助手”描述它会遗漏当前最重要的产品边界。
K2.6、K3 和 K3 集群怎么选?
快速问答和节省额度优先 K2.6;复杂对话、可编辑文档和多步骤任务优先 K3;海量搜索、批量处理和可以安全拆分的大任务再考虑 K3 集群。K3 集群不是默认更好,它通常意味着更多额度、工具调用与复核工作。
Kimi Work 与网页 Kimi 有什么区别?
网页 Kimi 主要在云端完成对话和交付;Kimi Work 是桌面端本地 Agent,可读写授权目录、调用浏览器和本机工具。因为权限更高,使用前要限定目录、备份文件并确认命令批准方式。
Kimi 会员能直接抵扣 API 费用吗?
不能。官方说明将 Kimi 会员、Kimi Code 与开放平台 API 视为独立产品,权益、余额和 API Key 不互通;中国站与国际站的开放平台账号和 Key 也应按区域分别核对。
Kimi 一次能处理多少内容?
不要把旧“汉字数”宣传当成所有入口的保证。官方当前写明 K2.6 单轮约 128K token,K3 最高 1M token且与会员权益有关;API还要把输入、输出、系统提示、工具结果和历史消息一起计入上下文。
K3 开放权重可以在普通电脑运行吗?
“可以下载”不等于“普通电脑可运行”。K3 官方模型表列出 2.8T 总参数、104B 激活参数和 MXFP4 权重,完整文件规模约 1.56TB;实际部署还需要匹配的推理框架、多卡硬件、存储、网络与运维能力。
Kimi 的回答带来源就可以直接采用吗?
不可以。引用链接只证明系统给出了来源入口,不证明网页与结论一致,也不保证来源时效和权威性。仍需打开原文,核对发布日期、适用条件、原句和结论边界。
公司内部文件可以直接交给 Kimi Work 或 API 吗?
先依据数据分级、合同、隐私政策和组织授权判断。最小化并脱敏输入,禁止上传密码、密钥和无授权个人信息;高风险数据优先使用经过批准的企业/API/私有环境,并保留删除、审计和撤销流程。