直接答案:用一个可复现 CPU 训练夹具理解张量、自动微分、训练/评估模式、state_dict、断点恢复与结果验收。
本文于 2026-09-27 核验官方一手资料。所有接口、支持范围和默认行为在实施当天仍需重查;本站没有把公开文档整理写成生产实测。
先建立最小闭环
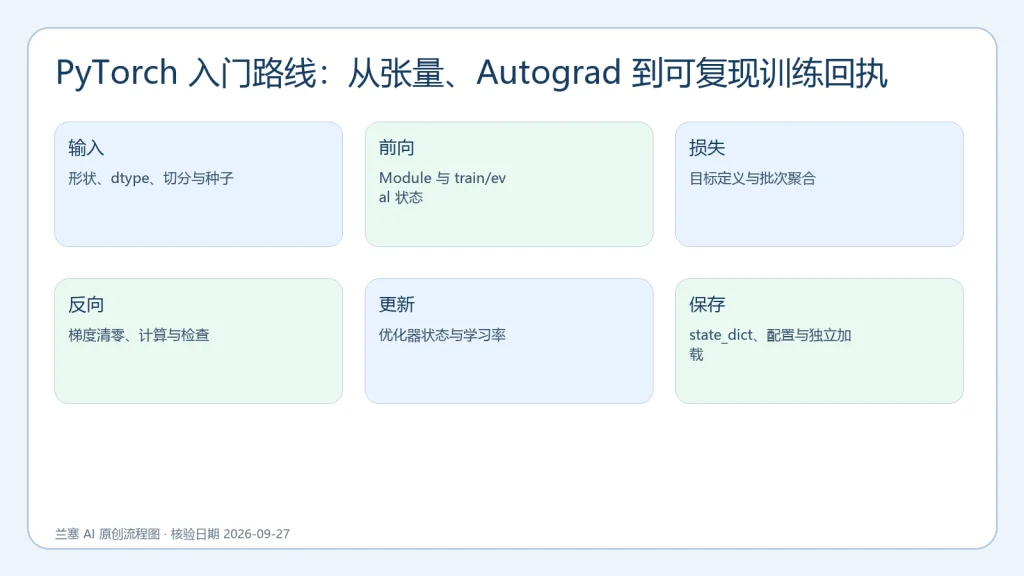
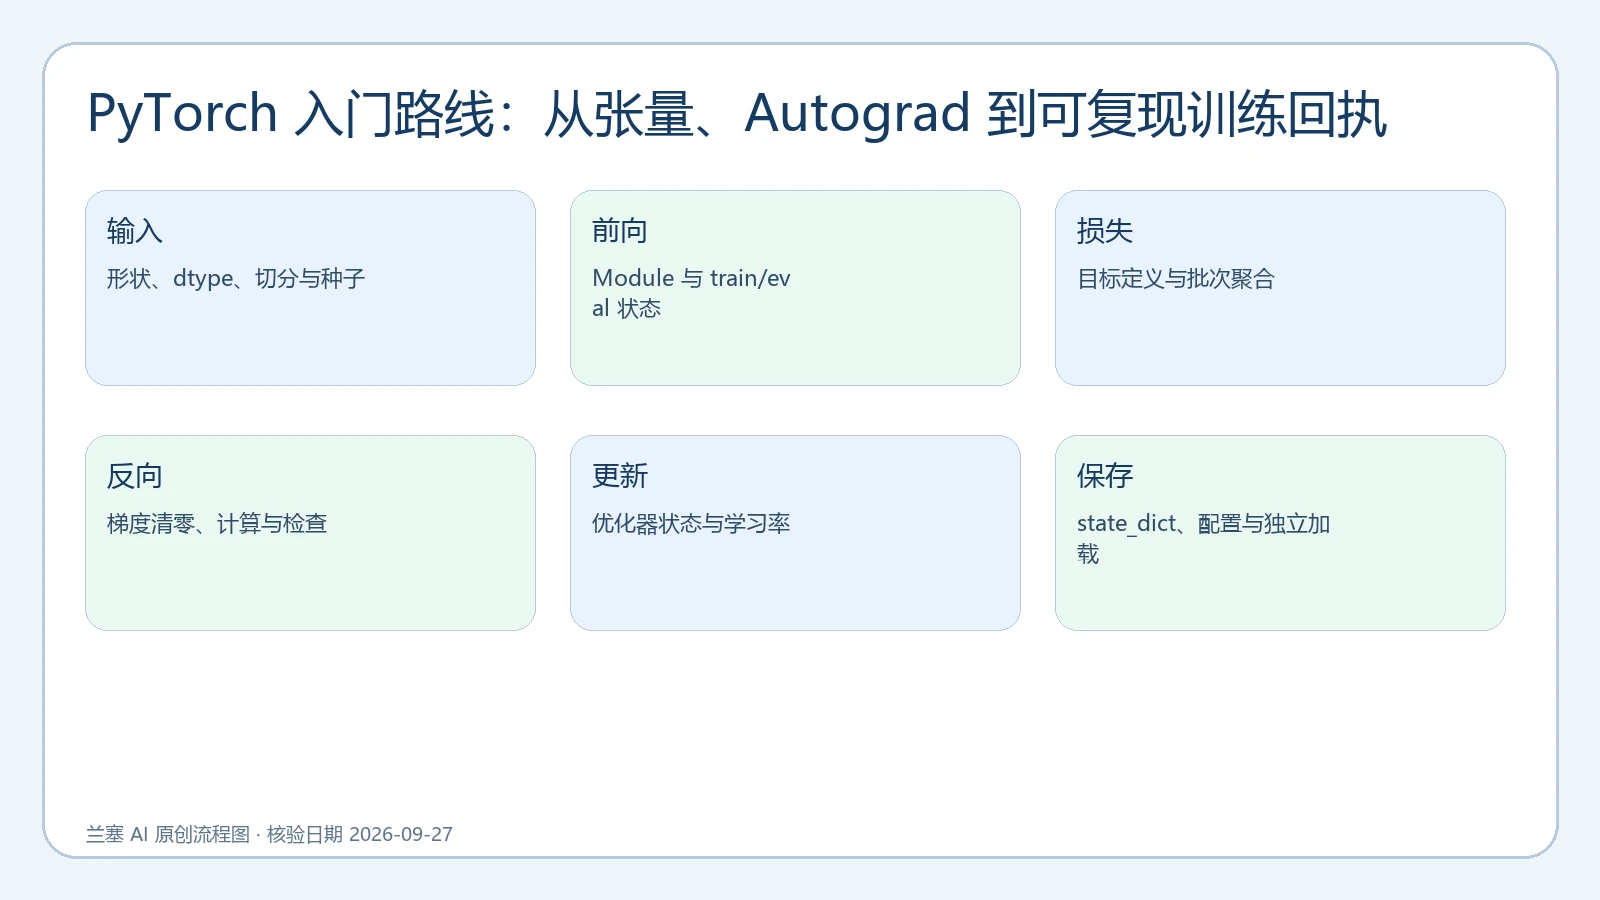
PyTorch 入门最容易卡在把 API 名称背熟,却没有形成数据到回执的闭环。先用 CPU 和很小的固定数据跑通张量形状、前向、损失、清梯度、反向、更新、评估与保存;只有这个闭环可重复,再引入 GPU、复杂模型和多进程。
张量检查
每批输入都记录 shape、dtype、device、数值范围和标签含义。广播能让错误形状悄悄运行,因此在模型入口和损失前加入断言。移动设备时参数、输入和损失相关张量必须处于一致设备,不能只移动模型。
Autograd 边界
Autograd 记录参与梯度计算的运算。检查 requires_grad、grad_fn 和参数梯度,区分叶子张量、原地操作与 no_grad/inference_mode。backward 之后梯度默认累积,所以每次更新前显式清梯度;梯度为 None 与全零代表不同问题。
训练与评估模式
model.train() 与 model.eval() 会改变 Dropout、BatchNorm 等模块行为,但 eval 不会自动关闭梯度。评估通常同时使用 eval 和 no_grad/inference_mode。保存回执要记录模式,否则同一权重可能产生不同输出。
保存与恢复
优先保存 state_dict,并连同模型配置、预处理、类别映射、优化器、调度器、epoch 和随机状态一起保存。恢复测试必须在新进程重新构建模型并加载,而不是在原进程继续使用内存对象。对外来 checkpoint 按不可信文件处理。
复现不是一个种子
固定 Python、NumPy、PyTorch 与数据加载器种子只是开始;算法、硬件、线程、依赖和版本仍可能产生差异。记录环境和容差,比较趋势与任务指标。官方也明确跨版本和平台不保证完全复现,因此不要承诺逐位一致。
调试顺序
先用一个 batch 过拟合来验证管线,再检查训练/验证是否使用同样预处理,随后观察梯度、学习率和参数更新。损失不降时保存首个失败 batch、输出和梯度摘要,避免每次随机抽样导致故障消失。
独立任务资产
配套 CPU 脚本固定种子、训练线性模型、比较起止损失并保存 checkpoint。它能证明本机该夹具的训练闭环运行,不证明 GPU、真实数据、模型质量或生产性能。删除生成 checkpoint 后可以重复执行。
DataLoader 先验收数据,再讨论模型
把训练、验证和测试集合的生成规则固定下来,保存数据版本与样本数量。检查 Dataset 返回的单样本结构,再检查 DataLoader 合批后的维度、dtype 和标签范围。多 worker 时为每个 worker 设置可追踪种子,确认 shuffle 只作用于训练集。若数据增强含随机性,保存参数与概率;同一验证样本不应每轮被随机改变。对类别不平衡、缺失值和异常长度分别统计,不用总体数量掩盖小类。
Module 与参数是否真的参与更新
用 named_parameters 检查参数名称、shape、requires_grad 和设备。冻结层时显式记录原因,不依赖名称模糊匹配。前向后确认输出 shape 与任务一致;backward 后抽样记录梯度范数,optimizer.step 前后比较参数摘要。若损失下降但关键层从未更新,模型可能只靠偏置或数据泄漏完成表面拟合。注册缓冲区、非参数状态和自定义层也要进入保存与加载测试。
损失函数必须对应任务口径
分类、回归、分割和排序的目标编码不同,CrossEntropyLoss 等接口对 logits 与标签 shape 有明确要求。不要先手动 softmax 再传给需要 logits 的损失,也不要把 padding token 计入序列损失。记录 reduction、类别权重、ignore_index 和样本权重。训练曲线只有在分母与聚合方式稳定时可比较;分布式环境还需确认指标是否跨进程正确汇总。
优化器状态与断点续训
断点续训不仅加载模型权重,还要加载优化器、学习率调度器、epoch/step、混合精度 scaler 和随机状态。恢复后打印首个学习率和关键状态,跑一个固定 batch 比较连续训练与恢复训练的趋势。若数据 sampler 顺序无法恢复,应明确“近似恢复”而非声称完全一致。保存频率由可接受的重算时间决定,并验证 checkpoint 写入中断时不会覆盖最后一个好版本。
验证集与测试集不能反复调参
验证集用于选择模型和阈值,测试集用于最后估计;如果每次看到测试结果后继续修改,测试集就已参与调参。保存每次实验的代码、配置、数据版本和决定,不只保留最好一轮。高风险任务按人群、时间、来源和失败成本切片,报告分布与错误样本;平均准确率不能替代关键类别召回、校准和人工可用性。
从 CPU 迁移到 GPU 的验收
先确认 CPU 参考结果,再将模型与输入移动到目标设备,记录框架构建、驱动和 GPU。混合精度需要单独容差与溢出检查。性能测量要预热、同步并覆盖真实 batch;数据加载、主机到设备复制和模型计算分别计时。GPU 更快不是训练正确的证据,CPU 与 GPU 不逐位一致也不自动表示错误,应依据任务误差预算判断。
一份合格训练回执
回执至少包含任务、代码提交、数据版本、依赖锁、硬件、种子、模型结构、参数量、损失与优化器配置、训练/验证曲线、最佳 checkpoint 哈希、独立加载结果、失败样本和证明边界。不要记录原始敏感数据到普通日志;可使用受控样本 ID 和统计摘要。只有回执能由另一环境重放,才算完成可复现训练闭环。
发布前验收清单
- 任务、输入、版本、依赖和权限可追踪;
- 基线与候选使用同一测试集和指标;
- 边界、失败和拒绝路径已覆盖;
- 独立加载或重建可以复现;
- 回滚对象、负责人和触发条件明确。
官方来源与下一步
一手资料:PyTorch Learn the Basics、Autograd tutorial、Saving and Loading Models、Reproducibility。站内下一步:CUDA 兼容性诊断、BatchNorm train/eval 检查、学习率实验流程。
证明边界:本页的夹具只验证记录结构或本地最小流程,不证明真实业务质量、GPU 性能、搜索排名、用户效果或生产安全。