
一句话定义
FSDP(Fully Sharded Data Parallel,全分片数据并行)是一种通过将模型参数、梯度和优化器状态在训练过程中动态分片并分散存储于各显卡,从而极大降低显存占用、支持超大规模模型训练的分布式策略。
技术原理:打破显存墙的智能分流术
在深度学习领域,尤其是大语言模型(LLM)的训练中,我们常常面临一个令人头疼的瓶颈:**显存墙(Memory Wall)**。随着模型参数量从亿级飙升至万亿级,单张甚至多张显卡的显存往往不足以装下整个模型。传统的解决方案要么受限于硬件数量,要么牺牲训练效率。FSDP 的出现,正是为了优雅地解决这一难题。
### 核心工作机制:化整为零与动态聚合
要理解 FSDP,首先需要回顾其前身——数据并行(Data Parallelism, DP)和 ZeRO(Zero Redundancy Optimizer)。
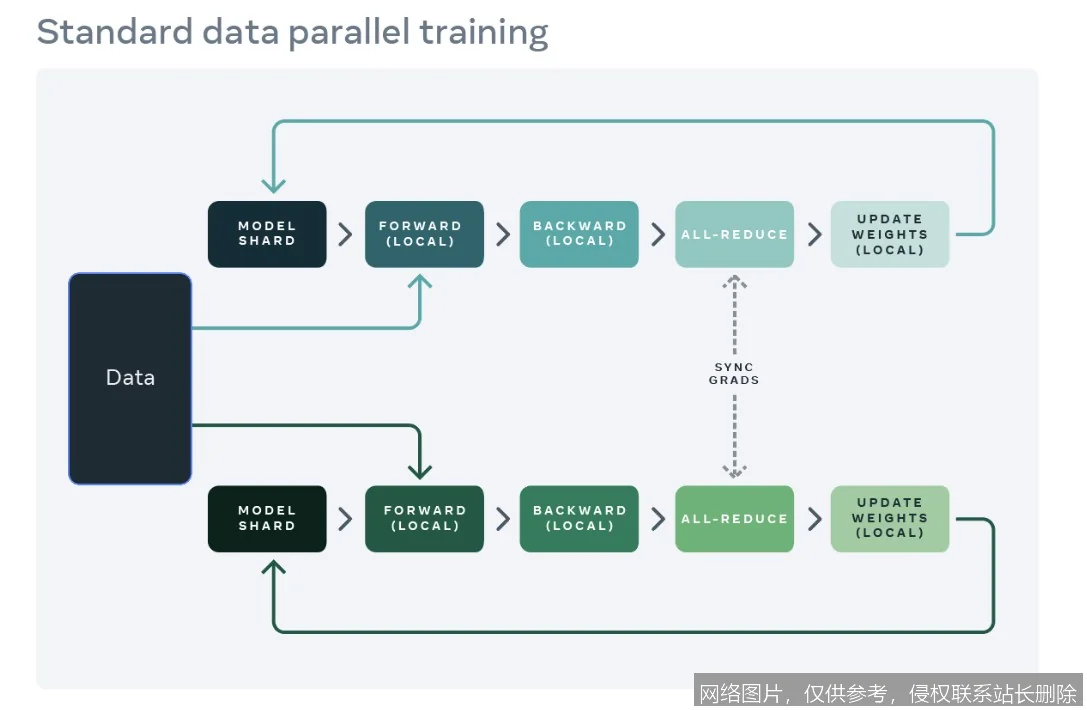
在传统的数据并行中,每个 GPU 都持有一份完整的模型副本。当输入数据被切分后,每个 GPU 独立计算前向传播和反向传播,最后同步梯度。这种方式的致命弱点在于**冗余**:如果模型有 1000 亿参数,每张卡都要存这 1000 亿参数,显存浪费极其严重。一旦模型大小超过单卡显存,训练直接无法启动。
微软提出的 ZeRO 策略试图消除这种冗余,它将优化器状态、梯度甚至模型参数进行分片(Sharding),让每张卡只保存一部分。然而,早期的实现往往需要在通信和计算之间做复杂的权衡,或者需要静态的图结构。
**FSDP(Fully Sharded Data Parallel)** 是 PyTorch 原生集成的一种高级并行策略,它将 ZeRO 的思想推向了极致,并进行了工程上的深度优化。其核心逻辑可以概括为三个步骤:**分片(Shard)、聚合(Gather)、更新(Update)**。
1. **分片存储**:在初始化阶段,FSDP 将模型的参数(Parameters)、梯度(Gradients)以及优化器状态(Optimizer States)全部打散。假设有 8 张卡,那么每张卡只持有总参数量 1/8 的数据。此时,没有任何一张卡拥有完整的模型。
2. **动态聚合(All-Gather)**:这是 FSDP 最精妙的地方。当需要进行前向传播计算某一层时,当前负责计算的 GPU 会通过高速互联网络(如 NVLink 或 InfiniBand)向其他所有 GPU 发起请求,临时“借”回该层所需的完整参数。计算完成后,立即释放这些借来的参数,只保留自己负责的那一小片分片。
3. **梯度同步与归约(Reduce-Scatter)**:在反向传播计算完梯度后,同样不会在全局同步完整的梯度矩阵。而是先进行梯度累加,然后将累加后的梯度再次分片,每张卡只拿回属于自己负责的那部分参数对应的梯度,用于更新本地存储的参数分片。
通过这种“用时聚合,闲时分片”的机制,FSDP 确保了在任何时刻,单张显卡上存储的参数量仅为模型总量的 $1/N$(N 为显卡数量)。这使得显存利用率呈线性提升,理论上允许我们用有限的显存训练无限大的模型(只要显卡数量足够多且通信带宽跟得上)。
### 关键技术组件解析
FSDP 的高效运行依赖于几个关键的技术组件协同工作:
* **分片策略(Sharding Strategy)**:FSDP 提供了不同级别的分片选项。
* `FULL_SHARD`:参数、梯度、优化器状态全部切分。显存节省最多,但通信开销最大。
* `SHARD_GRAD_OP`:仅切分优化器状态和梯度,参数保持完整。适用于显存稍宽裕但希望减少通信的场景。
* `NO_SHARD`:类似传统 DDP,不进行切分,主要用于调试。
* **混合精度训练(Mixed Precision)**:FSDP 原生支持 BF16(Brain Floating Point 16)和 FP16。由于分片后单卡显存压力减小,结合混合精度可以进一步将显存需求压缩至原来的 1/4 甚至更低,同时利用 Tensor Core 加速计算。
* **计算流与通信流重叠(Computation-Communication Overlap)**:为了防止网络通信成为瓶颈,FSDP 采用了异步通信机制。在当前层进行计算时,后台线程已经提前开始预取下一层所需的参数分片。这种“一边算一边传”的流水线设计,极大地掩盖了通信延迟。
* **激活重计算(Activation Checkpointing)**:虽然 FSDP 解决了参数显存问题,但中间激活值(Activations)依然占用大量显存。FSDP 通常与激活重计算技术配合使用,即在前向传播时不保存所有中间结果,而在反向传播时按需重新计算,以时间换空间。
### 与传统方法的对比类比
为了更直观地理解,我们可以用一个**“拼图游戏”**来做类比。
* **传统数据并行(DDP)**:就像有 8 个小朋友(GPU),每个人手里都拿着同一幅完整的 1000 块拼图(模型参数)。老师(数据)把任务分成 8 份,每个人都在自己的完整拼图上操作。缺点是,如果拼图太大(模型太大),小朋友的桌子(显存)根本放不下,游戏直接没法开始。
* **模型并行(Model Parallelism / Tensor Parallelism)**:把一幅拼图强行拆开,第 1 个小朋友只拿第 1-125 块,第 2 个拿 126-250 块。大家必须紧密合作,每走一步都要互相传递碎片。缺点是协调极其复杂,一旦有人慢了,所有人都得等,而且对网络要求极高。
* **FSDP**:这是一种聪明的玩法。平时,每个小朋友桌子上只放自己负责的那 125 块拼图(分片存储)。当需要拼第 1 部分时,第 1 个小朋友喊一声:“大家把第 1 部分的碎片都递给我!”其他小朋友迅速把相关碎片递过去,第 1 个小朋友瞬间凑齐了局部完整的拼图进行拼接,拼完后立刻把借来的碎片还回去,桌上又只剩下自己的那 125 块。
在这个类比中,FSDP 既避免了每个人都要放完整拼图的显存浪费,又避免了像模型并行那样永久性地割裂模型导致的调度僵化。它通过高频但微小的通信,换取了巨大的显存空间,实现了灵活性与效率的最佳平衡。
核心概念:构建分布式训练的术语图谱
深入掌握 FSDP,需要厘清一系列相互关联的专业术语。这些概念构成了分布式训练的基石,同时也往往是初学者容易混淆的地方。
### 关键术语解释
1. **Sharding(分片)**:
指将一个大张量(如模型权重矩阵)切割成多个小块,并分布存储在不同的设备进程中。在 FSDP 中,分片的粒度通常细化到每一个 Transformer 层(Layer),以实现更细粒度的通信控制。
2. **All-Gather 通信原语**:
这是一种集体通信操作。在 FSDP 的前向传播阶段,所有进程将自己持有的分片数据发送给其他所有进程,并将接收到的数据拼接成完整的张量。这是 FSDP“动态聚合”的核心动作。
3. **Reduce-Scatter 通信原语**:
对应反向传播阶段。所有进程先对梯度进行求和(Reduce),然后将求和后的结果按分片规则切分(Scatter),确保每个进程只拿到自己负责更新的那部分梯度。这比传统的 All-Reduce(先求和再广播全员)节省了带宽。
4. **Flat Parameter(扁平化参数)**:
为了优化通信效率,FSDP 会将模型中每一层的多个参数张量(如 weight, bias)在内存中连续存放并视为一个一维的大张量进行处理。这样做可以减少内核启动次数,提高带宽利用率。
5. **Compute Stream vs Communication Stream**:
CUDA 中的两个执行流。FSDP 利用这两个流的并发特性,让计算流执行矩阵乘法,同时通信流在后台搬运参数,实现真正的并行。
### 概念关系图谱
在分布式训练的生态系统中,FSDP 处于承上启下的位置:
* **上游**:依赖 **PyTorch Distributed** 后端(如 NCCL)提供底层的通信能力;依赖 **自动微分(Autograd)** 机制处理反向传播逻辑。
* **同级对比**:
* **DDP (Distributed Data Parallel)**:FSDP 的基线,无参数分片,显存效率低。
* **TP (Tensor Parallelism)**:张量并行,通常在节点内使用,将单个算子拆分。FSDP 常与 TP 组合使用(混合并行)。
* **PP (Pipeline Parallelism)**:流水线并行,将模型层按深度切分。FSDP 常用于 PP 的每个阶段内部,进一步降低显存。
* **下游应用**:支撑 **LLM Pre-training(大模型预训练)**、**Full Fine-tuning(全量微调)** 等重型任务。
它们的关系可以概括为:**对于超大规模模型,通常采用"3D 并行”策略,即 TP(节点内)+ FSDP(节点间/内)+ PP(跨节点)的组合拳。** 其中 FSDP 因其通用性和易用性,成为了连接数据并行和模型并行的关键纽带。
### 常见误解澄清
**误解一:"FSDP 会显著降低训练速度。”**
* **真相**:虽然 FSDP 增加了通信量(All-Gather 和 Reduce-Scatter),但在现代高速互联(如 NVLink H100/H800)环境下,通信开销被计算流很好地掩盖了。更重要的是,由于显存限制解除,我们可以使用更大的 Batch Size 或更深的模型,从而提高了整体的吞吐量(Tokens/sec)。在某些显存受限的场景下,不用 FSDP 根本无法训练,速度无从谈起。
**误解二:"FSDP 就是 ZeRO,两者完全一样。”**
* **真相**:FSDP 的思想源于 DeepSpeed 的 ZeRO,但它是 PyTorch 原生的实现。FSDP 更好地融入了 PyTorch 的生态,支持动态图(Eager Mode),无需像早期 DeepSpeed 那样强制静态图编译(虽然后来也支持了)。此外,FSDP 在 API 设计上更符合 Python 习惯,且与 PyTorch 2.0 的 `torch.compile` 结合得更加紧密。
**误解三:“只有万亿参数模型才需要 FSDP。”**
* **真相**:并非如此。即使是 7B 或 13B 的模型,如果需要进行全量微调(Full Fine-tuning)且 Batch Size 较大,单卡显存往往也不够。FSDP 可以让消费级显卡集群(如 4 张 3090/4090)也能跑通中等规模模型的全量训练,极大地降低了实验门槛。
实际应用:从实验室到工业界的落地实战
FSDP 不仅仅是一个理论概念,它已经成为当前大模型训练事实上的标准配置。无论是开源社区还是商业巨头,都在广泛使用这一技术。
### 典型应用场景
1. **大语言模型预训练(Pre-training)**
这是 FSDP 的主战场。训练一个 70B 甚至 405B 参数的模型,参数量本身就需要数百 GB 的显存。通过 FSDP,可以将这些参数分散到成千上万张 GPU 上。配合流水线并行,能够构建起万卡级别的训练集群。例如,Meta 的 Llama 系列、Mistral AI 的模型训练均大量采用了类 FSDP 的策略。
2. **全量指令微调(Full Fine-Tuning)**
与 LoRA(Low-Rank Adaptation)等参数高效微调方法不同,全量微调需要更新所有参数。对于 30B+ 的模型,全量微调的显存需求极高。FSDP 使得在有限资源下进行全量微调成为可能,有助于挖掘模型在特定领域的最大潜力,避免适配器带来的性能损失。
3. **多模态大模型训练**
视觉 - 语言模型(如 CLIP 的变体、Flamingo 等)通常包含巨大的视觉编码器和文本解码器。FSDP 能够灵活地处理这种异构架构,对不同模块采用不同的分片策略,优化整体显存分布。
4. **科研探索与原型验证**
高校和科研机构通常没有千卡集群。利用 FSDP,研究人员可以在由 8 张或 16 张消费级显卡组成的小型集群上,复现前沿的大模型架构,进行算法创新验证。
### 代表性产品与项目案例
* **PyTorch FSDP (Native)**:
作为 PyTorch 官方库 `torch.distributed.fsdp` 的一部分,它是目前最主流的实现。Hugging Face 的 `accelerate` 库底层也深度集成了 FSDP,用户只需几行配置即可启用。
* *案例*:许多基于 Llama 3 的开源微调项目,默认推荐使用 FSDP 进行全量训练。
* **DeepSpeed ZeRO (Microsoft)**:
虽然 DeepSpeed 是独立的库,但其 ZeRO-3 模式与 FSDP 原理高度一致,且在某些极端优化场景下(如 Offload 到 CPU 内存)表现更强。很多团队会根据需求在 PyTorch FSDP 和 DeepSpeed 之间切换或混用。
* **Fairseq2 & Torchtune (Meta)**:
Meta 发布的新一代工具链全面拥抱 FSDP。Torchtune 作为一个轻量级的微调库,专门针对 Llama 模型优化了 FSDP 配置,使得单节点 8 卡微调 70B 模型变得异常简单。
* **国内大模型框架**:
百度 PaddlePaddle 的分布式策略、阿里 Megatron-LM 的变种版本,也都吸收了 FSDP 的核心思想,应用于通义千问、文心一言等模型的训练过程中。
### 使用门槛和条件
尽管 FSDP 功能强大,但要发挥其最佳性能,仍需满足一定条件:
1. **高速网络互联**:
由于频繁的 All-Gather 操作,节点内的带宽至关重要。**NVLink** 是标配。如果是跨节点通信,则需要 **InfiniBand (IB)** 或高性能 RoCE 网络。如果在千兆以太网环境下使用 FSDP,通信延迟可能会拖垮训练速度。
2. **软件栈版本**:
建议使用较新版本的 PyTorch(2.0+),以获得更好的 `torch.compile` 支持和 FSDP 性能优化。同时需要安装匹配的 CUDA 版本和 NCCL 后端。
3. **代码适配**:
虽然 `accelerate` 简化了流程,但若要深度定制(如自定义分片粒度、混合精度策略、激活检查点配置),仍需对 PyTorch 分布式编程有一定了解。模型结构最好模块化清晰,便于 FSDP 自动 wrapping(包裹)。
4. **调试复杂度**:
分布式环境的调试向来困难。出现死锁、显存泄漏或梯度不同步时,排查难度远高于单机训练。需要熟练掌握分布式调试工具(如 torchelastic, nsys 等)。
延伸阅读:通往分布式专家之路
FSDP 只是分布式深度学习宏大版图中的一块拼图。要真正精通大模型训练,建议沿着以下路径深入探索。
### 相关概念推荐
* **3D Parallelism(三维并行)**:
深入研究如何将数据并行(FSDP)、张量并行(Tensor Parallelism)和流水线并行(Pipeline Parallelism)有机结合。这是训练万亿参数模型的必经之路。
* **Gradient Checkpointing(梯度检查点)**:
理解如何通过牺牲计算时间来换取激活值的显存空间,它与 FSDP 是黄金搭档。
* **Flash Attention**:
一种高效的注意力机制实现,能大幅降低显存占用并提升速度,常与 FSDP 一起使用以最大化性能。
* **MoE (Mixture of Experts)**:
稀疏混合专家模型。了解 FSDP 如何在 MoE 架构中处理动态路由和专家参数的分片,这是下一代大模型的主流架构。
### 进阶学习路径
1. **基础阶段**:
* 掌握 PyTorch 基础,理解 `nn.Module` 和 `DataLoader`。
* 学习 PyTorch Distributed 基础,运行简单的 DDP 示例。
* 阅读 PyTorch 官方关于 FSDP 的文档和 Tutorial。
2. **实践阶段**:
* 使用 Hugging Face `accelerate` 在多卡环境中复现一个开源模型的微调。
* 尝试修改 FSDP 的配置参数(如 `sharding_strategy`, `cpu_offload`),观察显存变化和训练速度的影响。
* 使用 Nsight Systems 等工具分析通信与计算的重叠情况。
3. **专家阶段**:
* 阅读 Megatron-LM 和 DeepSpeed 的源码,对比其与 PyTorch FSDP 的异同。
* 研究最新论文,如关于通信压缩、异步流水线优化等内容。
* 尝试在大规模集群上部署并调优千卡级别的训练任务。
### 推荐资源和文献
* **官方文档**:
* *PyTorch FSDP Documentation*: 最权威的配置指南和 API 参考。
* *Hugging Face Accelerate Docs*: 提供了大量基于 FSDP 的实战示例。
* **经典论文**:
* *"ZeRO: Memory Optimizations Toward Training Trillion Parameter Models"* (Rajbhandari et al., SC 2020): FSDP 的理论源头,必读。
* *"PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel"* (Zhao et al., 2023): 详细介绍了 PyTorch 实现的细节和性能基准。
* **技术博客与教程**:
* *Hugging Face Blog*: 搜索 "FSDP" 或 "Large Model Training",有大量图文并茂的实操文章。
* *PyTorch Blog*: 关注官方发布的关于分布式训练的最新进展和最佳实践。
* *B 站/YouTube*: 搜索 "FSDP 原理" 或 "大模型训练实战",许多技术博主提供了视频版的代码走读和原理解析。
通过系统学习 FSDP 及其相关生态,你将不仅掌握一项具体的技术工具,更能建立起对大规模分布式系统设计的深刻认知,为驾驭未来更大规模的 AI 模型打下坚实基础。





