
一句话定义
Flash Attention 是一种通过分块计算与内存优化算法,将注意力机制的显存占用从二次方降为线性,从而大幅提升大模型训练与推理速度的核心技术。
技术原理:打破“内存墙”的革命
要理解 Flash Attention(闪式注意力)为何被称为大模型时代的“加速器”,我们首先需要直面一个长期困扰深度学习领域的物理瓶颈:**内存墙**(Memory Wall)。
在传统的大语言模型(LLM)训练中,标准的注意力机制(Standard Attention)虽然数学上优雅,但在工程实现上却极其低效。这种低效并非源于计算能力不足,而是源于数据搬运的延迟。为了深入解析这一机制,我们需要从核心工作机制、关键组件以及与传统方法的对比三个维度展开。
### 1. 核心痛点:为什么标准注意力慢?
在标准的 Scaled Dot-Product Attention 中,计算过程通常分为三步:
1. 计算注意力分数矩阵 $S = QK^T$(大小为 $N \times N$,其中 $N$ 是序列长度)。
2. 对 $S$ 进行 Softmax 归一化得到概率矩阵 $P$。
3. 将 $P$ 与价值矩阵 $V$ 相乘得到输出 $O = PV$。
这个过程看似流畅,但在 GPU 硬件层面却是一场灾难。当序列长度 $N$ 增加时,中间矩阵 $S$ 和 $P$ 的大小呈二次方增长($O(N^2)$)。对于长度为 64k 的上下文,这个中间矩阵需要数百 GB 的显存来存储。然而,现代 GPU(如 NVIDIA H100 或 A100)的高带宽内存(HBM)容量有限,且访问速度远低于片上静态随机存取存储器(SRAM)的计算速度。
这就导致了一个现象:**GPU 大部分时间不是在“计算”,而是在等待数据从慢速的 HBM 搬运到快速的 SRAM**。这就是所谓的“内存受限”(Memory-bound)而非“计算受限”(Compute-bound)。标准算法需要将巨大的 $Q, K, V$ 矩阵反复读写到 HBM 中,产生了海量的无效内存访问(IO),严重拖慢了整体速度。
### 2. Flash Attention 的核心机制:分块与重计算
Flash Attention 由斯坦福大学三胞胎兄弟 Tri Dao 等人提出,其核心思想可以概括为:"**不要把所有东西都存下来,算完即焚,利用快存做一切。**"
它通过两个关键技术手段解决了上述问题:
#### A. 分块处理(Tiling)
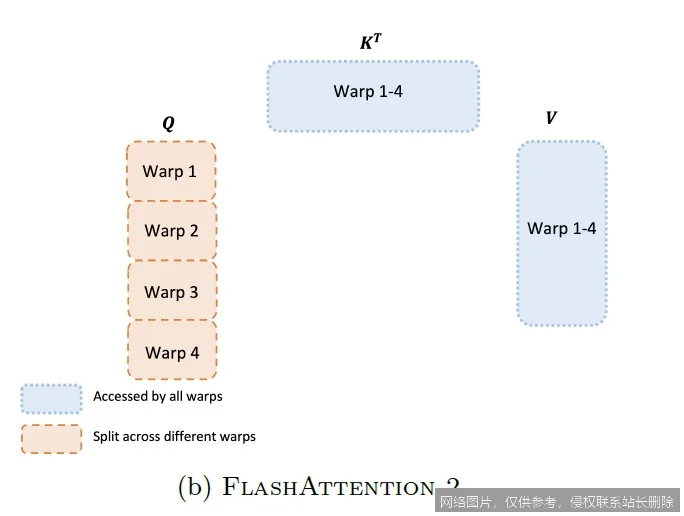
Flash Attention 不再一次性将整个 $N \times N$ 的矩阵加载到显存中。相反,它将查询矩阵 $Q$、键矩阵 $K$ 和价值矩阵 $V$ 切割成适合放入 GPU 片上 SRAM(Shared Memory)的小块(Blocks)。
* **工作流程**:算法每次只从 HBM 读取一小块 $Q_i$ 和对应的 $K_j, V_j$ 到 SRAM 中。
* **局部计算**:在 SRAM 内部完成这小块数据的矩阵乘法、Softmax 和加权求和。
* **结果累积**:计算出的部分结果直接累加到输出块中,而不是生成巨大的中间矩阵。
由于 SRAM 的访问速度比 HBM 快几个数量级(例如在 A100 上快约 20 倍),这种策略极大地减少了昂贵的全局内存访问次数。无论序列长度多长,所需的 SRAM 大小是恒定的,从而将显存占用从 $O(N^2)$ 降低到了 $O(N)$。
#### B. 重计算技巧(Recomputation)
在传统反向传播中,为了计算梯度,通常需要保存前向传播中的所有中间激活值(如巨大的注意力矩阵 $P$)。这在长序列下是不可接受的。
Flash Attention 采用了一种巧妙的策略:**在前向传播时不保存巨大的中间矩阵,而在反向传播时,根据需要重新计算这些中间值**。
听起来这会增加计算量?是的,但因为在 SRAM 中重计算的速度极快,而节省下来的内存带宽开销巨大,总体来看,“多算少存”的策略反而让整体速度提升了数倍。这是一种典型的“用计算换带宽”的时空权衡(Time-Memory Trade-off)。
### 3. 类比理解:图书馆与书桌
为了更直观地理解,我们可以做一个类比:
* **标准注意力**就像是一个学生(GPU 核心)在做一道复杂的数学题。他有一张很小的书桌(SRAM),但参考书(数据)都在远处的巨大图书馆(HBM)里。
* 传统做法是:他每算一步,就要跑回图书馆抄下一整章的内容($N \times N$ 矩阵)贴在墙上,然后再回到书桌计算。因为墙太小,书太长,他大部分时间都在跑步(内存搬运),而且经常因为墙贴不下而不得不停工。
* **Flash Attention**则是这位学生改变了策略:
* 他只从图书馆借来刚好能放在书桌上的一页纸(Block)。
* 他在书桌上迅速算出这一页的结果,记在笔记本上,然后把这一页书还回去(释放 SRAM)。
* 接着借下一页,继续算,并将新结果累加到笔记本上。
* 如果需要检查之前的步骤(反向传播),他不保留那些废纸,而是重新去图书馆借那一页快速重算一遍。
* **结果**:他几乎不需要长跑,绝大部分时间都在书桌上高效计算,解题速度自然飞快。
### 4. 与传统方法的对比总结
| 特性 | 标准注意力 (Standard Attention) | Flash Attention (v1/v2/v3) |
| :--- | :--- | :--- |
| **显存复杂度** | $O(N^2)$ (随序列长度平方增长) | $O(N)$ (线性增长) |
| **内存访问 **(IO) | 极高,受限于 HBM 带宽 | 极低,主要利用 SRAM |
| **中间矩阵存储** | 必须存储巨大的 $S$ 和 $P$ 矩阵 | 不存储,即时计算即时丢弃 |
| **适用序列长度** | 短序列尚可,长序列显存爆炸 | 支持超长上下文 (100k+) |
| **硬件利用率** | 低 (Memory-bound) | 高 (Compute-bound) |
| **数值精度** | 标准 FP16/BF16 | 保持数学等价,精度无损 |
通过这种底层算子的重构,Flash Attention 不仅让模型跑得更快,更重要的是,它让训练和推理更长上下文的模型成为了可能,直接推动了长文本理解能力的飞跃。
核心概念:构建知识图谱
在深入掌握 Flash Attention 的过程中,有几个关键术语和概念关系必须厘清。这部分将帮助读者建立完整的认知框架,并澄清常见的误解。
### 1. 关键术语解释
* **HBM **(High Bandwidth Memory,高带宽内存):
这是 GPU 上的主显存,容量大但相对于计算核心来说速度较慢。它是限制大模型性能的主要瓶颈所在。Flash Attention 的核心目标就是减少对 HBM 的访问频率。
* **SRAM **(Static Random Access Memory,静态随机存取存储器):
位于 GPU 芯片内部(如 CUDA Core 附近的 Shared Memory),容量非常小(通常只有几百 KB 到几 MB),但速度极快。Flash Attention 通过将计算限制在 SRAM 内来完成加速。
* **IO-Awareness **(IO 感知):
这是 Flash Attention 的设计哲学。传统的算法设计只关注浮点运算次数(FLOPs),忽略了数据搬运的成本。IO-Aware 算法则明确地将内存读写次数作为优化的首要目标。
* **Block-wise Computation **(分块计算):
将大矩阵分解为小块进行处理的技术。这是实现线性显存复杂度的基础。
* **Online Softmax**:
一种允许在不看到全部数据的情况下逐步计算 Softmax 的算法技巧。由于分块处理时无法一次性获得所有 $QK^T$ 的值来计算全局最大值(用于数值稳定),Online Softmax 允许算法在处理每个块时动态更新最大值和归一化因子,从而实现流式计算。
### 2. 概念关系图谱
为了理清逻辑,我们可以构建如下的概念依赖关系:
1. **基础层**:Transformer 架构 -> 自注意力机制 (Self-Attention)。
2. **瓶颈层**:序列长度 $N$ 增加 -> $QK^T$ 矩阵爆炸 -> **内存墙 **(Memory Wall) 形成。
3. **解决方案层**:
* 输入:$Q, K, V$ 矩阵。
* 策略:**分块 **(Tiling) + **重计算 **(Recomputation)。
* 执行环境:从 **HBM** 迁移至 **SRAM**。
* 算法支撑:**Online Softmax**。
4. **产出层**:**Flash Attention** 算子。
5. **效果层**:显存 $O(N)$ -> 支持长上下文 -> 训练/推理加速 (2-9 倍)。
在这个图谱中,Flash Attention 不是替代了注意力机制的数学公式,而是改变了其**实现方式**(Implementation)。输出的数学结果与标准注意力是完全一致的(Mathematically Equivalent),只是路径不同。
### 3. 常见误解澄清
**误解一:"Flash Attention 是一种近似算法,会损失精度。”**
* **真相**:完全错误。Flash Attention 是**精确算法**。它在数学上与标准注意力机制完全等价。它没有引入任何截断或近似采样(除非用户主动开启稀疏模式,但原生 Flash Attention 是稠密的)。精度的差异仅来源于浮点数运算顺序的不同带来的微小舍入误差,这在深度学习中是可以忽略不计的。
**误解二:"Flash Attention 只能用于推理阶段。”**
* **真相**:恰恰相反,Flash Attention 在**训练阶段**的收益更为巨大。因为在训练的反向传播中,标准方法需要保存巨大的中间激活值,显存压力是推理的两倍以上。Flash Attention 的重计算策略在训练中能节省高达 50%-80% 的显存,使得在相同显卡上能训练更大的批量(Batch Size)或更长的序列。
**误解三:“只要用了 Flash Attention,任何模型都会变快。”**
* **真相**:不一定。Flash Attention 的优势在于长序列和大规模矩阵运算。如果序列长度很短(例如小于 128),或者模型本身受限于其他组件(如嵌入层或全连接层的通信开销),加速效果可能不明显。此外,它高度依赖特定的 GPU 架构(如 NVIDIA Ampere, Hopper 架构),在旧款显卡上可能无法运行或效果不佳。
**误解四:"Flash Attention 就是稀疏注意力(Sparse Attention)。”**
* **真相**:两者不同。稀疏注意力是通过忽略某些无关的 token 对来减少计算量(改变计算图结构),可能会损失信息。Flash Attention 是稠密注意力,它计算了所有的 token 对,只是通过优化内存访问来加速。当然,两者可以结合使用(如 FlashDecoding 或稀疏版本的 Flash Attention),但概念上是独立的。
实际应用:从实验室到 2026 年的落地
Flash Attention 已经从一个学术界的创新迅速演变为工业界的标准配置。展望未来,特别是在 2026 年及以后的 AI 应用格局中,它将成为基础设施的一部分。
### 1. 典型应用场景
* **超长上下文大语言模型 **(Long-Context LLMs):
这是最直接的应用领域。处理 10 万字甚至 100 万字的文档、法律合同分析、全代码库理解,都需要极长的上下文窗口。没有 Flash Attention,这类模型的训练成本将是天文数字,推理显存需求也将超出单卡甚至多卡的承受范围。
* **高分辨率视频生成与理解**:
视频数据本质上是时间序列上的图像帧。将视频视为 Token 序列时,长度会急剧膨胀。Flash Attention 使得 Diffusion Transformer (DiT) 等模型能够处理更长帧数的视频生成任务,显著提升视频生成的连贯性和时长。
* **多模态大模型 **(Multimodal Models):
在处理高分辨率图像输入时,Vision Transformer (ViT) 的 Patch 数量巨大。结合文本后,序列长度进一步增加。Flash Attention 使得多模态模型能够在消费级显卡上进行高效的微调(Fine-tuning)和部署。
* **端侧大模型 **(On-Device AI):
随着手机和笔记本电脑集成 NPU 和更强的 GPU,本地运行 7B-13B 参数量的模型成为趋势。有限的内存带宽是端侧设备的死穴,Flash Attention 的线性显存特性使得在 8GB-16GB 内存的设备上流畅运行长对话模型成为可能。
### 2. 代表性产品与项目案例 (含 2026 展望)
* **当前主流框架集成**:
目前,**PyTorch 2.0+** 已默认在后台调用 Flash Attention 2(当检测到兼容硬件时)。**Hugging Face Transformers** 库也全面支持通过 `attn_implementation="flash_attention_2"` 一键开启。**vLLM**、**TGI **(Text Generation Inference) 等高性能推理引擎更是将其作为核心加速组件,实现了极高的吞吐量。
* **2026 年应用展望**:
* **实时全息交互助手**:预计到 2026 年,具备“永远在线”记忆的个人 AI 助理将普及。它们需要维护用户数年对话历史的向量索引和上下文。Flash Attention 的迭代版本(如假想的 Flash Attention 4)将配合新型硬件,支持百万级 Token 的实时检索与生成,实现真正的“过目不忘”。
* **科学计算大模型**:在蛋白质折叠、气候模拟等领域,序列长度往往代表空间网格或时间步长。Flash Attention 将使基于 Transformer 的科学模型能够处理更高精度的全球气候模拟,将原本需要超算集群的任务下沉到小型集群甚至单机。
* **自适应动态分辨率渲染**:在游戏和元宇宙应用中,AI 将根据视线焦点动态调整渲染细节。Flash Attention 将支持这种动态变化的超长序列处理,确保低延迟和高画质并存。
### 3. 使用门槛和条件
尽管优势明显,但要使用 Flash Attention 仍需满足一定条件:
* **硬件要求**:
* **GPU 架构**:主要支持 NVIDIA **Ampere** (A100, RTX 30 系列), **Ada Lovelace** (RTX 40 系列), 和 **Hopper** (H100) 架构。较旧的 Volta (V100) 或 Pascal 架构不支持或支持不佳。
* **显存类型**:虽然对显存大小要求降低了,但仍建议使用带有高带宽内存(HBM2e/HBM3)的专业卡以获得最佳效果。
* **软件环境**:
* 需要安装专门的 `flash-attn` Python 包(通常需要从源码编译,对 CUDA 版本有严格要求)。
* 深度学习框架需较新版本(PyTorch 1.13+ 或 2.0+ 推荐)。
* 数据类型通常支持 **FP16** 和 **BF16**,部分新版本开始支持 **FP8** 以进一步加速。
* **开发适配**:
* 对于自定义模型架构,开发者需要确保注意力掩码(Mask)的逻辑能与分块计算兼容。虽然大多数标准 Mask(如因果掩码 Causal Mask)都已完美支持,但极度复杂的自定义稀疏模式可能需要修改底层 CUDA 代码。
总的来说,对于大多数使用者而言,只需在加载模型时添加一行配置代码即可享受其红利,门槛正在迅速降低。
延伸阅读:进阶学习路径
如果您希望从原理到实战全面掌握 Flash Attention 及其相关生态,以下资源和建议将为您提供清晰的指引。
### 1. 相关概念推荐
在理解 Flash Attention 的基础上,您可以进一步探索以下紧密相关的技术领域,它们共同构成了现代高效大模型的基石:
* **PagedAttention **(vLLM 核心技术):借鉴操作系统虚拟内存的分页思想,解决推理过程中显存碎片化问题,与 Flash Attention 常配合使用以实现极致推理性能。
* **Quantization **(量化技术):如 INT8, INT4, FP8 量化。通过降低数值精度来进一步压缩模型体积和加速计算,与 Flash Attention 的“省显存”目标殊途同归。
* **MoE **(Mixture of Experts,混合专家模型):通过稀疏激活增加模型参数量而不显著增加计算量,结合 Flash Attention 可训练万亿参数级别的巨型模型。
* **Ring Attention**:针对多机多卡训练场景,将序列并行化分布在多个 GPU 上,是 Flash Attention 在分布式训练维度的延伸。
### 2. 进阶学习路径
建议按照以下三个阶段进行深入:
* **阶段一:直觉与宏观理解**
* 阅读 Tri Dao 的博客文章《FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness》。
* 观看相关的技术演讲视频(如 Stanford CS329S 课程录像),重点关注“内存墙”的图解部分。
* 目标:能手绘出标准 Attention 与 Flash Attention 的数据流向区别。
* **阶段二:代码与数学推导**
* 研读 Flash Attention 的官方 GitHub 仓库代码,特别是 CUDA Kernel 的实现部分(如果具备 CUDA 基础)。
* 推导 Online Softmax 的数学公式,理解如何在分块情况下保持数值稳定性。
* 尝试在 PyTorch 中手动实现一个简化版的 Tiled Attention,对比其与 `torch.nn.functional.scaled_dot_product_attention` 的性能差异。
* **阶段三:系统优化与前沿追踪**
* 研究如何将 Flash Attention 集成到自定义的 Trainer 中。
* 关注 Flash Attention 3 (针对 H100/H200 优化) 及后续版本的特性,如针对 FP8 的支持和对异步流水线的优化。
* 探索其在非文本领域(如音频、视频、基因组学)的应用论文。
### 3. 推荐资源和文献
* **原始论文**:
* *FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness* (NeurIPS 2022).
* *FlashAttention-2: Attention is Not All You Need* (2023, arXiv preprint).
* **代码仓库**:
* GitHub: `tridao/flash-attention` (官方实现,包含详细的文档和 Benchmark)。
* **教程与博客**:
* Hugging Face Blog: "The Magic of Flash Attention".
* Lil'Log (博客): 关于 Transformer 优化系列的深度解析文章。
* **工具库**:
* `vLLM`: 体验集成了 Flash Attention 的高性能推理框架。
* `unsloth`: 一个专注于高效微调的库,深度利用了 Flash Attention 技术。
通过本文的解析,希望您不仅能回答"Flash Attention 是什么”,更能理解它如何重塑了我们对大模型效率的认知。在算力日益珍贵的今天,像 Flash Attention 这样通过算法创新挖掘硬件潜力的技术,将是推动 AI 走向普及的关键力量。





