
一句话定义
ROUGE(Recall-Oriented Understudy for Gisting Evaluation)是一种基于 N-gram 重叠率计算的自动化评估指标,用于量化机器生成文本与人类参考摘要之间的相似度。
技术原理:从“词袋”到“语义指纹”的匹配逻辑
在自然语言处理(NLP)的宏大版图中,如何判断一台机器写的文章好不好,曾经是一个极度依赖人工主观打分的问题。直到 2004 年,Chin-Yew Lin 提出了 ROUGE,它彻底改变了自然语言生成(NLG)领域的评估范式。要理解 ROUGE 是什么,我们不能只停留在公式表面,而必须深入其核心工作机制,看看它是如何将模糊的“语言质量”转化为精确的“数学分数”的。
### 核心工作机制:基于重叠率的统计博弈
ROUGE 的核心思想非常直观且朴素:**如果机器生成的摘要(Candidate Summary)中包含了很多出现在人类专家撰写的参考摘要(Reference Summary)中的词汇或短语,那么这篇生成的摘要质量就高。**
这种机制建立在统计学的基础上,主要计算的是“重叠度”(Overlap)。具体来说,它将文本拆解为不同长度的单元(Unit),通常是单词(Unigram)、连续的双词组合(Bigram)甚至更长的序列(N-gram),然后统计这些单元在“生成文本”和“参考文本”中共同出现的次数。
这里有一个关键的技术细节需要厘清:传统的机器翻译评估指标(如 BLEU)侧重于“精确率”(Precision),即机器生成的内容有多少是准确的;而 ROUGE 顾名思义,侧重于“召回率”(Recall),即人类参考摘要中的关键信息,有多少被机器成功“召回”或覆盖到了。在摘要任务中,遗漏关键信息(低召回)通常比多说几句废话(低精确)后果更严重,因此 ROUGE 的设计哲学天然契合摘要任务的需求。
其基础计算公式可以简化为以下逻辑:
$$ \text{ROUGE-N} = \frac{\sum \text{Count}_{\text{match}}(\text{N-gram})}{\sum \text{Count}(\text{Reference N-gram})} $$
分子是生成文本和参考文本中匹配的 N-gram 数量,分母是参考文本中该 N-gram 的总数量。
### 关键技术组件解析
为了全方位评估文本质量,ROUGE 家族演化出了多个变体,每个变体都针对不同的语言特征进行了优化:
1. **ROUGE-N(N-gram 重叠)**:
这是最基础的版本。它计算连续 N 个词的重叠情况。
* **ROUGE-1**:计算单个词的重叠。它反映了内容的覆盖度,即“关键点是否都提到了”。
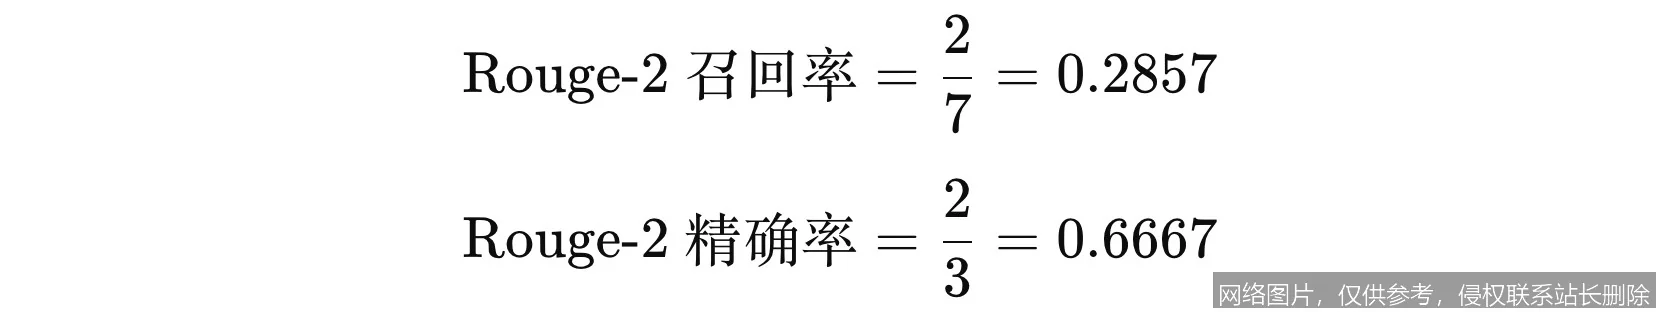
* **ROUGE-2**:计算连续两个词的重叠。它不仅看词是否在,还看词的顺序是否大致正确,能在一定程度上反映局部的流畅度和上下文连贯性。
* **ROUGE-L**:这是一个特殊的存在,它不固定 N 的大小,而是基于**最长公共子序列**(Longest Common Subsequence, LCS)。LCS 允许中间跳过一些词,只要相对顺序一致即可。这使得 ROUGE-L 对句法结构的灵活性更高,能够捕捉句子层面的结构相似性,而不必苛求连续的词语完全匹配。
2. **ROUGE-S(Skip-bigram)**:
考虑到语言中经常出现的插入语或倒装结构,严格的连续 N-gram 可能会漏掉语义相同的表达。ROUGE-S 引入了“跳字双词”概念,允许两个词之间间隔任意数量的其他词,只要它们的相对顺序不变就算匹配。这大大增强了模型对句式变化的鲁棒性。
3. **加权与 F1 值**:
在实际应用中,单纯的召回率(Recall)可能导致机器通过无限堆砌参考文本中的词汇来刷高分。因此,工业界通常使用 **ROUGE-F1** 分数,它是精确率(Precision)和召回率(Recall)的调和平均数,旨在寻找两者的最佳平衡点。
### 与传统方法的对比:从“人工阅卷”到“自动批阅”
在 ROUGE 出现之前,评估摘要系统主要依靠人工评估(Human Evaluation)。研究人员会招募一批志愿者,根据“流利度”、“信息覆盖率”、“简洁性”等维度给机器生成的摘要打分(通常是 1-5 分)。
这种方法虽然直观,但存在致命缺陷:
* **成本高昂**:每训练一个模型版本,都需要大量人力重新打分,迭代周期极长。
* **主观性强**:不同标注者对“好摘要”的标准不一,导致数据噪声大,难以复现。
* **扩展性差**:面对海量数据的现代大模型训练,人工评估完全无法跟上节奏。
相比之下,ROUGE 就像是一位不知疲倦、标准统一的“自动阅卷老师”。
* **效率**:毫秒级出分,支持大规模自动化测试。
* **一致性**:只要代码和参数不变,任何人在任何时间跑出的结果都完全一致。
* **相关性**:多项研究表明,ROUGE 分数与人类评分之间存在显著的正相关性(尽管不是完美对应),足以作为模型迭代的风向标。
当然,用类比来说,传统人工评估像是由资深编辑进行的“深度书评”,能洞察文章的神韵和情感;而 ROUGE 更像是一个高效的“关键词扫描仪”,它能迅速告诉你这篇文章是否涵盖了所有必要的新闻要素,但它读不懂文章的幽默感或深层隐喻。正是这种“扫描”特性,使其成为了过去二十年 NLP 领域事实上的黄金标准。
核心概念:构建评估体系的术语图谱
要真正掌握"ROUGE 是什么”,必须厘清围绕它的一系列关键术语及其相互关系。这些概念构成了自然语言生成评估的基石,同时也往往是初学者容易产生误解的地方。
### 关键术语解释
1. **N-gram(N 元语法)**:
这是 ROUGE 计算的原子单位。指文本中连续的 N 个词。例如句子"AI is changing the world",其 Bigram(2-gram)包括:"AI is", "is changing", "changing the", "the world"。ROUGE-N 就是统计这些片段的重合度。
2. **Reference Summary(参考摘要)**:
也称为"Gold Standard"(金标准)。这是由人类专家撰写的、被视为完美的摘要版本。在评估时,机器的输出将与之比对。值得注意的是,高质量的评估通常需要多个参考摘要(Multi-reference),因为同一篇文章可以有多种不同的完美概括方式。
3. **Candidate Summary(候选摘要)**:
由算法模型生成的、待评估的摘要文本。
4. **Stemming(词干提取)**:
在计算重叠前,通常会进行预处理,将单词还原为词干。例如,"running", "runs", "ran" 都会被统一视为 "run"。这一步至关重要,因为它避免了因词形变化导致的误判,提高了评估的宽容度。
5. **Stopwords Removal(停用词去除)**:
指过滤掉 "the", "a", "is" 等高频但无实际语义的词汇。在某些 ROUGE 实现中,这会作为可选步骤,以防止常见虚词干扰对核心内容匹配度的判断。
6. **F1 Score(F1 分数)**:
精确率(Precision)和召回率(Recall)的调和平均数。公式为 $F1 = 2 \times \frac{P \times R}{P + R}$。在汇报结果时,如果说"ROUGE-1 得分为 45",默认指的通常是 ROUGE-1 F1 分数。
### 概念之间的关系图谱
我们可以将这些概念想象成一个精密的工厂流水线:
* **输入端**:【候选摘要】和【参考摘要】进入系统。
* **预处理车间**:首先经过【词干提取】和【停用词去除】的清洗,将文本标准化。
* **切割工序**:文本被切割成不同规格的零件,即【N-gram】(ROUGE-1, ROUGE-2)或【最长公共子序列】(ROUGE-L)。
* **比对核心**:系统计算零件的重叠数量,分别得出【精确率】(机器说的有多少是对的)和【召回率】(人类要的有多少被找到了)。
* **输出端**:最后综合计算出【F1 分数】,形成最终的评估报告。
在这个链条中,【多参考摘要】机制是一个重要的并行通道。当存在多个参考摘要时,系统通常会计算机器输出与每一个参考摘要的得分,然后取最大值(Max)或平均值(Average),以包容人类表达的多样性。
### 常见误解澄清
在学习"ROUGE 是什么”的过程中,有几个常见的误区需要特别警惕:
**误解一:"ROUGE 分数高意味着文章写得好。”**
**真相**:ROUGE 分数高仅意味着机器生成的文本在词汇和短语层面与人类参考文本高度重合。它无法评估事实的正确性(Factuality)。如果机器把参考摘要里的话原封不动地抄下来但逻辑不通,或者产生了“幻觉”(Hallucination)却恰好撞上了某些关键词,分数可能依然很高。ROUGE 测的是“相似度”,而非“真理度”。
**误解二:"ROUGE-L 比 ROUGE-2 更高级,所以应该只看 ROUGE-L。”**
**真相**:不同指标侧重点不同。ROUGE-2 对局部连贯性敏感,适合评估短语搭配的准确性;ROUGE-L 对整体句法结构敏感。在顶级学术会议(如 ACL, EMNLP)的论文中,通常会同时报告 ROUGE-1, ROUGE-2, 和 ROUGE-L 三个指标,以提供多维度的视角。单一指标往往具有欺骗性。
**误解三:“只要用了 ROUGE,就不需要人工评估了。”**
**真相**:这是一个危险的极端。ROUGE 是模型开发阶段的“导航仪”,用于快速迭代;但在模型发布前的最终验收阶段,人工评估依然是不可或缺的“终审法官”。特别是在医疗、法律等高风险领域,机器生成的细微语义偏差可能导致严重后果,这是纯统计指标无法捕捉的。
**误解四:"ROUGE 适用于所有语言。”**
**真相**:原始的 ROUGE 设计主要针对英语等以空格分隔的语言。对于中文、日文等没有天然空格的语言,必须先进行准确的分词(Segmentation)。分词工具的误差会直接传导至 ROUGE 分数,导致评估失真。因此,在中文语境下讨论"ROUGE 是什么”时,必须包含“分词预处理”这一前置条件。
实际应用:从实验室到 2026 年的产业落地
理解了原理和概念后,我们需要将视线投向现实世界。ROUGE 不仅仅是一个学术指标,它已经深深嵌入了自然语言处理产业链的各个环节,并在向着 2026 年的智能化未来演进。
### 典型应用场景
1. **自动摘要系统的研发与迭代**:
这是 ROUGE 的主战场。无论是新闻聚合平台(如今日头条、Google News)的快讯生成,还是金融研报的自动提炼,研发团队在训练模型的每一个 Epoch(训练轮次),都会实时计算验证集上的 ROUGE 分数。它是决定模型参数是否保存、学习率是否调整的“指挥棒”。
2. **机器翻译的质量监控**:
虽然 BLEU 是翻译领域的主流指标,但在某些侧重“意译”或“摘要式翻译”的场景下,ROUGE-L 常被用作补充指标,以评估译文是否覆盖了源文的核心信息点。
3. **对话系统的回复评估**:
在开放域聊天机器人中,评估回复的质量极具挑战。研究人员利用 ROUGE 来衡量机器回复与标准库中优质回复的相似度,以此筛选出那些“言之无物”或“偏离主题”的坏案例进行针对性优化。
4. **数据清洗与过滤**:
在大模型预训练数据准备阶段,利用 ROUGE 可以检测数据集中的重复内容。如果两条文本的 ROUGE 分数过高,说明它们内容高度冗余,可以进行去重,从而提高训练数据的多样性。
### 代表性产品与项目案例
* **Hugging Face Evaluate 库**:
作为全球最受欢迎的 AI 开源社区,Hugging Face 将 ROUGE 封装成了极易调用的模块。开发者只需几行代码,即可在数千个主流数据集(如 CNN/DailyMail, XSum)上运行标准的 ROUGE 评估。这极大地降低了"ROUGE 是什么”的技术门槛,使其成为行业标准工具。
* **Google T5 与 BART 模型**:
这两个里程碑式的文本生成模型,在其原始论文中均将 ROUGE 分数作为核心性能证据。它们通过在大规模数据上优化 ROUGE 指标,证明了预训练 - 微调范式的有效性,直接推动了生成式 AI 的爆发。
* **企业级智能客服平台**:
国内外的头部云厂商(如阿里云、AWS)在其智能客服解决方案中,后台均集成了基于 ROUGE 的自动化质检系统。系统会自动抽取客服与用户的对话摘要,并与标准话术库比对,实时监控服务质量的波动。
### 使用门槛与 2026 应用展望
**当前使用门槛**:
对于初级开发者,使用 ROUGE 的主要障碍在于**环境配置**(依赖 Perl 脚本的历史遗留问题,虽已有 Python 重写版但仍需注意版本兼容性)以及**分词处理**(特别是非英语语言)。此外,正确解读分数也需要经验,因为不同数据集的基准分数(Baseline)差异巨大,脱离数据集谈绝对分值是没有意义的。
**面向 2026 年的演进与应用**:
展望 2026 年,随着大语言模型(LLM)能力的飞跃,"ROUGE 是什么”这一问题的答案将迎来新的内涵:
1. **从“字面匹配”到“语义对齐”的混合评估**:
纯粹的 N-gram 匹配在生成能力极强的 2026 年将显得愈发捉襟见肘。未来的评估体系将是"ROUGE + 基于 Embedding 的语义相似度(如 BERTScore)+ LLM 作为裁判(LLM-as-a-Judge)”的三元融合。ROUGE 将继续担任“守门员”角色,负责快速过滤掉明显偏离主题的生成内容,保证基础的信息覆盖率,而更深层次的逻辑推理和情感共鸣则交给更先进的指标。
2. **实时动态评估标准**:
在 2026 年的个性化生成场景中,参考摘要可能不再是静态的文本,而是动态的用户偏好向量。ROUGE 算法可能会被改造,支持加权匹配——用户关心的关键词权重更高,无关紧要的虚词权重降低,实现千人千面的评估标准。
3. **多模态 ROUGE**:
随着视频摘要、图文生成任务的普及,ROUGE 的概念将扩展到多模态领域。例如,计算生成视频的旁白文本与关键帧提取文本之间的 ROUGE 分数,成为评估多模态模型一致性的重要维度。
尽管新技术层出不穷,但 ROUGE 凭借其简单、透明、可解释性强的特点,在 2026 年依然不会退出历史舞台。它将像尺子一样,虽然无法测量物体的温度或重量,但在测量“长度”(文本覆盖度)这一基础维度上,依然是最可靠、最通用的工具。
延伸阅读:构建完整的评估知识体系
如果您希望从"ROUGE 是什么”出发,进一步构建起自然语言生成评估的完整知识大厦,以下路径和资源不容错过。
### 相关概念推荐
* **BLEU (Bilingual Evaluation Understudy)**:
ROUGE 的“兄弟”指标,主要用于机器翻译。理解 BLEU 有助于对比理解“精确率导向”与“召回率导向”的差异。
* **METEOR (Metric for Evaluation of Translation with Explicit ORdering)**:
引入了同义词匹配和词序惩罚的指标,比 ROUGE 更注重语义层面的等价性,是对 ROUGE 刚性匹配的重要补充。
* **BERTScore**:
利用预训练语言模型(如 BERT)的计算上下文嵌入(Contextual Embeddings)来计算相似度。它能识别"happy"和"glad"是相似的,而 ROUGE 则认为它们完全不同。这是当前学术界的研究热点。
* **Human Evaluation Protocols**:
深入了解人工评估的具体量表设计(如 Likert Scale)、众包平台的使用以及统计学显著性检验(t-test),是跳出自动化指标局限的关键。
### 进阶学习路径
1. **入门阶段**:阅读 Chin-Yew Lin 2004 年的原始论文《ROUGE: A Package for Automatic Evaluation of Summaries》,这是所有知识的源头。
2. **实践阶段**:在 Hugging Face `datasets` 和 `evaluate` 库中动手运行代码,尝试在 CNN/DailyMail 数据集上复现经典模型的 ROUGE 分数。
3. **深入阶段**:研究《The Problem with ROUGE》等批判性文章,理解指标的局限性,并学习如何结合 BERTScore 和人工评估设计综合评测方案。
4. **前沿阶段**:关注每年 ACL、EMNLP、NAACL 会议中关于"NLG Evaluation"的 Tutorial 和 Workshop,追踪 LLM-as-a-Judge 等最新评估范式。
### 推荐资源与文献
* **原始论文**:Lin, C. Y. (2004). *ROUGE: A Package for Automatic Evaluation of Summaries*. In Text Summarization Branches Out.
* **权威教程**:Hugging Face Course - Chapter on Evaluation Metrics. (免费在线课程,含代码实战)
* **综述文章**:Celikyilmaz, A., et al. (2020). *Evaluation of Text Generation: A Survey*. arXiv preprint. (全面梳理了从 ROUGE 到最新神经评估指标的发展脉络)
* **开源工具**:`rouge-score` (Python 包), `NLTK` (Natural Language Toolkit), `SacreBLEU` (虽然名为 BLEU,但其设计理念对理解标准化评估极具参考价值)。
通过上述内容的层层剖析,我们相信您不仅知道了"ROUGE 是什么”,更理解了它在 AI 技术发展长河中的坐标、它的运作机理以及它在未来的演变方向。在这个数据驱动的时代,掌握评估指标,就是掌握了衡量智能进化的尺子。





