
工具/模型介绍
2024 年 8 月,由前 Stable Diffusion 核心创始团队组建的 Black Forest Labs 正式推出了 FLUX.1 系列模型。作为开源社区的新晋“顶流”,FLUX.1 并非简单的迭代升级,而是一次架构层面的彻底重构。它定位为新一代高分辨率、高保真度的文生图基础模型,旨在解决长期以来开源模型在手指细节、文字渲染及复杂指令遵循上的痛点。在 Midjourney v6 和 DALL-E 3 垄断高质量生成市场的背景下,FLUX.1 的问世标志着开源生态终于拥有了能与闭源商业模型正面抗衡的强力武器,极大地降低了高品质 AI 创作的门槛。
核心创新
FLUX.1 的核心突破在于其独特的混合架构设计。它摒弃了传统的纯 U-Net 结构,转而采用结合了多模态并行注意力层(Multimodal Parallel Attention Layers)的 Flow Matching 变压器架构。这一变革带来了三大显著优势:首先是卓越的语义理解能力,模型能够精准解析长达数百字的复杂提示词,不再遗漏关键细节;其次是原生支持高分辨率输出,无需依赖额外的放大插件即可生成细节丰富的 1024x1024 甚至更高分辨率图像;最后是革命性的文字渲染能力,FLUX.1 能准确地在图片中生成可读的英文单词和短语,这是此前开源模型难以企及的高度。相比 SDXL,FLUX.1 在人体解剖结构(如手部、牙齿)的准确性上提升了数个量级,几乎消除了“多指”或“畸形”现象。
功能详解
精准文字渲染与排版
FLUX.1 最引人注目的功能是其在图像中嵌入文字的能力。用户只需在提示词中明确指定需要出现的文本内容(例如:"a neon sign saying 'OPEN'"),模型便能以正确的拼写、字体风格将其融入场景光影中。这一功能对于海报设计、Logo 构思及电商素材制作具有颠覆性意义,大幅减少了后期 PS 修图的工作量。

复杂指令遵循与逻辑推理
得益于强大的语言对齐能力,FLUX.1 能够处理包含多重约束条件的复杂指令。例如,用户可以要求“一个穿着红色雨衣的女孩站在左侧,右侧是一只蓝色的猫,背景是雨夜的东京街道”。模型不仅能准确分配左右位置,还能正确对应角色与服饰颜色,展现出极强的空间逻辑推理能力,避免了传统模型常见的属性混淆问题。
多样化版本适配
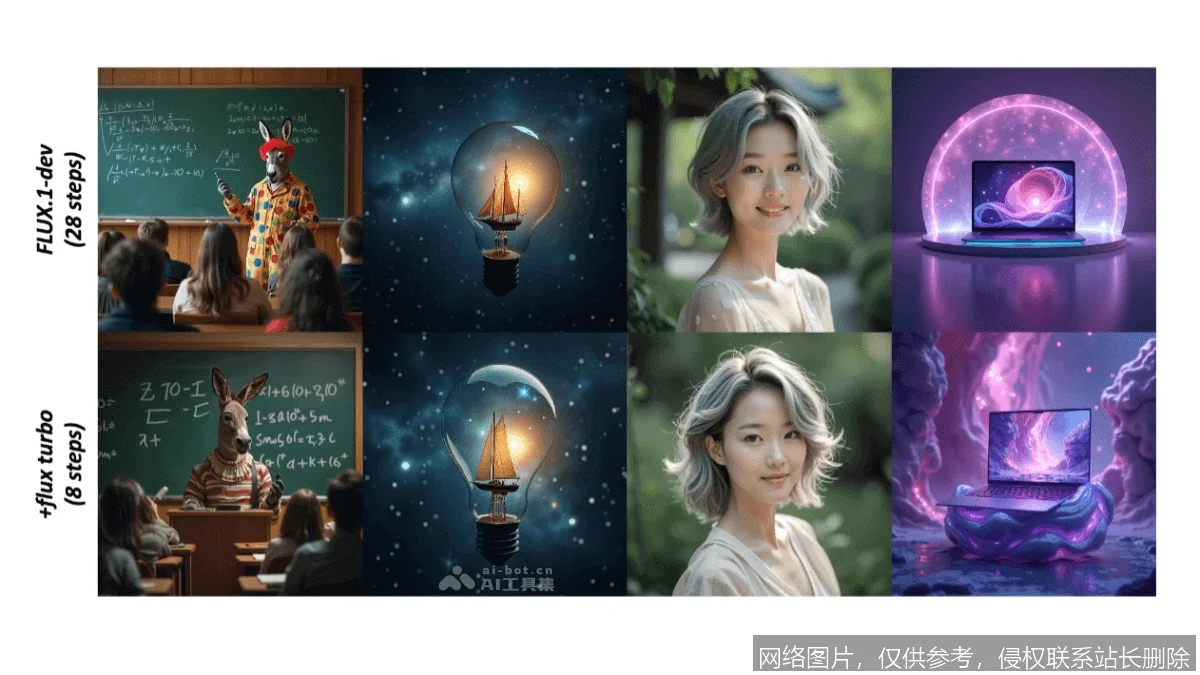
FLUX.1 提供了三个主要版本以满足不同需求:FLUX.1 [pro] 提供最高画质,适合专业商业创作;FLUX.1 [dev] 为非商业用途开放权重,平衡了质量与速度;FLUX.1 [schnell] 则采用了蒸馏技术,仅需 1-4 步采样即可出图,专为本地快速部署和实时交互设计。用户可根据算力资源和应用场景灵活选择。
使用场景
FLUX.1 的应用场景极为广泛。对于平面设计师和广告从业者,它是生成带文案宣传图的神器;对于游戏开发者,可利用其快速构建风格统一的角色立绘和场景概念图;对于自媒体创作者,它能高效产出无需修图的封面插图。此外,由于其开源特性,开发者可将其集成到工作流中,结合 ControlNet 等控件进行精细化控制,服务于建筑可视化、时尚设计等专业领域。
上手指南
普通用户可通过 Hugging Face Spaces、Fal.ai 或 Replicate 等云平台直接体验在线版,无需配置环境。对于拥有高性能显卡(推荐显存 16GB 以上,[schnell] 版本可放宽至 8GB)的极客用户,可通过 ComfyUI 或 Forge 本地部署。入门步骤如下:首先安装最新的 ComfyUI 及依赖包,其次从 Hugging Face 下载对应版本的检查点文件放入 models 目录,最后加载官方提供的示例工作流即可开始创作。新手常见问题主要集中在显存不足导致报错,建议优先尝试量化版本(FP8)或使用云端推理服务。
展望
随着社区的迅速发酵,预计未来几个月内将涌现大量针对 FLUX.1 的微调模型(LoRA)和控制网络(ControlNet),进一步拓展其在特定画风和姿态控制上的能力。长远来看,Black Forest Labs 可能会推出支持视频生成的后续版本,实现从静态图像到动态影像的无缝跨越。FLUX.1 的出现不仅是技术的胜利,更预示着开源 AI 绘画将进入一个“可用即完美”的全新时代。





