
一句话定义
反向传播(Backpropagation)是深度学习的核心算法,通过链式法则将误差从输出层逆向传导至输入层,从而高效计算梯度并更新神经网络权重。
技术原理:误差的逆向旅行与权重的精准修正
要理解反向传播(Backpropagation,简称 BP),我们首先必须将其置于“训练”这一宏观背景下。如果把神经网络比作一个正在学习射箭的学徒,那么“前向传播”就是学徒射出一支箭的过程,而“反向传播”则是教练根据箭偏离靶心的程度,倒推回去告诉学徒:你的手腕角度偏了 2 度,手肘抬高了 3 厘米,站姿重心左移了 5 毫米。没有反向传播,神经网络就永远不知道如何调整自己,只能盲目猜测。
1. 核心工作机制:链式法则的数学交响
反向传播的本质,是利用微积分中的链式法则(Chain Rule),高效地计算损失函数(Loss Function)相对于网络中每一个参数(权重 Weight 和偏置 Bias)的梯度(Gradient)。
整个过程可以分为两个截然不同的阶段:
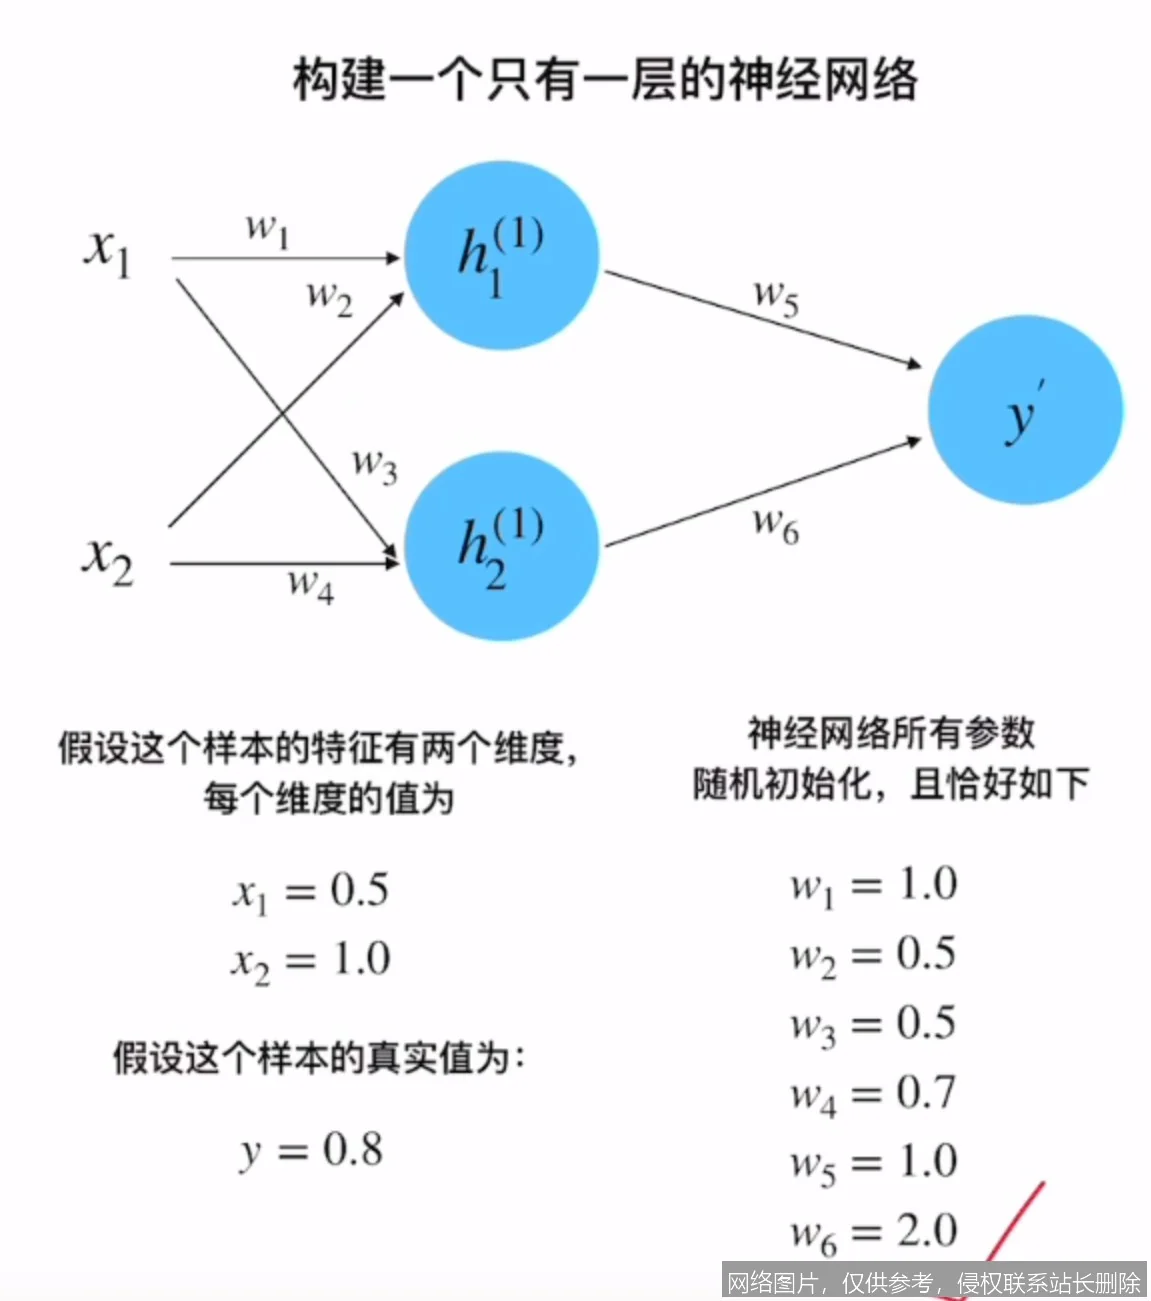
- 前向传播(Forward Pass):数据从输入层进入,经过层层隐藏层的线性变换(矩阵乘法)和非线性激活(如 ReLU、Sigmoid),最终在输出层产生预测结果。此时,我们将预测结果与真实标签(Ground Truth)进行比较,计算出一个标量数值——损失值(Loss)。这个值代表了模型当前犯错的严重程度。
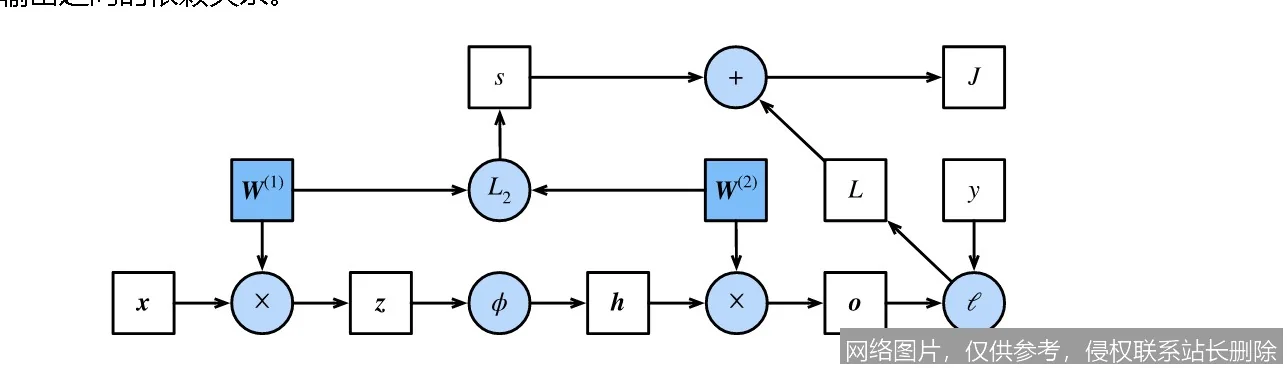
- 反向传播(Backward Pass):这是算法的精髓所在。系统从输出层开始,计算损失函数对输出层参数的偏导数。随后,利用链式法则,将这个误差信号一层一层地向后传递。每一层不仅接收来自后一层的误差信号,还要结合自身的激活函数导数和输入数据,计算出本层参数的梯度。最终,误差信号传导至输入层,整个网络所有参数的梯度都被精确计算出来。
一旦梯度计算完成,优化器(如 SGD、Adam)就会利用这些梯度信息,沿着梯度的反方向(因为我们要最小化损失)更新权重。这就完成了“一次迭代”。
2. 关键技术组件解析
反向传播的高效运行依赖于几个关键组件的精密配合:
- 计算图(Computational Graph):现代深度学习框架(如 PyTorch, TensorFlow)将神经网络的运算过程抽象为有向无环图。图中的节点代表运算(如加法、乘法、激活函数),边代表数据流动。反向传播实际上是在这个图上执行自动微分(Automatic Differentiation),自动追踪每一步运算的导数关系。
- 激活函数的导数:非线性激活函数赋予了神经网络拟合复杂曲线的能力,但在反向传播中,它们的导数至关重要。例如,Sigmoid 函数在两端饱和区导数趋近于零,这曾导致著名的“梯度消失”问题;而 ReLU(Rectified Linear Unit)函数在正区间的导数恒为 1,极大地缓解了这一问题,成为现代深度网络的首选。
- 局部梯度与全局梯度:反向传播巧妙地避免了重复计算。它先计算每个节点的“局部梯度”(即该节点输出对其输入的导数),然后将从上游传回来的“全局梯度”(损失对该节点输出的导数)与局部梯度相乘,得到该节点输入的全局梯度。这种模块化的计算方式使得构建超深网络成为可能。
3. 与传统方法的对比:为何它是革命性的?
在反向传播算法被广泛普及之前(尽管其数学形式在 20 世纪 60-70 年代已出现,但直到 1986 年 Rumelhart 等人的论文才使其家喻户晓),训练多层神经网络主要面临两大困境:
- 数值微分法(Numerical Differentiation):早期的尝试是通过微调每一个权重(例如 $w + \epsilon$),观察损失的变化来估算梯度。如果一个网络有 100 万个参数,就需要进行 100 万次前向传播才能估算出一次完整的梯度方向。这种方法计算复杂度为 $O(N)$,其中 $N$ 是参数数量,对于现代拥有数十亿参数的模型来说,这在计算上是完全不可行的。
- 符号微分法(Symbolic Differentiation):虽然能给出精确的解析解,但生成的表达式往往极其冗长复杂,导致“表达式膨胀”,且难以处理控制流(如循环、条件判断)。
反向传播结合自动微分技术,将计算梯度的复杂度降低到了与前向传播同数量级,即 $O(1)$ 倍的前向传播成本(通常约为 2-3 倍前向传播时间)。这意味着无论网络有多少参数,计算完整梯度的代价仅仅是多做几次矩阵运算。这种效率的飞跃,是深度学习能够从理论走向实践,并引爆 2012 年以后 AI 革命的根本原因。
4. 直观类比:下山指南针
想象你被蒙住双眼扔在一座崎岖的山上(高维损失曲面),你的目标是找到山谷最低点(全局或局部最优解,即最小损失)。
前向传播就像是你用脚试探当前位置的高度(计算 Loss)。
反向传播则是你用手触摸周围的地面,感受哪里的坡度最陡,以及陡峭的方向指向哪里(计算 Gradient)。你不需要把整座山测绘一遍,只需要感知脚下的瞬时斜率。
如果你试图通过“数值微分”来找路,你就需要向四面八方各走一步,测量高度变化,这不仅累而且慢。而反向传播就像是给你配备了一个高精度的数字倾角仪,瞬间告诉你所有方向上的坡度分量,让你能迈出最准确的一步。
核心概念:构建深度学习的术语图谱
深入理解反向传播,需要掌握一系列相互关联的核心术语。这些概念构成了深度学习理论的基石。
1. 关键术语解释
- 梯度(Gradient):一个向量,指向函数值增长最快的方向。在反向传播中,我们计算的是损失函数的梯度,因此我们需要朝梯度的反方向移动权重,以减少损失。
- 学习率(Learning Rate):决定了我们在梯度反方向上迈出的步长大小。学习率过大可能导致在最优解附近震荡甚至发散;学习率过小则会导致收敛速度极慢,容易陷入局部最优。
- 链式法则(Chain Rule):微积分的基本定理,$(f \circ g)'(x) = f'(g(x)) \cdot g'(x)$。它是反向传播能够将深层网络的误差分解为每一层误差的数学基础。
- 梯度消失(Vanishing Gradient):在深层网络中,如果激活函数选择不当(如 Sigmoid),连乘的导数项可能变得极小,导致靠近输入层的权重几乎得不到更新,网络无法训练。
- 梯度爆炸(Exploding Gradient):与消失相反,连乘的导数项变得极大,导致权重更新幅度过大,模型参数溢出(NaN),训练崩溃。常见于 RNN(循环神经网络)中。
- 自动微分(Automatic Differentiation, Autodiff):现代深度学习框架实现反向传播的技术手段。它不同于符号微分和数值微分,通过在代码运行时记录运算轨迹(Tape),动态构建计算图并应用链式法则。
2. 概念关系图谱
为了理清这些概念的逻辑流向,我们可以构建如下的逻辑链条:
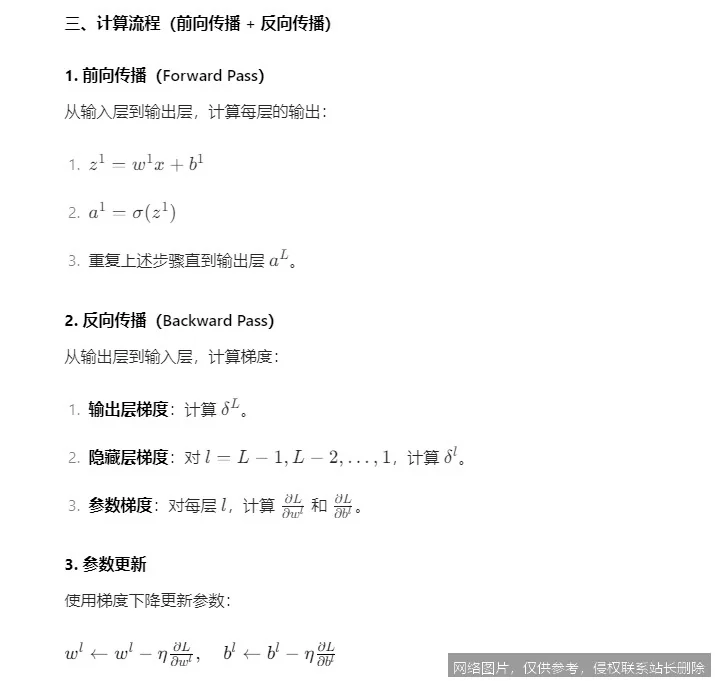
数据输入 $\rightarrow$ 前向传播 (生成预测) $\rightarrow$ 损失函数 (计算误差) $\rightarrow$ 反向传播 (应用链式法则) $\rightarrow$ 梯度计算 $\rightarrow$ 优化器 (结合学习率) $\rightarrow$ 权重更新 $\rightarrow$ (循环回到前向传播)
在这个闭环中,反向传播是连接“误差评估”与“参数修正”的桥梁。没有它,损失函数只是一个冰冷的数字,无法转化为模型进化的动力。
3. 常见误解澄清
误解一:反向传播就是梯度下降。
澄清:这是两个不同但紧密相关的概念。反向传播是一种算法,用于计算梯度;而梯度下降(Gradient Descent)是一种优化策略,用于利用计算出的梯度来更新参数。你可以使用反向传播计算梯度,然后使用牛顿法、L-BFGS 等其他优化器来更新参数,不一定非要用梯度下降。
误解二:反向传播只适用于全连接网络。
澄清:反向传播是一种通用的微分规则,适用于任何可微的计算图。无论是卷积神经网络(CNN)中的卷积操作,还是 Transformer 中的注意力机制(Attention Mechanism),甚至是图神经网络(GNN),只要运算过程是可微的,都可以应用反向传播来计算梯度。
误解三:反向传播能保证找到全局最优解。
澄清:由于神经网络的损失曲面通常是非凸的(Non-convex),存在大量的局部极小值和鞍点。反向传播结合梯度下降通常只能找到局部最优解,或者在某些情况下卡在鞍点。不过,研究表明在高维空间中,高质量的局部最优解往往已经足够好,且鞍点问题可以通过动量(Momentum)等技术缓解。
实际应用:从理论到 2026 年的产业落地
反向传播不仅是教科书上的公式,它是驱动当今人工智能浪潮的引擎。从智能手机的人脸解锁到自动驾驶汽车,再到 2026 年展望中的通用人工智能雏形,反向传播无处不在。
1. 典型应用场景
- 计算机视觉(Computer Vision):在图像分类、目标检测和语义分割任务中,CNN 通过反向传播不断调整卷积核的权重,学会提取边缘、纹理乃至物体部件的特征。例如,医疗影像诊断系统通过反向传播训练,能够识别微小的肿瘤病灶。
- 自然语言处理(NLP):从早期的 RNN、LSTM 到如今的 Transformer 架构(如 BERT, GPT 系列),反向传播使得模型能够理解上下文语境、语法结构甚至情感色彩。在大语言模型(LLM)的预训练阶段,数千亿次反向传播迭代让模型掌握了人类语言的统计规律。
- 强化学习(Reinforcement Learning):在 AlphaGo 等系统中,策略网络和价值网络的训练同样依赖反向传播。通过将奖励信号(Reward)转化为损失函数,智能体学会了在复杂的博弈环境中做出最优决策。
- 生成式 AI(Generative AI):扩散模型(Diffusion Models)和 GAN(生成对抗网络)的训练极度依赖反向传播。在扩散模型中,网络学习逆转噪声过程,这需要精确计算去噪步骤的梯度;在 GAN 中,生成器和判别器通过交替的反向传播进行“博弈”,最终生成逼真的图像或视频。
2. 代表性产品与项目案例
- PyTorch & TensorFlow:作为全球最主流的深度学习框架,它们的核心功能就是自动构建计算图并执行反向传播。开发者只需定义前向逻辑,框架会自动处理繁琐的梯度计算,极大地降低了 AI 开发门槛。
- Hugging Face Transformers:这个库封装了基于 Transformer 架构的各种预训练模型。用户在进行微调(Fine-tuning)时,底层自动调用反向传播算法,使企业能够快速将通用的 LLM 适配到客服、法律、医疗等垂直领域。
- NVIDIA CUDA & cuDNN:硬件层面的优化。反向传播涉及海量的矩阵运算,NVIDIA 的 GPU 加速库针对反向传播中的卷积、矩阵乘法等操作进行了极致优化,使得训练大模型的时间从数年缩短至数周甚至数天。
3. 使用门槛与条件
尽管反向传播已被封装得极其易用,但要高效应用仍需满足一定条件:
- 可微性要求:网络中的所有操作必须是可微的(或至少次梯度可求)。这意味着传统的离散操作(如硬阈值、不可导的排序)需要经过特殊处理(如使用 Straight-Through Estimator)才能融入反向传播流程。
- 显存限制:反向传播需要存储前向传播过程中的中间激活值(Activations),以便在反向时计算导数。对于超深、超宽的网络,这会导致巨大的显存占用。这也是为什么训练大模型需要昂贵的 A100/H100 显卡,以及催生了“梯度检查点(Gradient Checkpointing)”等显存优化技术的原因。
- 数据质量与规模:反向传播是基于数据驱动的。如果训练数据存在严重偏差、噪声过大或规模不足,反向传播只会让模型更快地过拟合错误或学到偏见(Garbage In, Garbage Out)。
4. 2026 年深度学习应用展望
展望未来,反向传播的应用形态将发生深刻演变:
- 端侧实时训练:随着移动端 NPU 算力的提升和量化技术的成熟,2026 年我们将看到更多设备支持“在线反向传播”。手机、汽车将在本地根据用户习惯实时微调模型,而无需上传数据云端,彻底解决隐私问题。
- 物理信息神经网络(PINNs):反向传播将与物理定律深度融合。在流体力学、材料科学领域,损失函数将不再仅仅是数据误差,还将包含物理方程的残差。反向传播将用于求解复杂的偏微分方程,加速科学发现。
- 神经形态计算与脉冲神经网络(SNN):传统的反向传播依赖于连续值,而类脑芯片采用脉冲信号。新的替代训练算法(如代理梯度法 Surrogate Gradient)将模拟反向传播的思想,在低功耗的类脑硬件上实现高效学习,推动 AI 向绿色计算转型。
- 自动化机器学习(AutoML)的深化:反向传播不仅用于训练权重,还将用于搜索网络架构本身(NAS, Neural Architecture Search)。通过对架构参数的梯度下降,AI 将自动设计出比人类专家更高效的网络结构。
延伸阅读:通往高阶之路
反向传播是进入深度学习殿堂的钥匙,但门后的世界更加广阔。以下是为希望进一步深造的学习者准备的进阶指南。
1. 相关概念推荐
- 优化算法进阶:深入研究 Adam, RMSprop, AdaGrad, Lion 等优化器的原理及其在不同场景下的表现。
- 正则化技术:了解 Dropout, Batch Normalization, Layer Normalization 如何与反向传播协同工作,防止过拟合并加速收敛。
- 二阶优化方法:探索 Hessian 矩阵、K-FAC 等利用二阶导数信息的优化方法,理解它们在收敛速度上的优势及计算成本。
- 元学习(Meta-Learning):研究“学习如何学习”,如 MAML 算法,其核心也是嵌套的反向传播过程。
2. 进阶学习路径
- 数学基础夯实:重温多元微积分(偏导数、雅可比矩阵)、线性代数(矩阵分解、特征值)和概率论。
- 框架源码阅读:不要只停留在调用 API。尝试阅读 PyTorch 的
autograd引擎源码或 TensorFlow 的 GradientTape 实现,理解计算图是如何构建和遍历的。 - 从零实现:仅使用 NumPy,不依赖任何深度学习框架,手动实现一个包含反向传播的多层感知机(MLP)和简单的 CNN。这是检验是否真正理解原理的“试金石”。
- 前沿论文追踪:关注 NeurIPS, ICML, ICLR 等顶级会议中关于优化、高效训练和新型架构的论文。
3. 推荐资源与文献
- 经典论文:
- Rumelhart, D. E., et al. (1986). "Learning representations by back-propagating errors." Nature. (反向传播的奠基之作)
- Kingma, D. P., & Ba, J. (2014). "Adam: A Method for Stochastic Optimization." (现代最常用的优化器)
- Ioffe, S., & Szegedy, C. (2015). "Batch Normalization: Accelerating Deep Network Training..." (解决内部协变量偏移的关键技术)
- 经典教材:
- Deep Learning by Ian Goodfellow, Yoshua Bengio, and Aaron Courville. (被誉为深度学习圣经,第 6 章详细讲解了深度前馈网络与反向传播)
- Pattern Recognition and Machine Learning by Christopher M. Bishop. (从贝叶斯视角审视机器学习)
- 在线课程:
- Coursera: Deep Learning Specialization by Andrew Ng. (吴恩达教授的系列课程,直观易懂)
- Stanford CS231n: Convolutional Neural Networks for Visual Recognition. (李飞飞团队课程,深入讲解反向传播在视觉中的应用)
反向传播作为人工智能领域的“心脏起搏器”,每一次权重的跳动都推动着智能的进化。从 1986 年的理论复兴到 2026 年的泛在应用,它证明了简单而优雅的数学思想所能爆发的巨大能量。对于每一位 AI 从业者而言,深刻理解反向传播,不仅是掌握一项技术,更是领悟机器如何从数据中“习得”智慧的第一课。





