
一句话定义
召回(Recall)是从海量数据中快速筛选出与用户查询潜在相关的候选集,是推荐系统与搜索引擎解决“大海捞针”问题的第一道关键防线。
在人工智能与信息检索的宏大叙事中,“召回是什么”不仅仅是一个技术术语的追问,更是理解现代数字生活如何高效运转的钥匙。当我们打开抖音刷到停不下来的视频,或在淘宝搜索一件商品瞬间获得成千上万个结果时,背后正是“召回”机制在毫秒级时间内完成了从亿级数据库到百级候选集的精准提炼。本文将深入 2026 年的技术视野,全方位解析召回的核心原理、概念图谱、多领域应用及未来演进路径。
技术原理:从大海捞针到精准撒网
要真正理解召回(Recall),我们首先需要打破一个常见的直觉误区:很多人认为搜索或推荐就是直接给出一个最完美的答案。事实上,在现代大规模 AI 系统中,直接对全量数据进行精细化排序是不现实的。想象一下,如果你要在拥有 100 亿本书的图书馆里找一本关于"2026 年火星殖民”的书,如果每一本都拿出来仔细阅读目录再决定是否推荐,哪怕每本书只花 1 毫秒,也需要整整 300 多年。这显然是不可接受的。
因此,召回的核心工作机制可以概括为"粗筛"。它的任务不是选出“最好”的那一个,而是以极快的速度,从海量的物品池(Item Pool)中,找出所有“可能相关”的子集。这个过程通常将候选集的数量从亿级(10^8)压缩到千级(10^3)或百级(10^2),为后续的“排序(Ranking)”阶段提供高质量的输入。
核心工作机制解析
在 2026 年的技术语境下,召回系统的工作流已经高度智能化和多元化,但其底层逻辑依然遵循着“表征 - 匹配 - 截断”的三步走战略:
- 向量化表征(Vector Representation):这是召回的基石。无论是用户的搜索词、历史行为,还是库中的商品、视频内容,都被通过深度学习模型(如 Transformer 架构的变体)映射到高维向量空间中的一个点。在这个空间里,语义相似的内容,其向量距离也更近。例如,“苹果”和“水果”的向量距离,会远小于“苹果”和“手机”的距离(除非在特定语境下)。
- 近似最近邻搜索(Approximate Nearest Neighbor Search, ANNS):一旦所有数据变成了向量,问题就转化为了数学上的几何问题:在多维空间中找到离用户向量最近的 K 个点。由于数据量巨大,精确计算所有距离依然太慢,因此工业界普遍采用 ANNS 算法(如 HNSW、Faiss 索引等)。这些算法通过构建特殊的图结构或树结构,牺牲极小的精度换取了千倍以上的速度提升,实现了毫秒级的响应。
- 多路融合与截断(Fusion & Truncation):单一的召回策略往往存在盲区。现代系统通常采用“多路召回”策略,即同时运行基于内容的召回、基于协同过滤的召回、基于热点的召回等多条链路。最后,将这些不同来源的结果进行去重、加权融合,并截取前 N 个结果进入下一环节。
关键技术组件说明
构建一个高效的召回系统,离不开以下几个关键技术组件的协同工作:
- 双塔模型(Two-Tower Model):这是目前主流的召回模型架构。它包含两个独立的神经网络塔:用户塔(User Tower)和用户特征输入,物品塔(Item Tower)和物品特征输入。两个塔分别输出用户向量和物品向量,最终通过计算两者的点积或余弦相似度来判断匹配程度。这种结构的优势在于物品向量可以离线预先计算并存储,线上只需实时计算用户向量,极大地降低了延迟。
- 向量数据库(Vector Database):随着非结构化数据的爆发,传统的關係型数据库已无法胜任向量检索任务。专用的向量数据库(如 Milvus, Pinecone, Weaviate 等)成为了基础设施,它们专门优化了高维向量的存储、索引和查询效率,支持动态更新和大规模并发。
- 嵌入模型(Embedding Models):这是召回系统的“大脑”。从早期的 Word2Vec 到 2026 年广泛使用的多模态大语言模型(Multimodal LLMs)嵌入层,嵌入模型的质量直接决定了召回的上限。最新的嵌入模型不仅能理解文本,还能同时理解图像、音频甚至视频帧的语义,实现了真正的跨模态召回。
与传统方法的对比
回顾历史,我们可以清晰地看到召回技术的演进脉络。早期的信息检索主要依赖倒排索引(Inverted Index)和关键词匹配(如 TF-IDF, BM25)。这种方法就像查字典,必须严格匹配关键词。如果你搜“轿车”,而文章里只写了“汽车”,传统方法可能就漏掉了。
相比之下,基于深度学习的向量召回具有革命性的优势:
| 维度 | 传统关键词召回 | 现代向量召回 (2026 主流) |
|---|---|---|
| 匹配逻辑 | 字面匹配,硬规则 | 语义匹配,软关联 |
| 泛化能力 | 弱,无法处理同义词、近义词 | 强,能理解“土豆”和“马铃薯”是同一概念 |
| 冷启动 | 极度困难,无行为数据无法推荐 | 较好,可通过内容特征(图片、文本描述)直接生成向量 |
| 跨模态 | 几乎不可能 | 原生支持,可用文字搜图片,用图片搜视频 |
用一个生动的类比来说:传统关键词召回像是在图书馆里按书名首字母找书,你必须知道确切的名字;而现代向量召回则像是雇佣了一位博古通今的图书管理员,你只需要描述“我想找一本关于孤独和海洋的小说”,他就能凭直觉把《老人与海》或其他意境相似的书放到你面前,哪怕书名里根本没有这些词。
核心概念:构建召回的知识图谱
在深入探讨“召回是什么”之后,我们需要厘清围绕这一概念的一系列关键术语。这些概念构成了召回技术的知识图谱,也是初学者最容易混淆的地方。
关键术语解释
1. 召回率(Recall Rate)vs. 准确率(Precision)
这是评估召回效果的两个核心指标,也是一对永恒的矛盾体。
- 召回率(Recall):指在所有真正相关的物品中,被系统成功找出来的比例。公式为:$Recall = \frac{TP}{TP + FN}$。高召回率意味着“宁错杀一千,不放过一个”,力求把所有可能的好东西都捞出来。
- 准确率(Precision):指在系统找出来的物品中,真正相关的比例。公式为:$Precision = \frac{TP}{TP + FP}$。
在召回阶段,我们通常更看重召回率。因为召回只是第一步,漏掉的好东西后面再也找不回来了(假阴性 FN 是致命的),而多捞进来的无关物品(假阳性 FP)可以在后续的排序阶段被过滤掉。
2. 多路召回(Multi-channel Recall)
指同时使用多种不同的策略或模型进行召回。常见的通路包括:
- 基于内容的召回(Content-based):利用物品的标签、描述、类别等属性,寻找与用户当前兴趣相似的物品。
- 协同过滤召回(Collaborative Filtering, CF):基于“物以类聚,人以群分”的思想。包括 User-CF(喜欢这个的人也喜欢那个)和 Item-CF(买了这个的人通常也买那个)。
- 基于图的召回(Graph-based):利用知识图谱或用户行为图,通过随机游走(Random Walk)等算法发现深层关联。
- 热门/新品召回:保证流量分发的高效性和新鲜度,避免长尾效应导致的马太效应。
3. 向量相似度(Vector Similarity)
衡量两个向量接近程度的数学方法。最常用的有:
- 余弦相似度(Cosine Similarity):计算两个向量夹角的余弦值,忽略长度,只看方向。适用于文本等稀疏向量。
- 欧氏距离(Euclidean Distance):计算两点间的直线距离。适用于物理意义明确的密集向量。
- 点积(Dot Product):在双塔模型训练中常用,计算效率最高。
概念之间的关系图谱
为了更直观地理解,我们可以将召回系统看作一个漏斗的上半部分:
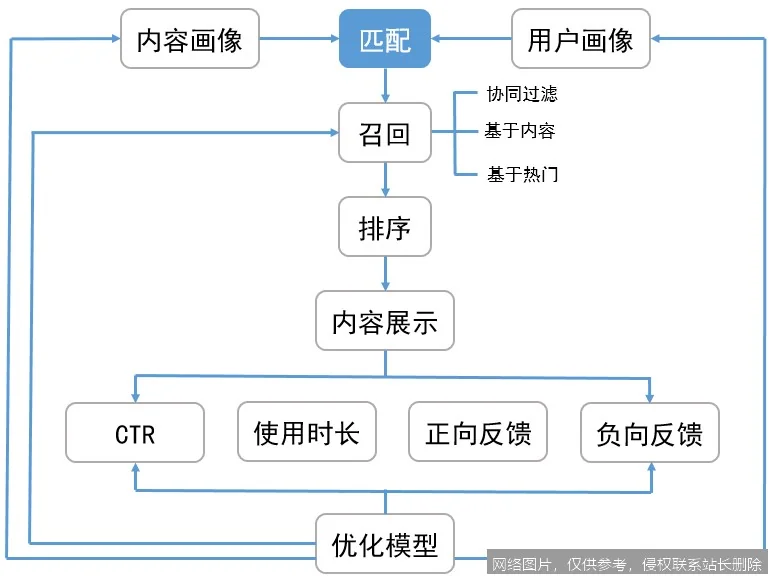
- 输入层:用户画像(User Profile)、上下文环境(Context)、查询语句(Query)。
- 策略层(多路召回):并行运行上述提到的各种召回算法。每一路都是一个独立的过滤器,从全量池中捞取一部分候选。
- 融合层:将各路结果合并,进行去重(Deduplication)和初步打分(Scoring)。
- 输出层:Top-K 候选集,传递给排序模型(Ranking Model)。
在这个链条中,Embedding是贯穿始终的语言,Index是加速的引擎,而Recall/Precision则是衡量效果的标尺。
常见误解澄清
误解一:“召回就是最终的搜索结果。”
澄清:绝对不是。召回只是海选。如果你在电商网站搜索“跑鞋”,召回可能会返回 2000 双相关的鞋子,但最终展示在你面前的只有几十双。那几十双是经过复杂的排序模型(考虑价格、销量、个性化偏好、广告竞价等几百个特征)精挑细选后的结果。召回负责“广撒网”,排序负责“收好鱼”。
误解二:“向量越复杂,召回效果越好。”
澄清:不一定。向量维度过高会导致“维度灾难”,不仅增加存储和计算成本,还可能引入噪声。此外,过深的模型可能导致过拟合,泛化能力下降。2026 年的趋势是追求“小而美”的蒸馏模型,在保证语义表达能力的前提下,尽可能降低向量维度和模型复杂度,以适应端侧部署。
误解三:“召回只能用于推荐系统。”
澄清:虽然推荐系统是召回的大本营,但召回技术广泛应用于搜索引擎、广告投放、风控系统(快速筛选可疑交易)、甚至生物信息学(基因序列匹配)等领域。凡是涉及“从大规模数据集中快速查找相似项”的场景,都有召回的身影。
实际应用:从理论到落地的全景扫描
理解了原理和概念,我们来看看“召回是什么”在现实世界中是如何改变各行各业的。2026 年,随着大模型(LLM)与检索增强生成(RAG)技术的成熟,召回的应用边界得到了前所未有的拓展。
典型应用场景列举
1. 电商推荐与搜索
这是召回技术最成熟的战场。当你在淘宝或亚马逊浏览时,后台每秒都在进行数以亿计的召回计算。
- 场景:用户点击了一双耐克跑鞋。
- 召回动作:Item-CF 立即召回其他用户买过这双鞋后常买的袜子、护膝;基于内容的召回找到同品牌、同价位、同风格的其他跑鞋;基于向量的语义召回找到“适合马拉松训练的专业运动鞋”。
- 价值:直接提升转化率(CVR)和客单价,减少用户流失。
2. 短视频与内容流(Feed 流)
抖音、TikTok、快手等平台的核心竞争力就在于其极致的召回效率。
- 场景:用户在午夜时分频繁点赞宠物视频。
- 召回动作:系统实时捕捉这一行为序列,通过序列模型(如 SASRec, BERT4Rec)召回相似的萌宠内容,同时结合地理位置召回本地的宠物店探店视频。由于视频库高达数十亿,必须在 50ms 内完成召回,否则用户就会划走。
3. 检索增强生成(RAG)与大模型应用
这是 2024-2026 年最火爆的应用方向。大语言模型虽然博学,但存在幻觉且知识截止。RAG 通过召回外部知识库来弥补这一缺陷。
- 场景:企业员工询问公司内部最新的报销政策。
- 召回动作:系统将员工的问题转化为向量,在企业内部的 PDF、Wiki、邮件数据库中召回最相关的几个文档片段(Chunks),然后将这些片段作为上下文(Context)喂给大模型,让大模型基于事实生成答案。
- 价值:解决了大模型的幻觉问题,实现了私有知识的即时问答。
4. 广告精准投放
- 场景:广告主希望将新款游戏广告投给潜在玩家。
- 召回动作:从数亿活跃用户中,快速召回那些过去一个月玩过类似游戏、关注过游戏主播、或在游戏论坛活跃的用户群。这里的召回更注重效率,因为广告竞价需要在毫秒级内完成决策。
代表性产品/项目案例
- Netflix 的推荐系统:Netflix 公开过其技术架构,采用了复杂的混合召回策略。他们不仅利用观看历史,还利用微标签(Micro-tags,如“黑暗氛围”、“强势女主角”)进行细粒度的内容召回,确保用户总能找到符合当下口味的电影。
- Facebook FAISS:由 Meta(原 Facebook)开源的向量检索库。它是目前工业界使用最广泛的召回基础设施之一,支撑了 Instagram 的图片搜索、Facebook 的帖子推荐等核心业务。FAISS 的出现极大地降低了向量检索的技术门槛。
- LangChain + Vector Store:在 AI 应用开发领域,LangChain 框架结合各类向量数据库(如 Chroma, Pinecone),成为了构建 RAG 应用的标准范式。开发者只需几行代码,就能为自己的文档库赋予强大的语义召回能力。
使用门槛和条件
虽然召回技术强大,但要落地并非零门槛:
- 数据质量:“垃圾进,垃圾出”。如果物品缺乏清晰的元数据(标签、描述),或者用户行为数据稀疏,向量模型很难学到有效的表征。冷启动问题依然是挑战。
- 算力成本:训练高质量的 Embedding 模型和维护大规模的向量索引需要显著的 GPU 算力和内存资源。对于中小企业,直接使用云厂商的托管服务可能是更经济的选择。
- 工程复杂度:构建一个低延迟、高可用的召回系统涉及分布式计算、实时流处理、索引更新等多个工程难题。如何平衡在线服务的延迟(Latency)和召回的覆盖率(Coverage)是一门艺术。
延伸阅读:通往专家之路
如果你对“召回是什么”有了基础认知,并希望进一步深耕这一领域,以下的学习路径和资源将助你一臂之力。
相关概念推荐
召回不是孤立存在的,建议联动学习以下概念以形成完整知识体系:
- 排序学习(Learning to Rank, LTR):了解召回之后的步骤,学习如何使用 Pointwise, Pairwise, Listwise 方法进行精细排序。
- 对比学习(Contrastive Learning):这是当前训练高质量 Embedding 模型的核心方法论(如 SimCSE, CLIP),理解它有助于掌握如何让向量空间分布更合理。
- 图神经网络(Graph Neural Networks, GNN):了解如何利用图结构挖掘用户与物品之间的高阶连接,提升召回的泛化能力。
- 重排序(Re-ranking):在排序之后,为了多样性、新颖性或业务规则进行的最后一次调整。
进阶学习路径
- 入门阶段:掌握基础的统计学知识和机器学习算法(逻辑回归、决策树)。阅读经典的协同过滤论文,理解矩阵分解(Matrix Factorization)。
- 进阶阶段:深入学习深度学习框架(PyTorch/TensorFlow)。研读双塔模型(DSSM)、Wide&Deep、DeepFM 等经典推荐模型论文。动手实践 Faiss 或 Milvus,搭建一个简单的向量检索 Demo。
- 高阶阶段:关注前沿顶会(KDD, RecSys, SIGIR, NeurIPS)的最新论文。研究大模型在召回中的应用(LLM as Retriever)、多模态召回、以及端到端的推荐系统架构。尝试在大规模数据集上进行实战调优。
推荐资源和文献
- 经典论文:
- Deep Structured Semantic Models (DSSM) - Microsoft Research (双塔模型的奠基之作)
- Neural Collaborative Filtering - He et al. (神经协同过滤)
- Billion-scale Commodity Embedding for E-commerce Recommendation - Alibaba (工业界大规模应用的典范)
- 开源项目:
- FAISS (Facebook AI Similarity Search): 向量检索的瑞士军刀。
- RecBole: 一个全面、统一、高效的推荐系统库,包含了大量召回和排序算法的实现。
- Milvus / Zilliz: 云原生向量数据库,适合生产环境部署。
- 书籍:
- 《推荐系统实践》- 项亮(中文经典,适合入门)
- Recommender Systems Handbook(学术界权威参考书)
- Deep Learning for Search(专注于搜索与召回的深度学习应用)
结语:
召回,作为连接用户意图与海量信息的桥梁,其重要性在数据爆炸的时代愈发凸显。从最初的关键词匹配到如今基于大模型的语义理解,召回技术正在经历一场深刻的变革。对于每一位 AI 从业者和爱好者而言,深刻理解“召回是什么”,不仅是掌握一项技术,更是洞察未来智能世界运行逻辑的关键视角。希望在 2026 年及更远的未来,你能运用这些知识,构建出更懂人心、更高效的信息分发系统。





