
一句话定义
AutoGPT 是一个基于大语言模型的开源自主智能体框架,它能将宏观目标拆解为子任务,通过自我规划、执行与反思,无需人工干预即可独立闭环完成复杂工作。
技术原理:从“对话者”到“行动者”的进化
要理解 AutoGPT 是什么,我们首先必须厘清它与传统聊天机器人(Chatbot)的本质区别。如果把传统的大语言模型(LLM)比作一位博学但被动的“顾问”,你问它答,你不问它便沉默;那么 AutoGPT 则是一位拥有高度自主权的“项目经理”。它不仅具备知识,更具备了“手脚”和“大脑”的协同能力,能够主动思考下一步该做什么,并真正去执行。
### 核心工作机制:感知 - 规划 - 行动 - 反思循环
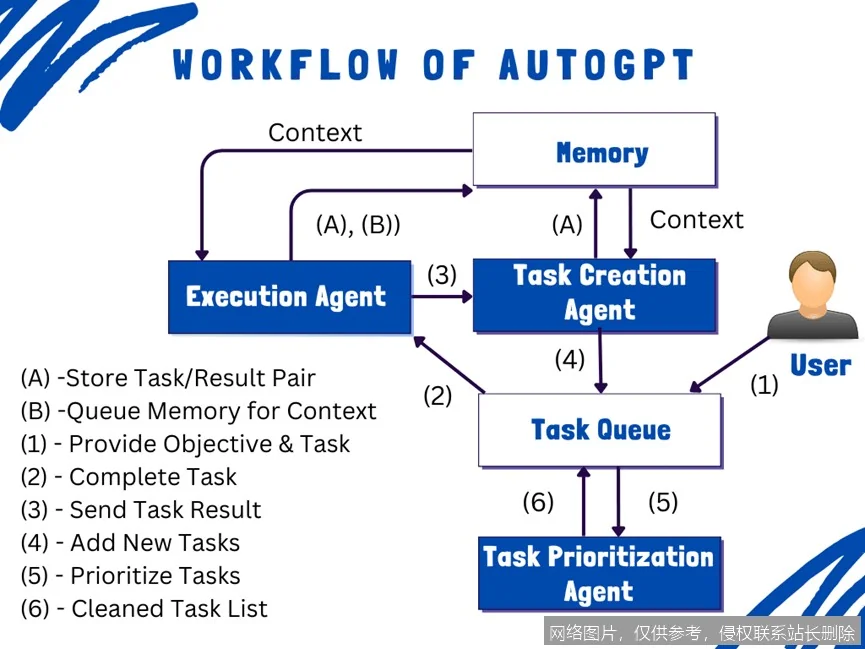
AutoGPT 的核心灵魂在于其独特的**自主代理循环(Autonomous Agent Loop)**。这一机制打破了单次提示词(Prompt)的限制,构建了一个持续运行的反馈系统。其工作流程可以概括为以下四个阶段的无限循环:
1. **感知与目标解析(Perception & Goal Parsing)**:
用户输入一个宏观目标(例如:“调研竞争对手最新的产品策略并生成一份报告”)。AutoGPT 首先利用 LLM 的理解能力,将这个模糊的宏大目标拆解为一系列具体的、可执行的子任务列表(Task List)。此时,它不仅仅是理解语义,更是在构建一个初步的“作战地图”。
2. **规划与决策(Planning & Decision Making)**:
在每一个时间步(Time Step),智能体会审视当前的任务列表、已有的记忆上下文以及外部环境的状态。它会利用 LLM 的推理能力决定:“当前最优先的任务是什么?”、“我需要调用什么工具?”、“我是否已经掌握了足够的信息?”。这一步骤类似于人类大脑的前额叶皮层在进行执行功能控制。
3. **行动与工具调用(Action & Tool Execution)**:
这是 AutoGPT 区别于普通对话模型的关键。一旦做出决策,它不会仅仅生成文本回复,而是生成结构化的命令(Command),调用外部工具(Tools/Plugins)。这些工具包括但不限于:
* **互联网访问**:使用搜索引擎获取实时信息。
* **文件系统操作**:读取、写入、保存本地文件。
* **代码执行**:编写 Python 脚本并在沙箱环境中运行,以处理数据或进行计算。
* **API 交互**:调用第三方服务(如发送邮件、查询数据库)。
执行结果会被捕获,转化为自然语言或结构化数据,作为新的输入反馈给系统。
4. **反思与迭代(Reflection & Iteration)**:
行动结束后,智能体进入反思阶段。它会评估行动的结果是否达到了预期?是否出现了错误?是否需要调整策略?如果任务失败,它会分析原因(是搜索关键词不对?还是代码有 Bug?),然后自动修正计划,重新进入循环。如果子任务完成,它会将成果存入长期记忆,并标记该任务为“已完成”,进而触发下一个子任务。
这个循环会一直持续,直到所有子任务完成,或者达到预设的最大迭代次数,最终向用户交付完整的成果。
### 关键技术组件解析
支撑上述循环运转的,是几个精密配合的技术组件,它们共同构成了 AutoGPT 的骨架:
* **大语言模型内核(LLM Core)**:通常基于 GPT-4 或同等能力的开源模型。它是系统的“大脑”,负责所有的逻辑推理、代码生成、自然语言理解和决策制定。它的上下文窗口(Context Window)大小直接决定了智能体能记住多少历史信息。
* **向量数据库(Vector Database)**:如 Pinecone 或 Milvus。由于 LLM 的上下文长度有限,无法记住无限的历史对话和操作记录。AutoGPT 引入向量数据库作为**长期记忆(Long-term Memory)**。它将过去的操作、观察结果和知识点转化为向量嵌入(Embeddings)存储起来。当需要回忆相关信息时,系统通过语义相似度检索(Semantic Search)快速提取关键记忆,从而突破上下文限制,实现跨长周期的任务处理。
* **工具接口层(Tool Interface Layer)**:这是一个标准化的插件系统,定义了智能体如何与外部世界交互。它封装了复杂的 API 调用细节,将其简化为 LLM 可以理解的函数描述(Function Descriptions)。
* **消息总线与状态管理(Message Bus & State Management)**:负责维护整个代理的生命周期状态,确保在多轮循环中,任务的优先级、依赖关系和执行进度井然有序。
### 与传统方法的对比:范式转移
为了更直观地理解 AutoGPT 的技术革新,我们可以将其与传统软件开发及普通 Prompt 工程进行对比:
| 维度 | 传统脚本/程序 | 普通 LLM 对话 (Chat) | AutoGPT (自主智能体) |
| :--- | :--- | :--- | :--- |
| **驱动方式** | 硬编码逻辑 (If-Then) | 用户指令驱动 (User-driven) | 目标驱动 (Goal-driven) |
| **灵活性** | 低,只能处理预设场景 | 中,依赖用户一步步引导 | 高,能动态适应未知情况 |
| **容错性** | 遇到异常通常崩溃 | 遇到错误需用户纠正 | 具备自我反思和修正能力 |
| **工作流** | 线性执行 | 单轮或多轮问答 | 闭环迭代循环 |
| **类比** | 自动流水线机器 | 百科全书式的顾问 | 独立的初级员工 |
**类比理解**:
想象你要做一顿复杂的晚餐。
* **传统脚本**就像一台预设好的洗碗机,你按开始,它只会在固定程序下运转,如果缺了盘子,它就报错停止。
* **普通 LLM**就像一位站在厨房里的厨师顾问。你问“怎么做红烧肉?”,它会告诉你步骤。但你得自己去买菜、切肉、开火。如果你切错了,你得再问它“切错了怎么办?”。
* **AutoGPT**则像是一位雇佣的全职厨师。你只需说“今晚我要吃红烧肉”。它会自己检查冰箱(感知),发现没肉,于是上网下单买菜(行动);收到肉后,发现刀钝了,它会自动去磨刀或寻找替代方案(反思与修正);最后烹饪、装盘并端给你。整个过程,除了最初的目标,你无需介入任何中间环节。
这种从“被动响应”到“主动代理”的转变,标志着 AI 应用范式的重大转移,也是 AutoGPT 技术原理中最具革命性的部分。
核心概念:构建自主智能体的知识图谱
深入理解 AutoGPT 是什么,需要掌握一系列围绕其生态系统的核心术语。这些概念不仅定义了它的功能边界,也揭示了其内部运作的逻辑关系。
### 关键术语解释
1. **智能体(Agent)**:
在 AI 语境下,智能体指任何能够感知环境并通过行动影响环境以实现目标的实体。AutoGPT 中的智能体特指基于 LLM 的软件代理,它具有自主性(Autonomy)、反应性(Reactivity)和社会性(Social Ability,指与其他代理或系统交互)。
2. **思维链(Chain of Thought, CoT)**:
这是一种提示工程技术,引导模型在给出最终答案前,先展示其推理过程。AutoGPT 极度依赖 CoT,因为它需要在每一步决策中显式地输出“思考过程”,例如:“我现在需要搜索信息,因为我不知道竞争对手的名字。”这使得调试和监控成为可能。
3. **上下文窗口(Context Window)**:
指 LLM 一次性能够处理的文本最大长度。这是限制智能体“短期记忆”的关键瓶颈。AutoGPT 通过结合向量数据库来解决这一问题,将不常用的历史移出上下文,仅在需要时召回。
4. **温度参数(Temperature)**:
控制 LLM 输出随机性的参数。在 AutoGPT 的规划阶段,通常需要较高的温度以激发创造性解决方案;而在代码执行或数据提取阶段,则需要较低的温度以确保准确性和确定性。AutoGPT 会根据任务类型动态调整此参数。
5. **人机回环(Human-in-the-Loop, HITL)**:
虽然 AutoGPT 追求全自动,但在高风险操作(如删除文件、发送大量邮件、花费资金)前,系统通常会暂停并请求用户确认。这种机制平衡了自主性与安全性。
### 概念之间的关系图谱
我们可以将这些概念构建成一个有机的整体:
* **目标(Goal)**是起点,驱动**智能体(Agent)**启动。
* 智能体利用**思维链(CoT)**进行推理,生成**任务列表(Task List)**。
* 在执行任务时,智能体受限于**上下文窗口(Context Window)**,因此需要借助**向量数据库(Vector DB)**进行**长期记忆(Long-term Memory)**的读写。
* 为了改变环境,智能体调用**工具(Tools)**,这涉及到**API 集成**。
* 整个过程中,**温度参数(Temperature)**调节着行为的探索与利用平衡。
* 在关键节点,**人机回环(HITL)**机制介入,确保系统不偏离轨道。
这些概念并非孤立存在,而是形成了一个紧密耦合的生态系统。例如,没有高效的向量检索,长周期的自主任务就会因为遗忘而失败;没有合理的温度设置,智能体要么陷入死循环,要么产生幻觉。
### 常见误解澄清
在普及 AutoGPT 的过程中,存在一些普遍的误解,需要在此澄清:
* **误解一:"AutoGPT 是全知全能的,可以解决任何问题。”**
* **真相**:AutoGPT 的能力上限取决于其底层 LLM 的能力。如果模型本身存在逻辑缺陷或缺乏特定领域知识,智能体也会犯错。此外,它容易陷入“死循环”(Looping),即在两个任务之间反复横跳而无法推进。它更像是一个需要监督的实习生,而非全能的上帝。
* **误解二:"AutoGPT 不需要任何提示词工程。”**
* **真相**:虽然它减少了多轮对话的需求,但对初始目标(Objective)的定义要求更高。模糊的目标会导致智能体迷失方向。清晰的约束条件(Constraints)和成功标准(Success Criteria)对于 AutoGPT 的成功至关重要。
* **误解三:"AutoGPT 就是写代码的机器人。”**
* **真相**:代码执行只是其众多能力之一。它在市场调研、数据分析、内容创作流程管理、软件测试等非纯编码领域同样表现出色。它的核心价值在于“流程编排”而非单纯的“代码生成”。
* **误解四:“它可以完全脱离人类独立运行数月。”**
* **真相**:目前的版本主要用于短中期的任务闭环。长期的完全无人值守运行仍面临成本高昂、累积误差大、安全风险高等挑战。现阶段的最佳实践是“半自主”模式。
实际应用:从理论走向生产力
理解了原理和概念后,我们来看看 AutoGPT 在现实世界中究竟能做什么。它的应用场景正在迅速扩展,从极客的玩具演变为企业的生产力工具。
### 典型应用场景
1. **自动化市场研究与竞品分析**:
这是 AutoGPT 最擅长的领域之一。用户可以设定目标:“分析过去三个月内 SaaS 行业的营销趋势,找出排名前十的竞争对手,总结他们的定价策略,并生成 Excel 报表。”
* **执行过程**:智能体自动搜索新闻、访问竞品官网、抓取定价页面、阅读行业报告,提取关键数据,进行对比分析,最后格式化输出。原本需要分析师数天完成的工作,现在可在几十分钟内完成初稿。
2. **端到端的软件开发辅助**:
不同于 GitHub Copilot 的代码补全,AutoGPT 可以承担小型项目的完整开发流程。
* **执行过程**:用户提出“创建一个贪吃蛇游戏网页版”。智能体会规划项目结构,编写 HTML/CSS/JS 代码,保存文件,启动本地服务器测试,发现 Bug(如碰撞检测失效),自动修改代码,再次测试,直到游戏可玩,最后部署上线。
3. **复杂的内容创作与分发矩阵**:
针对自媒体运营者,AutoGPT 可以构建内容流水线。
* **执行过程**:输入一个热点话题,智能体自动搜集素材,撰写深度文章,改写为适合 Twitter、LinkedIn、小红书等不同平台的短文风格,生成配套的配图提示词(Prompt),甚至直接调用绘图 API 生成图片,最后安排发布时间表。
4. **数据清洗与预处理**:
面对杂乱无章的原始数据(如 PDF 报表、非结构化文本),AutoGPT 可以编写并执行 Python 脚本进行清洗、转换和标准化,将非结构化数据转化为可供分析的数据库格式。
### 代表性产品与项目案例
* **AutoGPT (原始开源项目)**:由 Toran Bruce Richards 发起,是这一概念的鼻祖。它在 GitHub 上获得了极高的关注度,证明了自主代理的可行性。虽然早期版本稳定性有待提高,但它确立了行业标准。
* **BabyAGI**:一个轻量级的任务管理系统,专注于任务创建、优先级排序和执行。它比 AutoGPT 更简洁,常被用作学习自主代理架构的入门案例。
* **LangChain + AutoGPT 模式**:许多开发者利用 LangChain 框架复现或增强 AutoGPT 的功能,将其集成到企业现有的工作流中,增加了更多的自定义工具和更稳定的内存管理。
* **Microsoft AutoGen**:微软推出的多智能体对话框架,允许创建多个角色(如程序员、产品经理、测试员)相互协作解决问题,这是对单一个体 AutoGPT 模式的进阶演进,展示了多智能体协作(Multi-Agent Collaboration)的巨大潜力。
### 使用门槛和条件
尽管前景广阔,但要真正用好 AutoGPT,仍需满足一定的条件:
1. **技术门槛**:
* **环境配置**:用户通常需要具备一定的编程基础(Python),能够配置虚拟环境、安装依赖包、设置 API 密钥(如 OpenAI Key, SerpAPI Key 等)。
* **调试能力**:当智能体陷入死循环或产生幻觉时,用户需要有能力查看日志(Logs),分析其思考路径,并调整提示词或参数。
2. **经济成本**:
* 由于 AutoGPT 会进行大量的迭代循环,每一次循环都意味着多次 LLM 的 API 调用。一个复杂任务可能消耗数十甚至上百次 Token 请求。使用 GPT-4 等高性能模型时,单次任务的成本可能从几美元到几十美元不等。成本控制是使用中必须考虑的因素。
3. **安全与风险意识**:
* **权限管理**:赋予智能体文件系统读写权和网络访问权存在风险。必须在沙箱环境或受限权限下运行,防止其误删重要文件或恶意爬取数据。
* **伦理合规**:需确保智能体的行为符合法律法规,避免用于生成垃圾信息、进行网络攻击或侵犯版权。
总体而言,目前的 AutoGPT 更适合技术人员、研究人员以及愿意尝试新工作流的早期采用者(Early Adopters)。随着工具的封装度提高和成本下降,未来它将逐渐走向大众化。
延伸阅读:通往通用人工智能的阶梯
AutoGPT 不仅仅是一个工具,它是通向更高级人工智能形态的一块基石。对于希望深入探索这一领域的读者,以下路径和资源不容错过。
### 相关概念推荐
为了构建完整的知识体系,建议进一步研究以下相关概念:
* **多智能体系统(Multi-Agent Systems, MAS)**:研究多个智能体如何通过通信、协商和协作来解决单个智能体无法完成的复杂问题。这是 AutoGPT 的未来演进方向。
* **强化学习(Reinforcement Learning, RL)**:特别是基于人类反馈的强化学习(RLHF)和在线强化学习。目前的 AutoGPT 主要依赖预训练模型的推理,未来结合 RL 可以让智能体在与环境交互中不断自我进化。
* **神经符号人工智能(Neuro-Symbolic AI)**:结合神经网络的学习能力和符号逻辑的推理能力,旨在解决 LLM 在逻辑严密性和可解释性上的不足,提升智能体的可靠性。
* **具身智能(Embodied AI)**:将自主智能体从数字世界扩展到物理世界,赋予机器人身体,使其能在真实环境中感知和行动。
### 进阶学习路径
1. **入门阶段**:
* 动手部署一个本地的 AutoGPT 实例,尝试完成简单的任务(如搜索资料、写个小脚本)。
* 阅读 AutoGPT 和 BabyAGI 的官方文档及 GitHub README,理解其配置文件结构。
2. **进阶阶段**:
* 学习 **LangChain** 框架,尝试自定义工具(Custom Tools)和记忆后端(Memory Backends)。
* 研究提示词工程(Prompt Engineering)的高级技巧,特别是针对代理行为的结构化提示(Structured Prompting for Agents)。
* 阅读关于 ReAct (Reasoning + Acting) 范式的学术论文,理解其理论基础。
3. **专家阶段**:
* 探索多智能体框架(如 Microsoft AutoGen, CrewAI),设计角色扮演的协作系统。
* 深入研究 LLM 的底层架构,尝试微调(Fine-tuning)专用模型以优化特定领域的代理表现。
* 关注智能体的评估基准(Benchmarks),如 AgentBench,学习如何量化评估智能体的性能。
### 推荐资源和文献
* **论文**:
* *"ReAct: Synergizing Reasoning and Acting in Language Models"* (Yao et al., 2022) - 奠定了自主代理理论基础的必读论文。
* *"Generative Agents: Interactive Simulacra of Human Behavior"* (Park et al., 2023) - 斯坦福著名的"AI 小镇”实验,展示了智能体在社会模拟中的惊人潜力。
* **开源项目**:
* **AutoGPT** (GitHub): 原始项目,了解最新特性。
* **LangChain**: 目前最流行的 LLMOps 框架,文档丰富,社区活跃。
* **Microsoft AutoGen**: 微软研究院出品,代表了多智能体协作的前沿方向。
* **社区与资讯**:
* Hugging Face Blog: 经常发布关于最新代理技术和模型的深度解析。
* arXiv.org (cs.AI 分类): 追踪最新的学术研究动态。
* Discord 社区(如 LangChain, AutoGPT 官方频道): 与开发者和实践者直接交流,获取第一手的实战经验和问题解答。
AutoGPT 的出现,让我们窥见了软件交互方式的未来图景。从“人适应机器”到“机器适应人”,从“指令执行”到“目标达成”,这场变革才刚刚拉开序幕。对于每一位 AI 学习者而言,理解 AutoGPT 不仅是为了掌握一个工具,更是为了把握下一代人机协作的核心逻辑。在这个自主智能体蓬勃发展的时代,保持好奇,勇于实践,将是最好的学习方式。





