
一句话定义
欠拟合(Underfitting)指机器学习模型因过于简单或训练不足,无法捕捉数据中的核心规律,导致在训练集和测试集上均表现不佳的现象。
在人工智能与机器学习的宏大叙事中,我们往往热衷于讨论那些参数高达千亿、能够生成逼真图像或流畅对话的“超级模型”。然而,在这些光鲜亮丽的技术背后,存在着一个基础却至关重要的概念,它决定了模型是否具备最基本的学习能力——这就是欠拟合(Underfitting)。如果把训练 AI 模型比作学生备考,过拟合是“死记硬背考题但不懂原理”,而欠拟合则是“连课本都没看完,根本不知道考什么”。本文将深入剖析欠拟合的本质,从数学原理到实战调试,为您呈现一份 2026 年视角下的深度解析。
技术原理:为何模型会“学不会”?
要理解欠拟合,首先必须深入机器学习的核心工作机制。机器学习本质上是一个函数逼近(Function Approximation)的过程。我们的目标是找到一个函数 $f(x)$,使其能够尽可能准确地映射输入数据 $x$ 到真实标签 $y$。欠拟合的发生,意味着我们选择的假设空间(Hypothesis Space)过于狭窄,或者优化过程未能收敛,导致模型无法拟合数据中潜在的复杂分布。
1. 偏差 - 方差权衡中的“高偏差”陷阱
在统计学习理论中,模型的泛化误差(Generalization Error)可以分解为三个部分:偏差(Bias)、方差(Variance)和不可约误差(Irreducible Error)。欠拟合的典型特征就是高偏差(High Bias)。
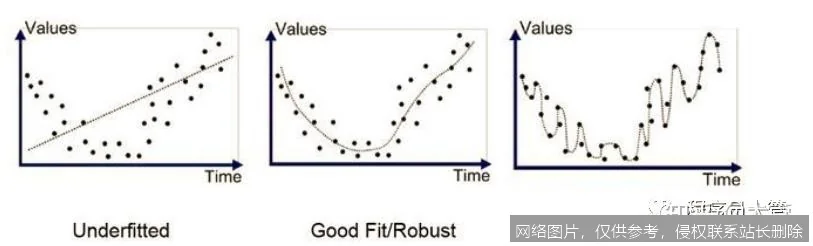
- 偏差(Bias):反映了模型预测值的期望与真实值之间的差异。高偏差意味着模型做出了错误的假设,例如强行用一条直线去拟合一条曲线。无论给模型多少数据,它都无法消除这种系统性错误。
- 方差(Variance):反映了模型对训练数据微小变化的敏感程度。欠拟合模型通常方差较低,因为它太“迟钝”了,数据怎么变,它的预测结果都差不多(虽然都不准)。
在 2026 年的深度学习语境下,尽管模型结构日益复杂,但在小样本学习(Few-shot Learning)或边缘计算设备(Edge AI)上部署轻量化模型时,高偏差导致的欠拟合依然是主要挑战。当模型容量(Model Capacity)不足以覆盖数据的复杂度时,偏差项将主导总误差,导致模型在训练阶段就无法降低损失函数(Loss Function)的值。
2. 关键机制解析:容量不足与优化失败
欠拟合的产生主要源于两个维度的机制失效:
A. 模型容量限制(Model Capacity Constraints)
模型容量是指模型拟合各种函数的能力。如果一个线性回归模型(Linear Regression)被用来解决异或(XOR)问题,无论训练多久,它永远无法得到准确结果,因为线性模型的决策边界只能是直线,而 XOR 需要非线性边界。这就是典型的表达力不足(Under-representation)。在神经网络中,这表现为层数过浅、神经元数量过少,或者激活函数(Activation Function)选择不当(如在全连接层误用线性激活),导致网络退化为简单的线性变换。
B. 优化过程未收敛(Optimization Failure)
即使模型结构足够复杂,如果训练过程不充分,也会导致欠拟合。这可能由以下原因造成:
- 训练轮次不足(Under-training):模型还没来得及学习数据规律就停止了训练。
- 学习率过低(Learning Rate too low):参数更新步长太小,模型在损失函数的谷底附近徘徊,无法到达全局最优解或较好的局部最优解。
- 正则化过强(Over-regularization):这是初学者常犯的错误。为了防止过拟合,我们引入 L1/L2 正则化或 Dropout。但如果正则化系数($\lambda$)设置得过大,会过度惩罚模型权重,迫使权重趋近于零,从而人为地限制了模型的表达能力,导致“还没学会走路就被绑住了腿”。
3. 与传统方法的对比及类比
为了更直观地理解,我们可以将欠拟合与传统编程逻辑进行对比。在传统规则引擎中,程序员需要手动编写所有的 `if-else` 规则。如果规则写得太少或太笼统(例如只规定了“下雨带伞”,却没规定“下雪带伞”),系统就会在很多场景下失效。这类似于欠拟合:模型学到的“规则”太少,无法覆盖现实世界的多样性。
类比:画师与模特
想象一位画师(模型)正在为一位复杂的模特(数据分布)画像。
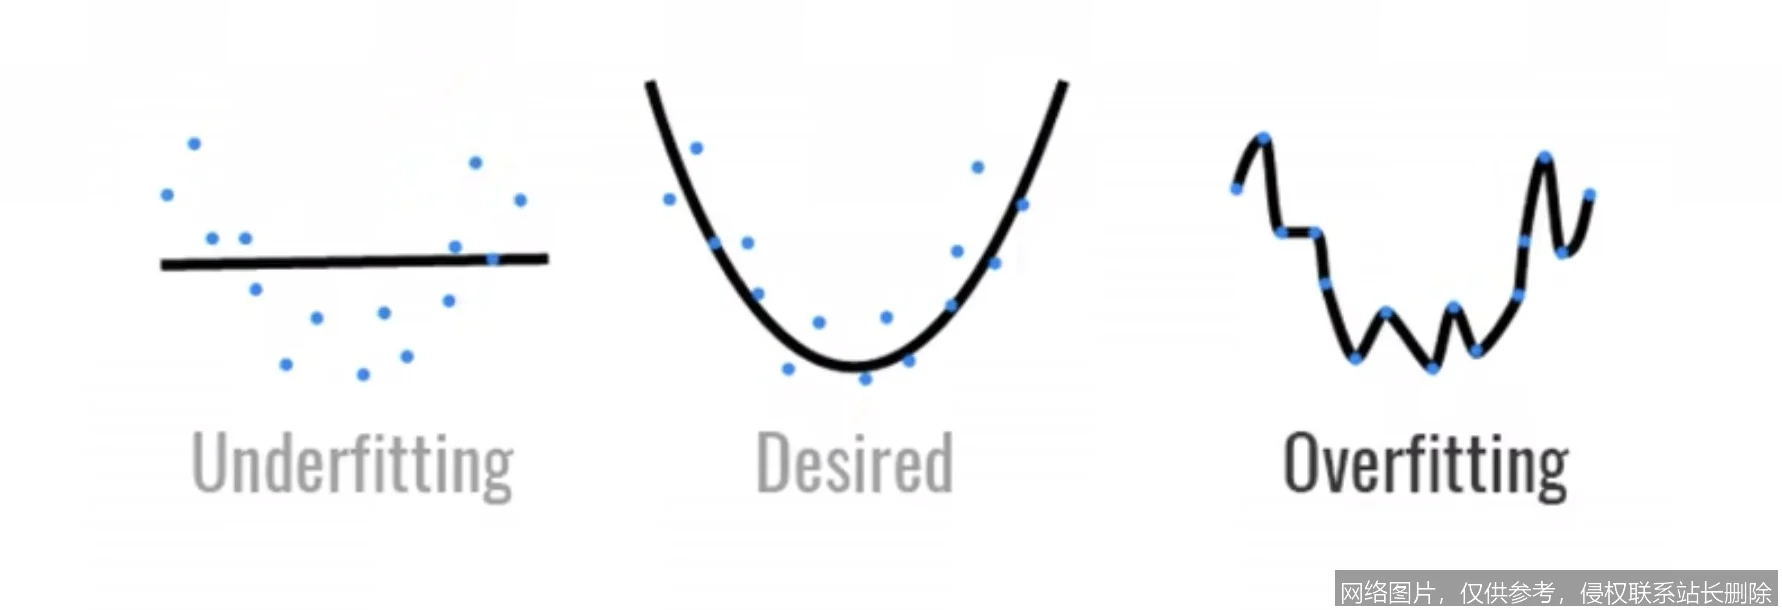
- 正常拟合:画师观察细致,画出了模特的五官特征和神韵。
- 过拟合:画师连模特脸上的每一颗痘痘、光线造成的临时阴影都画下来了,甚至把背景里的苍蝇也画得像主体一样重要。一旦模特换个角度或光线,这幅画就完全不像了。
- 欠拟合:画师是个初学者,或者时间太紧,他只画了一个圆圈代表头,两条线代表眼睛。无论模特是男是女、是老是少,画出来的都是同一个简笔小人。这就是欠拟合——忽略了数据的特异性,只学到了极其粗糙的共性,甚至共性都没学全。
核心概念:构建知识图谱
深入理解欠拟合,需要厘清一系列相互关联的关键术语。这些概念构成了诊断和解决欠拟合问题的理论基础。
1. 关键术语解释
- 假设空间(Hypothesis Space, $\mathcal{H}$):模型所有可能输出的函数的集合。欠拟合意味着真实的目标函数不在当前的假设空间内,或者搜索算法没能找到它。
- 经验风险最小化(Empirical Risk Minimization, ERM):机器学习的核心原则,即最小化训练数据上的平均损失。欠拟合表现为即使在训练集上,经验风险也无法降低到可接受的水平。
- 归纳偏置(Inductive Bias):学习算法对未知数据进行预测时所作的假设集合。例如,线性回归的归纳偏置是“数据之间存在线性关系”。如果归纳偏置与数据真实分布严重不符,必然导致欠拟合。
- VC 维(Vapnik-Chervonenkis Dimension):衡量模型复杂度的理论指标。低 VC 维的模型更容易发生欠拟合,因为它们能打散(Shatter)的数据点数量有限。
2. 概念关系图谱:欠拟合与过拟合的二元对立
在机器学习的光谱上,欠拟合与过拟合(Overfitting)处于两端,中间是理想的泛化(Generalization)状态。
[训练误差] vs [测试误差] 的动态关系
- 欠拟合区域:训练误差高,测试误差高。两者差距小(因为都高)。
- 最佳拟合区域:训练误差较低,测试误差最低。两者保持在一个合理的差距范围内。
- 过拟合区域:训练误差极低(接近 0),但测试误差急剧上升。两者差距巨大。
理解这一图谱的关键在于:解决欠拟合的目标是降低训练误差,同时不引起测试误差的剧烈反弹。这与解决过拟合(旨在缩小训练与测试误差的差距)的策略往往是相反的。
3. 常见误解澄清
误解一:“只要增加数据量就能解决欠拟合。”
真相:这是一个严重的误区。如果模型本身容量不足(如用直线拟合曲线),增加再多的高质量数据,模型依然只会拟合出一条“平均意义”上的直线,无法捕捉非线性特征。增加数据主要有助于缓解过拟合和提高泛化性,对高偏差导致的欠拟合帮助有限。解决欠拟合的首要任务是增强模型能力。
误解二:“欠拟合比过拟合好,因为它更保守。”
真相:虽然欠拟合的模型方差小、稳定性高,但其预测结果毫无价值。一个准确率只有 50% 的稳定模型,在分类任务中等同于随机猜测。在实际工程中,我们通常倾向于先让模型充分拟合(甚至轻微过拟合),然后再通过正则化手段将其拉回,而不是从一开始就限制其学习能力。
误解三:“深度学习模型永远不会欠拟合。”
真相:虽然深度神经网络具有极强的拟合能力(万能近似定理),但在实际应用中,由于梯度消失(Gradient Vanishing)、初始化不当、学习率调度错误或极强的正则化约束,深度模型同样会出现严重的欠拟合现象。特别是在迁移学习(Transfer Learning)中,如果预训练模型与目标任务域差异过大且微调(Fine-tuning)不充分,也会出现欠拟合。
实际应用:从理论到实战的跨越
欠拟合不仅仅是一个理论概念,它在工业界和科研项目中无处不在。识别并解决欠拟合,是算法工程师日常工作的核心内容之一。
1. 典型应用场景
- 边缘计算与移动端部署(Edge AI):
在手机、IoT 设备或自动驾驶芯片上,受限于算力和功耗,模型必须极度轻量化(如 MobileNet, ShuffleNet 的极致剪枝版)。在这种极端压缩下,模型极易丢失关键特征提取能力,导致欠拟合。工程师需要在“模型大小”和“拟合能力”之间走钢丝。 - 小样本学习(Few-Shot Learning):
在医疗影像诊断、罕见故障检测等场景中,标注数据极其稀缺。如果使用标准的深层网络,往往因为数据不足以支撑庞大的参数量更新,导致模型无法收敛,表现为欠拟合。此时需要借助元学习(Meta-Learning)或数据增强技术。 - 冷启动阶段的推荐系统:
对于新用户或新物品,由于缺乏历史交互数据,协同过滤等模型无法学习到有效的用户偏好向量,导致推荐结果千篇一律(如只推热门商品),这也是一种业务层面的欠拟合表现。
2. 代表性案例解析
案例 A:某金融风控模型的失效
某银行开发了一套反欺诈模型,初期使用逻辑回归(Logistic Regression)配合少量人工特征。结果显示,模型在训练集上的准确率仅为 65%,且在测试集上同样低迷。
诊断:欺诈行为具有高度非线性和隐蔽性,线性模型无法捕捉特征间的复杂交互(如“深夜交易” + “异地登录” + “大额转账”的组合风险)。
解决方案:团队引入了梯度提升树(GBDT/XGBoost)并构建了交叉特征,同时将模型从线性升级为非线性结构。训练误差迅速下降至 5% 以下,最终上线效果显著提升。
案例 B:大语言模型(LLM)的微调困境
2025 年,某企业尝试基于开源的 7B 参数模型微调垂直领域的客服机器人。他们使用了极强的 Dropout(0.5)和早停策略(Early Stopping),担心过拟合。结果机器人回答生硬,无法理解复杂的客户意图。
诊断:过度的正则化和过早停止训练,抑制了模型对特定领域术语和逻辑的学习,导致欠拟合。
解决方案:降低 Dropout 比例至 0.1,移除早停限制,允许模型训练更多轮次(Epochs),并采用学习率预热(Warmup)策略。模型最终成功掌握了领域知识。
3. 实战调试:如何识别与解决欠拟合?
在实战中,我们可以通过观察学习曲线(Learning Curves)来快速诊断。如果训练损失(Training Loss)和验证损失(Validation Loss)都很高,且随着训练进行下降缓慢或停滞,基本可判定为欠拟合。
解决欠拟合的“工具箱”:
- 增加模型复杂度:
- 对于神经网络:增加层数(Depth)、增加每层的神经元数量(Width)。
- 对于传统模型:引入多项式特征(Polynomial Features)、使用核方法(Kernel Trick)。
- 特征工程优化:
- 挖掘更有区分度的新特征。
- 进行特征组合,让模型更容易学到非线性关系。
- 去除过多的特征选择过滤,保留更多信息。
- 调整超参数:
- 减小正则化强度:降低 L1/L2 的 $\lambda$ 值,减少 Dropout 比率。
- 增加训练时间:增加 Epoch 数量。
- 调整学习率:适当增大学习率,或使用自适应优化器(如 AdamW)。
- 更换模型架构:
- 从线性模型切换到树模型或神经网络。
- 在深度学习中,尝试残差连接(Residual Connections)以缓解深层网络的退化问题。
使用门槛与条件:解决欠拟合并非没有代价。增加模型复杂度会提高计算成本和推理延迟;减少正则化可能引发过拟合风险。因此,最佳的实践是迭代式的:先确保模型能拟合训练数据(解决欠拟合),再通过交叉验证和正则化来控制过拟合,寻找那个完美的平衡点(Sweet Spot)。
延伸阅读:通往高阶之路
欠拟合只是机器学习偏差 - 方差权衡故事的一半。要成为真正的 AI 专家,您需要构建更完整的知识体系。
1. 相关概念推荐
- 过拟合(Overfitting):欠拟合的镜像问题,理解它是掌握泛化能力的关键。
- 正则化技术(Regularization Techniques):深入理解 Lasso, Ridge, Elastic Net, Dropout, Batch Normalization 等如何动态调节模型复杂度。
- 交叉验证(Cross-Validation):K-Fold CV 是评估模型是否欠拟合或过拟合的金标准方法。
- 集成学习(Ensemble Learning):Bagging 和 Boosting 如何通过组合多个弱模型(可能欠拟合的模型)来构建强模型。
2. 进阶学习路径
如果您希望从入门走向精通,建议遵循以下路径:
- 基础阶段:掌握线性代数与概率论基础,熟练运用 Scikit-learn 绘制学习曲线,直观感受欠拟合现象。
- 进阶阶段:深入研读《The Elements of Statistical Learning》(ESL),理解偏差 - 方差分解的数学推导;学习深度学习框架(PyTorch/TensorFlow)中的模型调试技巧。
- 专家阶段:关注 NeurIPS, ICML 等顶会中关于"Neural Architecture Search (NAS)"和"AutoML"的最新论文,了解自动化算法如何动态搜索最佳模型容量以避免欠拟合与过拟合。
3. 推荐资源与文献
- 经典教材:
- Pattern Recognition and Machine Learning by Christopher M. Bishop(贝叶斯视角下的偏差分析)。
- Deep Learning by Ian Goodfellow et al.(第 5 章详细论述了容量、过拟合与欠拟合)。
- 在线课程:
- Coursera: Machine Learning Specialization (Andrew Ng) - 经典的偏差/方差可视化讲解。
- Fast.ai: Practical Deep Learning for Coders - 强调通过实战代码观察训练过程中的欠拟合现象。
- 工具库文档:
- Scikit-learn User Guide: "Diagnosing bias and variance"。
- TensorFlow/Keras Guides: "Overfitting and underfitting"。
总结而言,欠拟合是机器学习旅程中的第一道关卡。它提醒我们,模型不是万能的魔法黑盒,而是需要精心设计和调优的数学结构。只有深刻理解欠拟合的成因与对策,我们才能在构建智能系统的道路上,避开“学不会”的陷阱,迈向真正泛化能力强的人工智能未来。





