
一句话定义
TensorFlow 是由 Google 开发的开源端到端机器学习平台,通过数据流图机制实现从研究原型到生产部署的全流程高效计算。
技术原理:数据流图与分布式计算的交响乐
要真正理解"TensorFlow 是什么”,我们不能仅停留在它是一个“工具库”的表层认知,而必须深入其引擎盖下,剖析其独特的核心工作机制。如果把传统的编程模式比作“按部就班的指令执行”,那么 TensorFlow 的核心思想则更像是一场精密编排的“流水线作业”。这种设计哲学使其在处理大规模矩阵运算和复杂神经网络时,展现出了惊人的效率与灵活性。
1. 核心工作机制:静态图与动态图的融合演进
TensorFlow 的名字本身就揭示了其两大基石:Tensor(张量)与Flow(流)。在技术底层,所有数据都被表示为多维数组(即张量),而这些张量在一个由节点(Operations,操作)和有向边组成的图中流动。这个图就是著名的数据流图(Data Flow Graph)。
在 TensorFlow 1.x 时代,其核心机制严格遵循“定义 - 运行”分离的模式。开发者首先需要构建一个完整的计算图(Graph Definition),描述所有的数学运算逻辑,此时并不进行实际计算;随后启动一个会话(Session),将图加载到硬件(CPU/GPU/TPU)上执行。这种静态图(Static Graph)机制的优势在于编译器可以对整个图进行全局优化,例如算子融合(Operator Fusion)、内存复用以及自动的并行化处理,从而极大提升推理速度。然而,其缺点也显而易见:调试困难,无法像普通 Python 代码那样即时查看中间变量,且动态控制流(如变长循环)的实现极为繁琐。
随着 2019 年 TensorFlow 2.0 的发布,这一机制发生了革命性的变化。TF2 默认引入了即时执行模式(Eager Execution),这使得计算图变为动态图(Dynamic Graph)。代码写一行执行一行,开发者可以像使用 NumPy 一样直观地调试模型,极大地降低了入门门槛。但这并不意味着放弃了静态图的性能优势。TF2 引入了@tf.function装饰器,它能够将普通的 Python 函数自动追踪并转换为高效的静态计算图(通过 XLA 编译器)。这种“动静结合”的架构,既保留了研发的灵活性,又确保了生产环境的高性能,构成了现代 TensorFlow 的核心竞争力。
2. 关键技术组件:从内核到生态的立体架构
TensorFlow 之所以能成为工业界的首选,离不开其模块化且层次分明的架构设计。我们可以将其想象为一座摩天大楼:
- 地基层:分布式运行时(Distributed Runtime)。这是 TensorFlow 最强大的引擎之一。它允许将一个巨大的计算图切分成多个子图,分发到不同的设备(多卡、多机)上并行计算。其内部的通信机制能够自动处理数据同步、参数服务器(Parameter Server)协调等复杂问题,使得训练超大规模模型成为可能。
- 核心层:XLA(Accelerated Linear Algebra)编译器。XLA 是 TensorFlow 的性能加速器。它将高层的图操作编译成针对特定硬件(如 NVIDIA GPU 或 Google TPU)优化的低级机器码。通过算子融合技术,XLA 能减少内存读写次数,显著提升计算吞吐量。
- 框架层:Keras API。在 TF2 中,Keras 不再是外部库,而是成为了官方的高级 API 标准。它提供了极其简洁的接口来构建、训练和评估模型,屏蔽了底层的复杂性,让开发者只需关注网络结构本身。
- 应用层:TensorFlow Extended (TFX) 与 TensorFlow Lite。TFX 是一套用于生产级机器学习流水线的工具集,涵盖数据验证、模型分析、服务部署等环节;而 TFLite 则专为移动端和嵌入式设备设计,通过量化(Quantization)和剪枝(Pruning)技术,让庞大的模型能在手机甚至微控制器上流畅运行。
3. 与传统方法的对比:为何选择数据流?
为了更直观地理解 TensorFlow 的价值,我们可以将其与传统的命令式编程(如原生 Python 或早期的 PyTorch 纯动态模式)进行类比。
假设我们要建造一座汽车工厂。传统编程模式就像是雇佣一群工人,你每下一个指令(“安装轮胎”、“拧紧螺丝”),他们就做一个动作。如果中途发现螺丝型号不对,你可以立即停止并修正,这很灵活。但是,如果你想让工厂同时生产一万辆车,或者想让不同车间的工人完美配合而不发生碰撞,管理成本会呈指数级上升。
TensorFlow 的数据流图模式则像是先绘制一张详尽的全厂蓝图。在动工前,工程师(编译器)已经分析了整个流程,发现“安装轮胎”和“喷涂油漆”可以并行处理,或者将几个连续的焊接步骤合并为一个自动化机械臂动作(算子融合)。一旦蓝图确定并投入运行,整个工厂将以最优化的节奏高速运转,且极易扩展到多个分厂(分布式训练)。虽然早期绘制蓝图(定义图)稍显麻烦,但在大规模工业化生产(模型训练与部署)中,这种模式的效率和稳定性是传统方法难以企及的。
此外,与竞争对手相比,TensorFlow 在跨平台部署方面具有天然优势。得益于其抽象的设备层,同一套代码可以轻松运行在云端集群、浏览器(TensorFlow.js)、手机端(TFLite)乃至边缘 IoT 设备上,实现了真正的“一次编写,到处运行”。
核心概念:构建机器学习世界的通用语言
深入掌握 TensorFlow,必须厘清其特有的术语体系。这些概念不仅是代码中的类名,更是理解其设计哲学的钥匙。
1. 关键术语深度解析
- 张量(Tensor):这是数据的载体。标量是 0 维张量,向量是 1 维,矩阵是 2 维,以此类推。在 TensorFlow 中,张量不仅是数据容器,还携带了数据类型(dtype)和形状(shape)信息。重要的是,在图模式下,张量只是一个“句柄”(handle),指向计算图中的某个节点输出,而非直接存储数值。
- 操作(Operation / Op):计算图中的节点。每一个数学运算(如加法、卷积、激活函数)都是一个 Op。Op 接收零个或多个张量作为输入,经过计算后输出零个或多个张量。
- 计算图(Computational Graph):由 Ops 和 Tensors 构成的有向无环图(DAG)。它描述了计算的依赖关系。只有当图中的某个节点被请求计算时,系统才会回溯其依赖路径,执行必要的上游操作。
- 变量(Variable):一种特殊的张量,用于存储模型的可训练参数(如权重和偏置)。与普通张量不同,变量的状态可以在多次图执行之间持久保持,并通过优化器(Optimizer)进行更新。
- 回调(Callback):在模型训练过程中,在特定阶段(如每个 epoch 结束)自动执行的函数。常用于实现早停(Early Stopping)、学习率调整或日志记录,是控制训练流程的重要工具。
2. 概念关系图谱
理解这些概念如何交互至关重要。我们可以构建这样一个逻辑链条:
数据 被封装为 Placeholder(占位符,旧版)或直接作为 Tensor 输入 -> 进入由 Op 组成的 计算图 -> 图中的 Variable 存储参数 -> 经过前向传播得到预测值 -> 计算 Loss(损失) -> 通过 GradientTape(梯度带,用于自动微分)记录运算轨迹 -> 反向传播计算梯度 -> Optimizer 更新 Variable -> 循环迭代直至收敛。
在这个流程中,tf.GradientTape 是 TF2 自动微分机制的核心。它在 Eager 模式下动态记录操作序列,当需要计算梯度时,它会反向遍历记录的操作链,利用链式法则自动求出导数。这使得自定义复杂的损失函数或网络结构变得异常简单。
3. 常见误解澄清
误解一:"TensorFlow 只能用于深度学习。”
事实上,虽然深度学习是其最耀眼的应用场景,但 TensorFlow 本质上是一个通用的数值计算库。它可以用于求解微分方程、进行物理模拟、处理传统机器学习算法(如 SVM、随机森林的底层实现)甚至是金融建模。只要问题可以转化为张量运算和数据流图,TensorFlow 就能胜任。
误解二:"TensorFlow 2.0 完全抛弃了图模式。”
这是一个危险的误区。虽然默认是 Eager 模式,但生产环境中强烈建议使用 @tf.function 将代码转换为图模式。如果不这样做,模型在大数据集上的训练速度和部署兼容性将大打折扣。正确的姿势是:用 Eager 模式调试和原型开发,用 Graph 模式进行训练和部署。
误解三:“张量就是 NumPy 数组。”
虽然两者在 API 设计上高度相似,但本质不同。NumPy 数组存储在 CPU 内存中,由 CPU 计算;而 TensorFlow 张量可以驻留在 GPU 或 TPU 显存中,并且支持自动微分和分布式计算。此外,在图模式下,张量是符号化的,不能直接打印出其数值,必须通过 Session 运行或转为 NumPy 数组(.numpy())才能查看具体值。
实际应用:从实验室到亿万用户的生产力引擎
理论的价值在于实践。TensorFlow 之所以能占据全球机器学习平台的半壁江山,是因为它在各种严苛的实际场景中证明了其可靠性、扩展性和易用性。
1. 典型应用场景
- 计算机视觉(Computer Vision):这是 TensorFlow 最成熟的领域。从图像分类、物体检测到语义分割,再到生成对抗网络(GANs)生成逼真图像。得益于 TensorFlow Hub,开发者可以直接调用预训练的 ResNet、EfficientNet 等模型,通过迁移学习(Transfer Learning)快速构建自己的识别系统。
- 自然语言处理(NLP):随着 Transformer 架构的流行,TensorFlow 推出了 TensorFlow Text 和集成 Hugging Face 模型的能力。它广泛应用于机器翻译、情感分析、智能客服聊天机器人以及大语言模型(LLM)的微调与推理。
- 推荐系统与排序:在电商和内容平台中,TensorFlow Ranking 库专门用于解决列表级的排序学习问题。它能够处理海量的稀疏特征,实时预测用户对商品的点击率(CTR)或转化率,直接驱动着亚马逊、YouTube 等巨头的营收引擎。
- 端侧智能(Edge AI):利用 TensorFlow Lite,复杂的 AI 模型可以被压缩并部署在 Android/iOS 手机、树莓派甚至微控制器(MCU)上。应用场景包括手机相册的人脸识别、离线语音助手、工业设备的故障预测等,实现了低延迟、高隐私的本地推理。
2. 代表性产品与项目案例
Google 内部生态:作为亲儿子,Google 搜索的排名算法、Gmail 的垃圾邮件过滤、Google Photos 的图像搜索、Google Translate 的实时翻译,背后均由 TensorFlow 驱动。特别是 AlphaGo 和 AlphaFold,这些改变世界的 AI 突破,其核心计算框架均基于 TensorFlow。
Uber Michelangelo:网约车巨头 Uber 构建了名为 Michelangelo 的内部机器学习平台,其底层核心便是 TensorFlow。该平台每天处理数亿次预测请求,用于预估到达时间(ETA)、动态定价以及司机乘客匹配,展示了 TensorFlow 在高并发、低延迟生产环境下的卓越能力。
Airbnb 搜索排序:Airbnb 利用 TensorFlow 重构了其搜索排序系统,通过深度学习模型理解用户的复杂意图和房源的非结构化特征(如图片风格、评论情感),显著提升了预订转化率。
3. 使用门槛与条件
尽管 TensorFlow 功能强大,但要充分发挥其效能,仍需满足一定的条件:
- 硬件要求:虽然可以在 CPU 上运行,但要训练中等规模以上的模型,强烈建议配备 NVIDIA GPU(需安装 CUDA 和 cuDNN)或使用云端的 TPU。对于端侧部署,则需要芯片支持特定的指令集(如 ARM NEON)。
- 技能树:使用者需要具备基础的 Python 编程能力,理解线性代数(矩阵运算)、微积分(梯度下降)以及机器学习的基本原理。对于高级应用,还需了解分布式系统知识和 Docker 容器化技术。
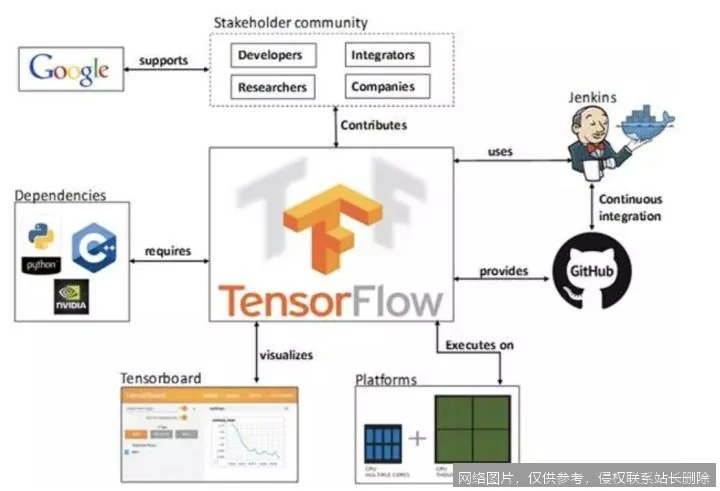
- 生态依赖:现代 TensorFlow 开发高度依赖其生态系统,如 TensorBoard(可视化调试工具)、TFX(流水线工具)以及丰富的预训练模型库。脱离这些生态单打独斗,开发效率会大幅降低。
延伸阅读:通往专家之路的指南针
掌握"TensorFlow 是什么”只是万里长征的第一步。在这个日新月异的技术领域,持续学习和拓展视野至关重要。
1. 相关概念推荐
为了构建完整的知识体系,建议在掌握 TensorFlow 的基础上,进一步探索以下关联领域:
- PyTorch:目前学术界最流行的框架,以其极致的动态图和 Pythonic 风格著称。对比学习 PyTorch 与 TensorFlow 的异同,有助于深刻理解“静态图”与“动态图”的设计权衡。
- JAX:Google 推出的新一代高性能数值计算库,被视为 TensorFlow 的精神继承者之一。它结合了 NumPy 的接口、自动微分和 XLA 编译,代表了未来科学计算的方向。
- MLOps(机器学习运维):学习如何将 TensorFlow 模型纳入 CI/CD 流程,涉及模型监控、版本管理、自动化重训练等工程化实践。
- ONNX(Open Neural Network Exchange):了解不同框架间的模型互换标准,打破框架锁定,实现模型的跨平台自由流转。
2. 进阶学习路径
针对不同阶段的学习者,推荐以下进阶路线:
- 入门阶段:完成 Google 官方的 "Machine Learning Crash Course",重点掌握 Keras API 的快速建模能力,尝试复现经典的 MNIST 手写数字识别或 CIFAR-10 图像分类任务。
- 进阶阶段:深入研究
tf.data输入管道优化,学习自定义 Layer 和 Loss 函数,掌握@tf.function的使用技巧与陷阱。尝试阅读 TensorFlow 源码中关于自动微分和图转换的部分。 - 专家阶段:挑战分布式训练策略(MultiWorkerMirroredStrategy, ParameterServerStrategy),学习使用 TFX 构建端到端生产流水线,甚至参与 TensorFlow 开源社区的贡献,修复 Bug 或添加新算子。
3. 推荐资源与文献
- 官方文档(tensorflow.org):这是最权威、更新最快的资源。特别是 "Guide" 部分,涵盖了从基础教程到最佳实践的全方位内容。
- 《Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow》:由 Aurélien Géron 撰写,被誉为机器学习实战的“圣经”。书中通过大量代码示例,深入浅出地讲解了理论与 TensorFlow 实现的结合。
- TensorFlow Dev Summit 演讲视频:每年 Google 举办的开发者峰会都会公布最新的技术路线图和重磅功能,是把握技术风向标的最佳窗口。
- arXiv 论文:关注与 TensorFlow 相关的技术论文,如关于 XLA 优化、分布式训练算法改进的研究,以保持对前沿技术的敏感度。
综上所述,TensorFlow 不仅仅是一个软件库,它是一套完整的思维范式,一套连接算法研究与产业落地的桥梁。从最初的数据流图构想到如今覆盖云边端的庞大生态,TensorFlow 始终站在人工智能浪潮的最前沿。对于每一位有志于投身 AI 领域的学习者而言,深入理解并掌握 TensorFlow,不仅是获取了一把开启智能时代的钥匙,更是获得了参与塑造未来世界的能力。在这个数据驱动的时代,愿你能借助 TensorFlow 的力量,将创意转化为现实,让智能流淌在每一个角落。





