
一句话定义
Inpainting(图像修复)是一种利用人工智能算法,根据图像上下文信息自动填补、重建或替换缺失及指定区域内容的生成式技术。
技术原理:从“猜谜游戏”到“无中生有”的进化
要理解 Inpainting 是什么,我们首先需要剥离掉那些复杂的数学公式,将其还原为一个最本质的逻辑过程:基于上下文的概率预测。如果把一张完整的图片比作一篇缺了几个字的文章,传统的图像处理像是在做“填空题”,依靠周围的笔画去推测缺失部分;而现代的 AI Inpainting 则更像是一位博学的作家,它不仅能补全字迹,还能根据文章的意境,重新创作出一段完全合理甚至更具创意的剧情。
1. 核心工作机制:掩码与生成的双重奏
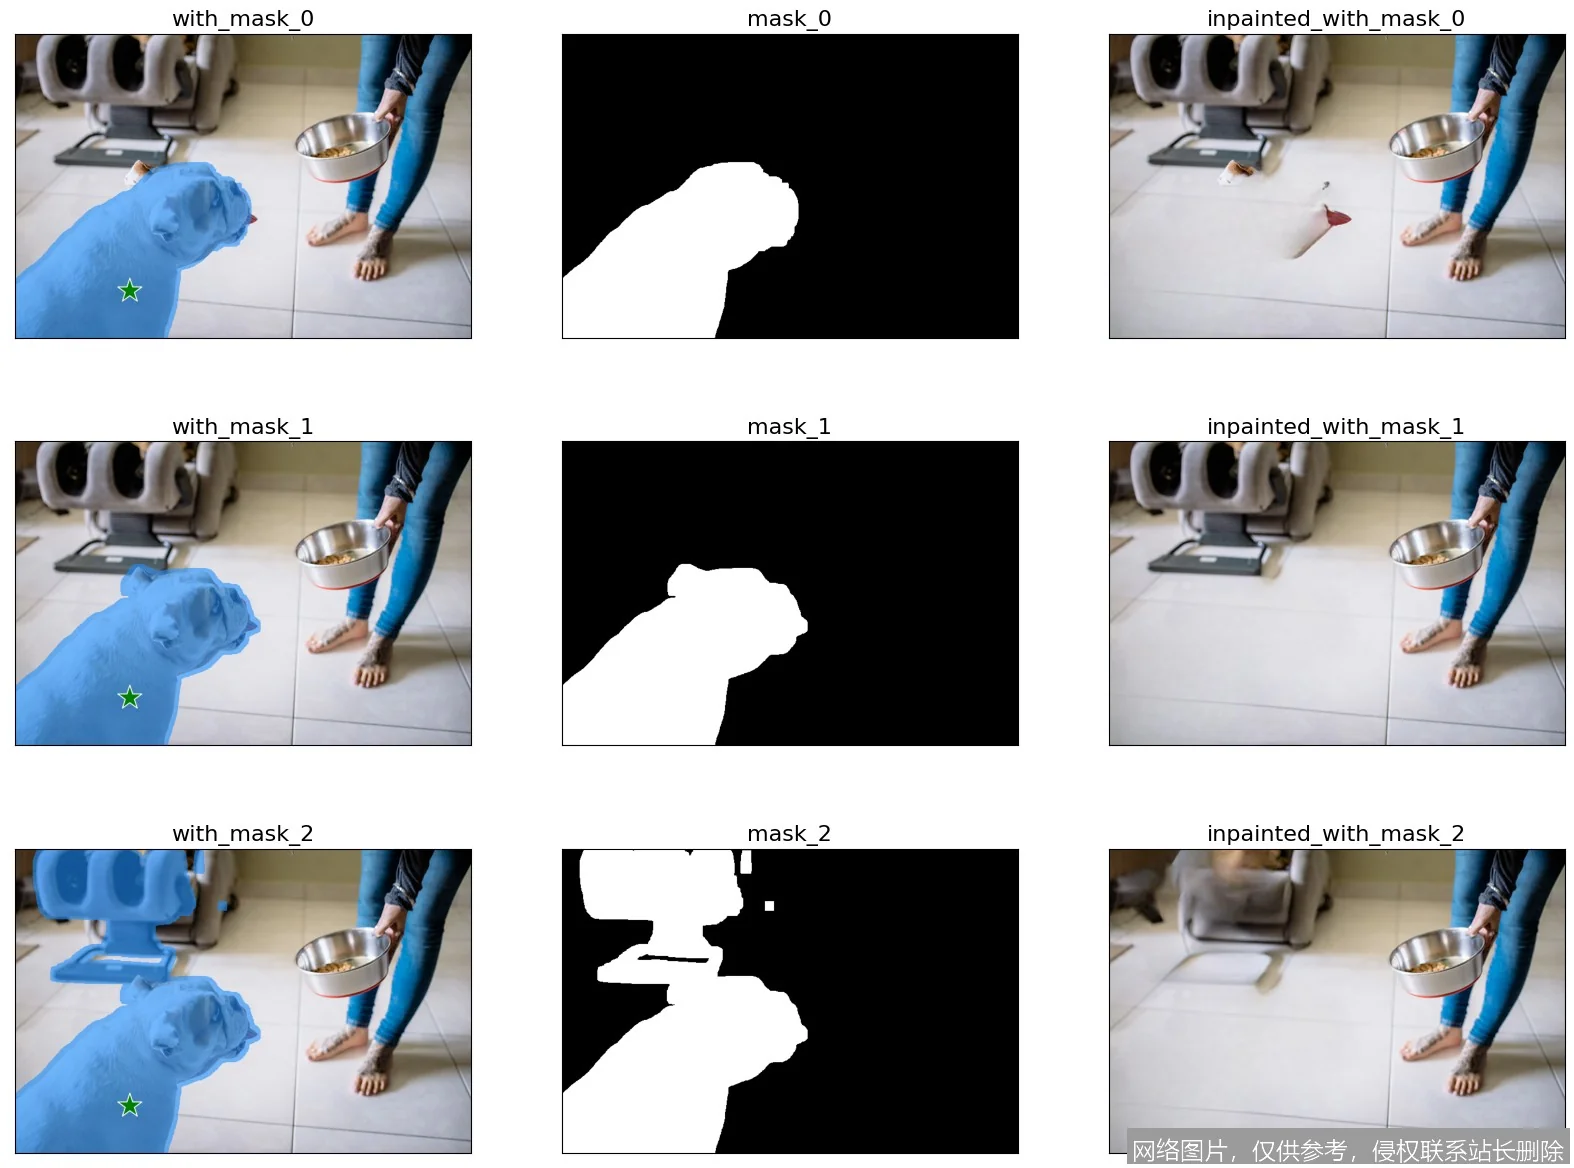
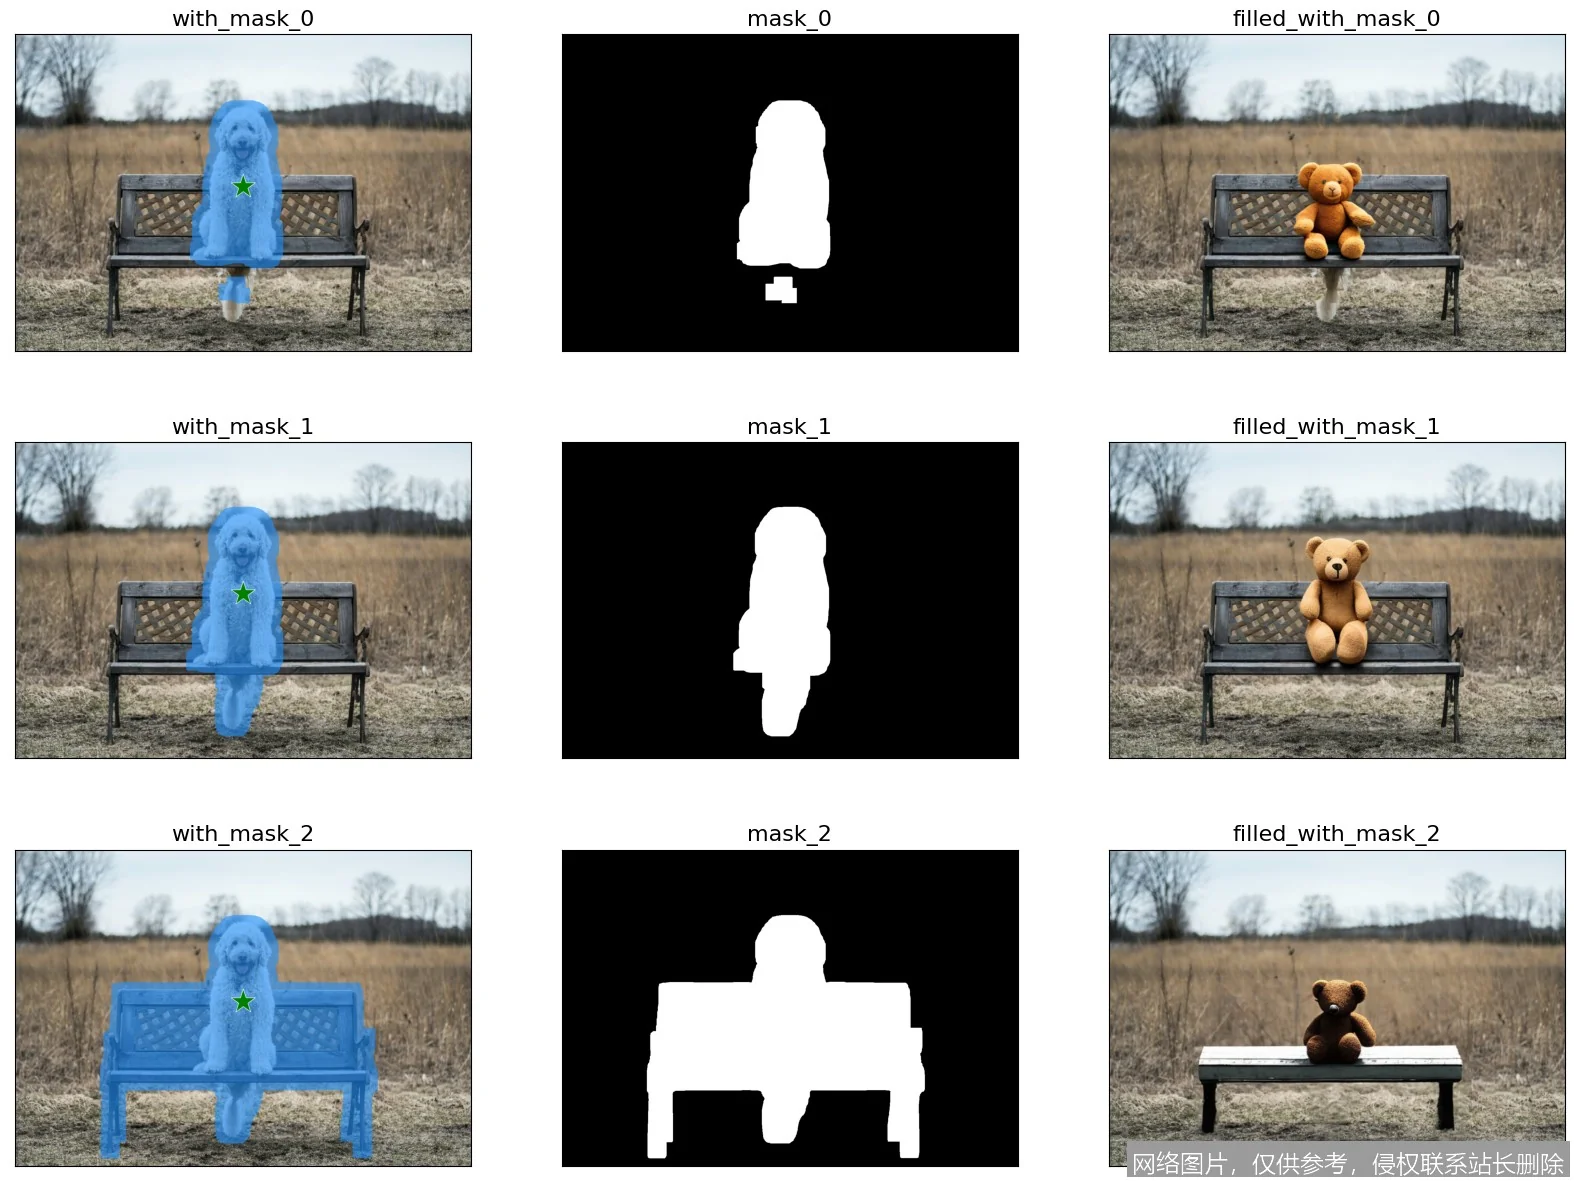
Inpainting 的工作流程通常包含两个关键输入:原始图像(Input Image)和掩码(Mask)。掩码是一张黑白图,白色区域代表需要被修复或重绘的部分(即“空洞”),黑色区域代表需要保留的原始内容。AI 模型的任务,就是在这个“空洞”中填入像素,使得填入的内容在语义上连贯、在纹理上自然,并且与周围保留的区域无缝融合。
这一过程主要经历了两个时代的演变:
第一代:基于扩散与补丁的传统方法(2020 年以前)
早期的 Inpainting 技术主要依赖卷积神经网络(CNN)。其核心思想是“复制粘贴”或“平滑过渡”。算法会扫描图像中未受损的区域,寻找与破损边缘纹理最相似的补丁(Patch),然后将其搬运到破损处。这就好比修补旧衣服,是从衣服不显眼的地方剪下一块布缝上去。这种方法在处理简单背景(如天空、墙壁)时效果尚可,但一旦涉及复杂的物体结构(如人脸五官、建筑物线条),往往会产生模糊、扭曲或明显的重复纹理,因为它缺乏对“物体应该长什么样”的高层语义理解。
第二代:基于生成式模型的革命(2020-2026 年)
随着生成对抗网络(GAN)尤其是扩散模型(Diffusion Models)的爆发,Inpainting 发生了质变。现在的模型不再仅仅是“搬运”像素,而是在进行“想象”和“生成”。以目前主流的 Latent Diffusion Model(潜在扩散模型)为例,其工作原理可以类比为雕刻家:
- 加噪过程(破坏):模型首先学习如何将一张清晰的图片逐渐变成纯噪声(高斯噪声)。
- 去噪过程(重建):在推理阶段,模型从纯噪声开始,根据文本提示词(Prompt)和原始图像的上下文约束,一步步“去噪”,逐渐显现出图像细节。
- 掩码约束:在去噪过程中,对于掩码以外的区域,模型强制保留原始图像的潜变量(Latent Features);而对于掩码内部,模型则完全依据上下文和提示词进行自由生成。
到了 2026 年,这一机制进一步演进为“一致性感知生成”。模型不仅关注局部纹理的连续性,更具备了对全局光照、物理透视甚至动态视频时序一致性的深刻理解。它不再是简单地填补像素,而是在重构一个符合物理规律的虚拟世界片段。
2. 关键技术组件解析
现代 Inpainting 系统的强大,依赖于几个核心组件的协同工作:
编码器 - 解码器架构(Encoder-Decoder Architecture):
这是大多数深度学习模型的骨架。编码器负责将输入图像压缩成低维度的特征表示(提取语义信息,如“这是一只猫”),解码器则负责将这些特征还原为高分辨率的像素图像。在 Inpainting 中,编码器会特别关注掩码边缘的特征,以确保解码器生成的内容能完美衔接。
注意力机制(Attention Mechanism):
这是让 AI“看懂”全局的关键。通过自注意力(Self-Attention)和交叉注意力(Cross-Attention),模型能够建立图像中远距离像素之间的关联。例如,当修复一只被遮挡的腿时,模型能通过注意力机制“看到”另一条完好的腿,从而推断出被遮挡腿的姿态和形状,而不是随机画一条线。在 2026 年的技术栈中,稀疏注意力(Sparse Attention)和窗口注意力(Window Attention)的优化,使得处理 8K 甚至更高分辨率图像时的计算效率提升了数个数量级。
条件控制(Conditioning):
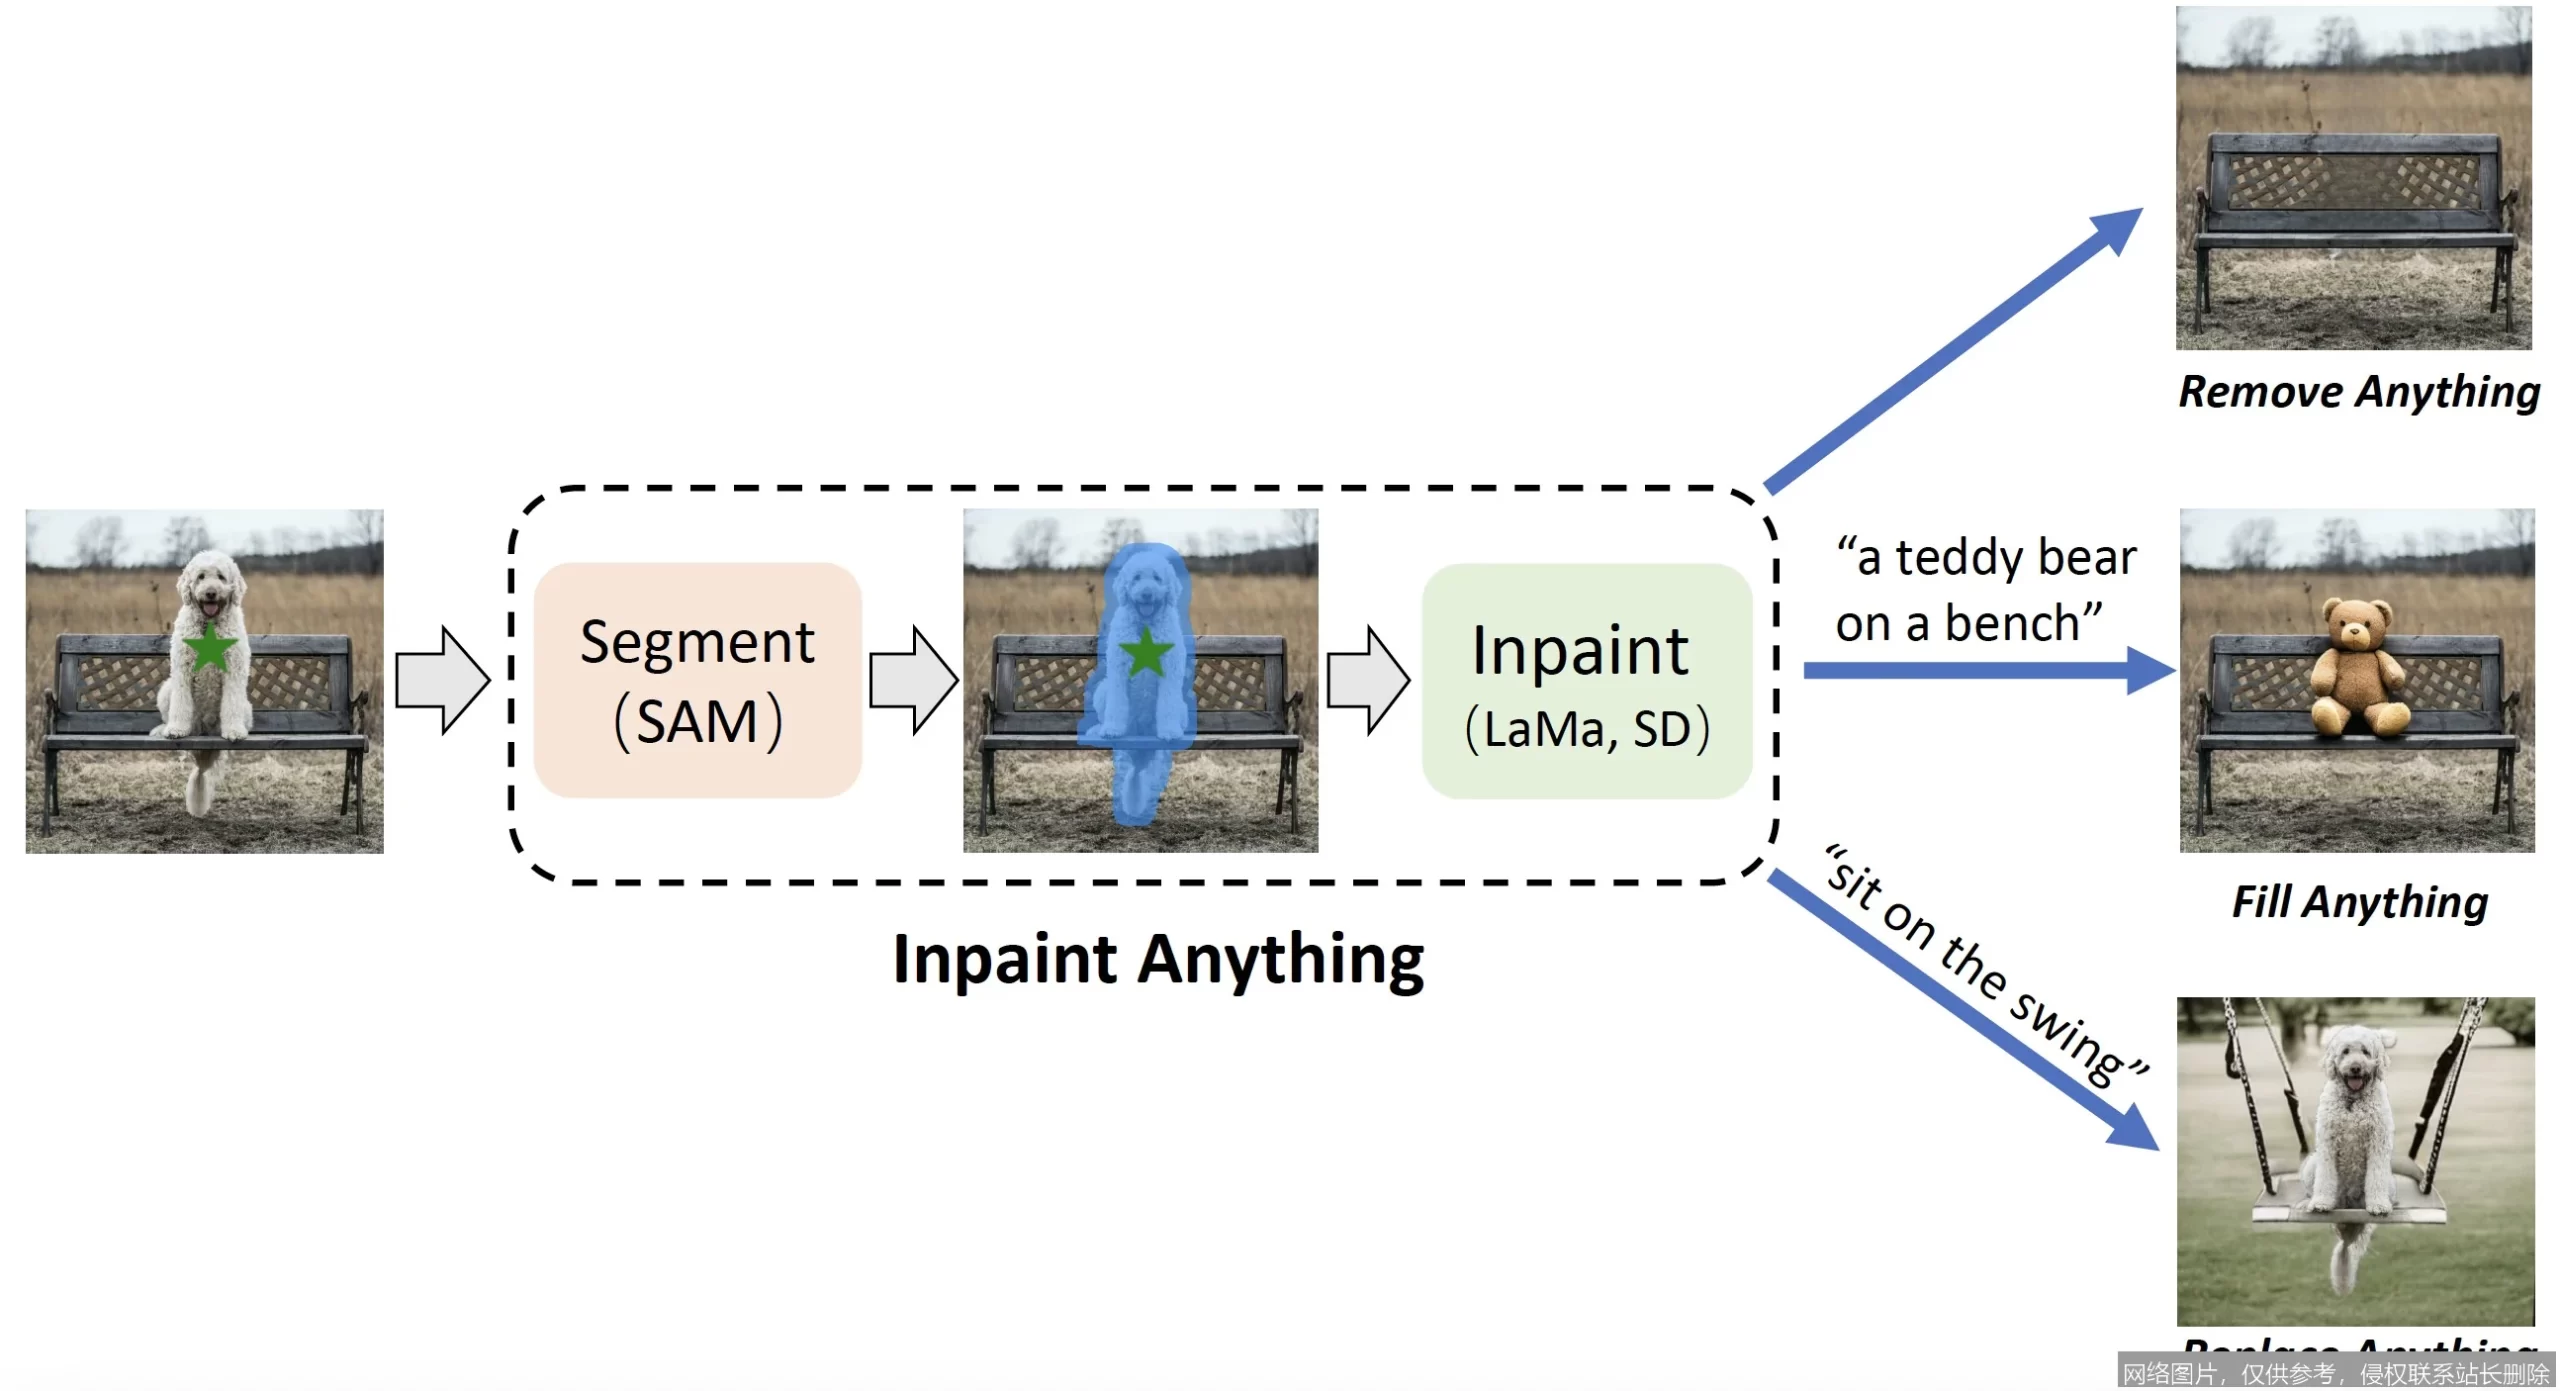
这是实现可控生成的核心。除了图像本身,模型还接受文本提示(Text Prompt)、深度图(Depth Map)、边缘检测图(Canny Edge)等多种条件输入。这使得用户不仅可以“移除”物体,还可以指定“用一朵玫瑰替换这个杯子”,或者“将这个人的衣服改成西装”。2026 年的多模态大模型已经实现了零样本(Zero-shot)条件下的精准控制,无需额外训练即可理解极其复杂的指令。
3. 与传统方法的对比
| 维度 | 传统图像处理 (如 Photoshop 内容识别) | 早期深度学习 (GANs) | 现代 AI Inpainting (Diffusion & Beyond, 2026) |
|---|---|---|---|
| 核心逻辑 | 像素插值、纹理合成 | 判别器与生成器的博弈 | 概率密度建模、逐步去噪 |
| 语义理解 | 无,仅看颜色和纹理 | 有限,依赖训练数据分布 | 极强,理解物体结构、光影、物理规律 |
| 创造性 | 无,只能复用现有像素 | 中等,可生成新纹理但结构易崩 | 高,可凭空创造符合逻辑的全新物体 |
| 适用场景 | 去除小瑕疵、简单背景 | 人脸修复、中等复杂度物体移除 | 复杂场景重构、创意编辑、视频修复 |
| 主要缺陷 | 重复纹理、模糊 | 模式坍塌、多样性不足 | 计算资源消耗大、偶尔出现幻觉(Hallucination) |
简而言之,如果说传统方法是在“修补裂缝”,那么 2026 年的 Inpainting 技术则是在“重塑现实”。它不再受限于原图中有什么,而是取决于用户希望那里有什么。
核心概念:构建认知图谱
深入理解 Inpainting 是什么,需要掌握一系列相互关联的专业术语。这些概念构成了该技术的知识图谱,也是区分初学者与专家的关键。
1. 关键术语解释
掩码(Mask / Matte):
Inpainting 的“施工图纸”。它是一个单通道图像,通常白色表示待修复区域(Target Region),黑色表示保护区域(Context Region)。掩码的精度直接决定了修复的边界质量。在 2026 年的交互式工具中,掩码的生成已高度自动化,用户只需粗略涂抹,AI 即可通过语义分割自动优化掩码边缘,精确到发丝级别。
潜空间(Latent Space):
这是生成式 AI 的“思维空间”。图像并非直接在像素层面进行处理,而是被编码到一个高维的压缩空间(Latent Space)中。在这个空间里,图像的语义特征(如“猫的概念”、“红色的概念”)被解耦并表示为向量。Inpainting 本质上是在潜空间中对缺失部分的向量进行预测和填充,然后再解码回像素空间。这种机制大大降低了计算量,并提高了生成的稳定性。
引导强度(Guidance Scale / CFG Scale):
控制 AI“听话”程度的参数。在基于扩散模型的 Inpainting 中,这个参数决定了生成结果在多大程度上遵循用户的文本提示(Prompt),又在多大程度上遵循原始图像的上下文。数值过高可能导致图像过饱和或失真,数值过低则可能导致 AI 忽略指令,自行其是。2026 年的自适应引导算法能根据区域复杂度动态调整此参数,无需人工干预。
一致性约束(Consistency Constraint):
这是视频 Inpainting 和高保真图像修复的核心。它要求生成的内容不仅在单帧内合理,在多帧之间(视频)或多视角下(3D 重建)也要保持时空一致性。例如,修复视频中走过的人,不能让人在每一帧里衣服花纹都在变化。新一代的时空注意力机制(Spatio-Temporal Attention)完美解决了这一难题。
2. 概念关系图谱
为了理清这些概念,我们可以构建如下的逻辑关系:
- 输入层:原始图像 + 掩码 + 文本提示 -> 进入 编码器。
- 处理层:编码器将数据映射到 潜空间 -> 扩散过程在潜空间中进行去噪 -> 注意力机制 提取全局特征 -> 引导强度 调节文本与图像的权重 -> 一致性约束 确保时空连贯。
- 输出层:解码器将潜变量还原 -> 生成最终图像。
在这个链条中,掩码定义了“在哪里改”,文本提示定义了“改成什么”,潜空间提供了“思考的场所”,而注意力机制则是“思考的方式”。
3. 常见误解澄清
误解一:"Inpainting 只是把东西擦除。”
澄清:擦除(Removal)只是 Inpainting 的一个子集。更高级的应用是“替换”(Replacement)和“扩展”(Outpainting)。你可以把一只猫变成老虎,或者将一张竖构图的照片向左右延伸变成宽屏电影画面。2026 年的 Inpainting 已经演变为一种通用的图像编辑范式,涵盖了增、删、改、扩所有操作。
误解二:"AI 修复的结果是真实的。”
澄清:这是一个危险的误区。Inpainting 生成的是“逼真”的像素,而非“真实”的历史记录。AI 是根据概率“猜”出来的,它可能给被遮挡的手画上六根手指,或者给历史照片中的人物穿上错误的服饰。在司法取证、新闻纪实等领域,必须严格标注哪些部分是经过 Inpainting 处理的,否则将引发严重的伦理和法律问题。
误解三:“分辨率越高,修复效果越好。”
澄清:不完全如此。虽然高分辨率提供了更多细节,但也带来了巨大的显存压力和长程依赖问题。如果模型架构不支持长距离注意力,高分辨率反而会导致修复区域与周围环境割裂。2026 年的主流方案采用了分块处理(Tiled Processing)和层级生成策略,先在大尺度上规划结构,再在小尺度上细化纹理,从而在保证质量的同时突破分辨率限制。
实际应用:从修图工具到产业引擎
Inpainting 是什么?在实验室里它是算法,但在现实生活中,它已经渗透到数字内容创作的每一个角落。从个人用户的手机相册到好莱坞的电影后期,这项技术正在重塑视觉内容的生产流程。
1. 典型应用场景
A. 消费级摄影与社交媒体
这是大众最熟悉的场景。用户可以使用手机一键移除照片中的路人、电线杆或脸上的痘痘。2026 年的智能手机内置了端侧运行的轻量级 Inpainting 模型,无需联网即可在毫秒级时间内完成复杂背景的修复。此外,“魔法橡皮擦”功能已升级为“魔法编辑器”,用户可以圈选衣服,输入“换成红色晚礼服”,即可实时预览换装效果,极大地丰富了社交分享的乐趣。
B. 影视后期与特效制作
在电影工业中,Inpainting 是去除威亚(钢丝)、穿帮镜头和替身演员的神器。传统流程需要艺术家逐帧手工绘制(Rotoscoping),耗时耗力。现在,通过视频 Inpainting 技术,只需标记一次,AI 即可自动跟踪并修复整个序列,且保证光影随镜头运动自然变化。2026 年,这一技术更进一步,支持“动态物体替换”,导演可以在拍摄后随意更改场景中车辆的品牌或行人的数量,而无需重拍。
C. 文化遗产保护与修复
对于破损的古画、老照片,Inpainting 提供了科学的修复手段。通过分析同时代画作的风格特征,AI 可以推测并填补缺失的笔触,甚至还原褪色的色彩。这不仅加快了修复速度,还提供了多种修复方案供专家参考,避免了不可逆的物理损伤。例如,利用该技术,研究人员成功复原了部分被战火损毁的壁画数字档案。
D. 电商与广告设计
商家可以利用 Inpainting 快速生成不同背景的产品图。只需拍摄一张产品白底图,即可将其无缝合成到海滩、雪山或客厅等各种场景中,甚至可以根据季节自动更换模特身上的配饰。这极大地降低了商业摄影的成本,实现了千人千面的个性化广告素材生成。
2. 代表性产品与项目案例
Adobe Photoshop (Generative Fill):
作为行业标杆,Photoshop 集成了基于 Firefly 模型的 Inpainting 功能。它允许设计师通过简单的文字描述和选区操作,实现极其复杂的图像编辑。其优势在于与现有图层、蒙版系统的深度整合,以及商业版权的安全性保障。
Stable Diffusion (Inpainting Mode):
作为开源界的领袖,Stable Diffusion 提供了极高的自由度。配合 ControlNet 等插件,用户可以精确控制修复区域的姿态、边缘和深度。全球开发者基于此构建了无数垂直应用,从动漫角色重绘到建筑设计修改,生态极为繁荣。
Runway Gen-2 / Sora (Video Inpainting):
代表了视频领域的最高水平。这些模型不仅能修复视频中的瑕疵,还能实现视频风格的迁移和内容的动态扩展。2026 年,这类工具已支持长达数分钟的视频连贯修复,成为短视频创作者和电影人的必备工具。
3. 使用门槛与条件
尽管技术日益成熟,但要高质量地使用 Inpainting,仍需满足一定条件:
- 算力需求:本地部署高性能模型(如 SDXL 或更高版本)通常需要配备高端 GPU(如 NVIDIA RTX 4090 或以上),显存建议在 16GB 以上。云端服务则降低了硬件门槛,但涉及隐私和数据传输成本。
- 提示词工程(Prompt Engineering):虽然 2026 年的模型理解能力大幅提升,但精准的描述依然能显著提升效果。用户需要掌握基本的自然语言描述技巧,学会如何描述光影、材质和风格。
- 审美判断力:AI 生成的结果可能存在细微的伪影或不合逻辑之处。使用者必须具备足够的审美能力和专业知识,以识别并修正这些错误,尤其是在专业出版和影视领域。
- 伦理合规意识:在使用 Inpainting 修改人物肖像、新闻图片或涉及版权素材时,必须严格遵守相关法律法规,尊重肖像权和著作权,避免制造虚假信息进行欺诈或诽谤。
延伸阅读:通往未来的阶梯
Inpainting 只是生成式人工智能宏大版图中的一个坐标。要全面掌握这一领域,建议从以下几个维度进行拓展学习。
1. 相关概念推荐
Outpainting(外绘/画布扩展):
Inpainting 的反向操作。不是在图像内部填空,而是向图像外部延伸,根据现有内容想象并生成原本不存在的背景。这是实现“无限缩放”视觉效果的基础。
Image-to-Image (Img2Img):
以一张图为条件生成另一张图。Inpainting 可以看作是 Img2Img 的一种特殊形式(部分区域保持强约束,部分区域弱约束)。理解 Img2Img 有助于掌握风格迁移和草图渲染等技术。
Neural Radiance Fields (NeRF) & 3D Gaussian Splatting:
当 Inpainting 从 2D 走向 3D,这些技术允许用户在三维空间中修复物体。如果你能从任意角度观察修复后的物体而没有破绽,那就是 3D Inpainting 的范畴,这是元宇宙和虚拟现实内容生成的关键。
2. 进阶学习路径
第一阶段:基础应用
熟悉主流工具(Photoshop, Midjourney, Stable Diffusion WebUI)。重点练习掩码绘制技巧和提示词编写,理解不同参数(如 Denoising Strength)对结果的影响。
第二阶段:原理深入
学习深度学习基础,阅读关于 U-Net、Transformer 和 Diffusion Process 的经典论文。尝试在 Python 环境中调用 Hugging Face 的 API 运行开源模型,理解代码层面的实现逻辑。
第三阶段:定制与开发
学习如何微调(Fine-tuning)模型,使用 LoRA 或 DreamBooth 技术训练特定风格或物体的 Inpainting 模型。探索 ControlNet 的高级用法,结合深度图、法线图等多模态条件进行精细化控制。
3. 推荐资源与文献
经典论文:
- "Generative Fill: High-Resolution Image Synthesis with Latent Diffusion Models" (Rombach et al., CVPR 2022) - 奠定了现代 Latent Diffusion 的基础。
- "Repainting Diffusion Models for High-Fidelity Inpainting" - 探讨了如何在扩散模型中更好地处理掩码约束。
- "Video Inpainting with Spatio-Temporal Transformers" - 视频修复领域的里程碑式工作。
在线社区与平台:
- Hugging Face: 获取最新开源模型和数据集的宝库。
- Civitai: 专注于 Stable Diffusion 模型、LoRA 和教程的社区,拥有大量实战案例。
- Papers With Code: 追踪 Inpainting 领域最新的学术论文及其代码实现,查看排行榜(SOTA)。
结语:
从最初的像素修补到如今的理解与创造,Inpainting 技术的发展史就是一部 AI 认知能力的进化史。站在 2026 年的节点回望,我们看到的不仅仅是一项技术的成熟,更是人类创造力边界的无限拓展。Inpainting 不再仅仅是修复过去的遗憾,更是在描绘未来的无限可能。对于每一位学习者而言,理解 Inpainting 是什么,就是握住了开启下一代视觉内容创作大门的钥匙。





