
一句话定义
ViT(Vision Transformer)是一种将图像分割为序列图块并直接输入 Transformer 架构,从而摒弃卷积神经网络、实现纯注意力机制视觉建模的革命性深度学习模型。
技术原理:从“看整体”到“读序列”的范式转移
要理解 ViT(Vision Transformer)是什么,我们首先需要回顾一下计算机视觉领域过去十年的霸主——卷积神经网络(CNN)。传统的 CNN 就像一位拿着放大镜的画家,通过局部感受野(Receptive Field)一步步扫描图像,从边缘、纹理到形状,层层叠加地提取特征。这种机制虽然高效,但存在一个天然缺陷:它在初始阶段很难捕捉到图像的全局信息(Global Context),必须依赖很深的网络层数才能“看到”全貌。
而 ViT 的出现,彻底打破了这一思维定式。它的核心思想极其大胆且优雅:把图像当成文本来处理。在自然语言处理(NLP)领域,Transformer 架构已经证明了其处理序列数据的强大能力。ViT 的创造者提出,既然文本是由单词组成的序列,那么图像为什么不能是由“图块”组成的序列呢?
核心工作机制解析
ViT 的工作流程可以拆解为三个关键步骤,这一过程完美诠释了如何将二维的像素矩阵转化为一维的语义序列:
1. 图像分块(Patch Embedding):
这是 ViT 最标志性的操作。假设我们有一张分辨率为 $224 \times 224$ 的输入图像,ViT 不会直接将其送入网络,而是将其切割成一个个固定大小的小方块(例如 $16 \times 16$ 像素)。这样,原本的一张大图就被切成了 $(224/16) \times (224/16) = 196$ 个小图块。
接下来,每个小图块会被展平(Flatten)成一个向量,并通过一个线性投影层(Linear Projection)映射到一个固定维度的潜在空间(Embedding Space)。这就好比把一幅画剪成了 196 块拼图,然后给每一块拼图编上了一个数字代号。
2. 位置编码与类标记(Position Embeddings & Class Token):
Transformer 架构本身是“排列无关”的(Permutation Invariant),它不知道谁在前谁在后。但在图像中,左上角的图块和右下角的图块位置关系至关重要。因此,ViT 会给每个图块的向量加上一个“位置编码”,告诉模型这个图块在原图中的具体坐标。
此外,ViT 还会在序列的最前面插入一个特殊的可学习向量,称为 `[CLS]` 标记(Class Token)。这个标记不对应任何具体的图像区域,它的任务是在经过多层处理后,汇聚整张图像的全局特征,最终用于分类任务。这就像是在阅读一篇文章前,先放一个“总结员”,让他读完所有段落后给出中心思想。
3. Transformer 编码器(Transformer Encoder):
经过上述处理,图像变成了一串带有位置信息的向量序列。这串序列被送入标准的 Transformer 编码器中。编码器的核心是自注意力机制(Self-Attention Mechanism)。
在这里,每一个图块都可以“关注”到序列中的其他所有图块。无论两个图块在图像上相距多远,它们在计算层面的距离都是相等的(即一步可达)。这种机制使得 ViT 在第一层就能捕捉到全局依赖关系,这是传统 CNN 需要堆叠数十层才能勉强做到的。
关键技术组件说明
在深入理解 ViT 是什么时,必须掌握其内部的几个核心组件,它们共同构成了模型的骨架:
- 多头自注意力(Multi-Head Self-Attention, MSA):这是 ViT 的“大脑”。它允许模型在不同的表示子空间中并行地关注图像的不同部分。例如,一个“头”可能关注物体的轮廓,另一个“头”关注物体的颜色纹理。这种并行处理能力极大地丰富了特征的表达能力。
- 多层感知机(MLP Block):位于注意力层之后,负责对提取到的特征进行非线性变换和进一步加工,类似于传统神经网络中的全连接层,但作用于每个图块独立进行。
- 层归一化(Layer Normalization)与残差连接(Residual Connection):为了保证深层网络的训练稳定性,ViT 在每个子层前后都使用了层归一化,并引入了残差连接,防止梯度消失,确保信息能够顺畅地在深层网络中传递。
与传统方法的对比:卷积 vs. 注意力
为了更直观地理解 ViT 的优势,我们可以使用一个生动的类比:
想象你要描述一场足球比赛的照片。
- CNN(卷积神经网络) 就像是一个拿着望远镜的观察者。他只能看到视野中心的一小块区域(局部感受野)。为了了解整个球场的局势,他必须不停地移动望远镜,把看到的局部信息在脑海中一点点拼凑起来。如果球员分布在球场两端,他需要移动很多次才能建立两者之间的联系。
- ViT(Vision Transformer) 则像是一个拥有“上帝视角”的指挥官,或者说是同时拥有了 196 个分身。他的每一个分身站在一个小格子里,但他可以通过无线电(自注意力机制)瞬间与场上任何其他位置的分身通话。无论前锋在左路,后卫在右路,他们之间的配合关系可以瞬间被建立和分析。
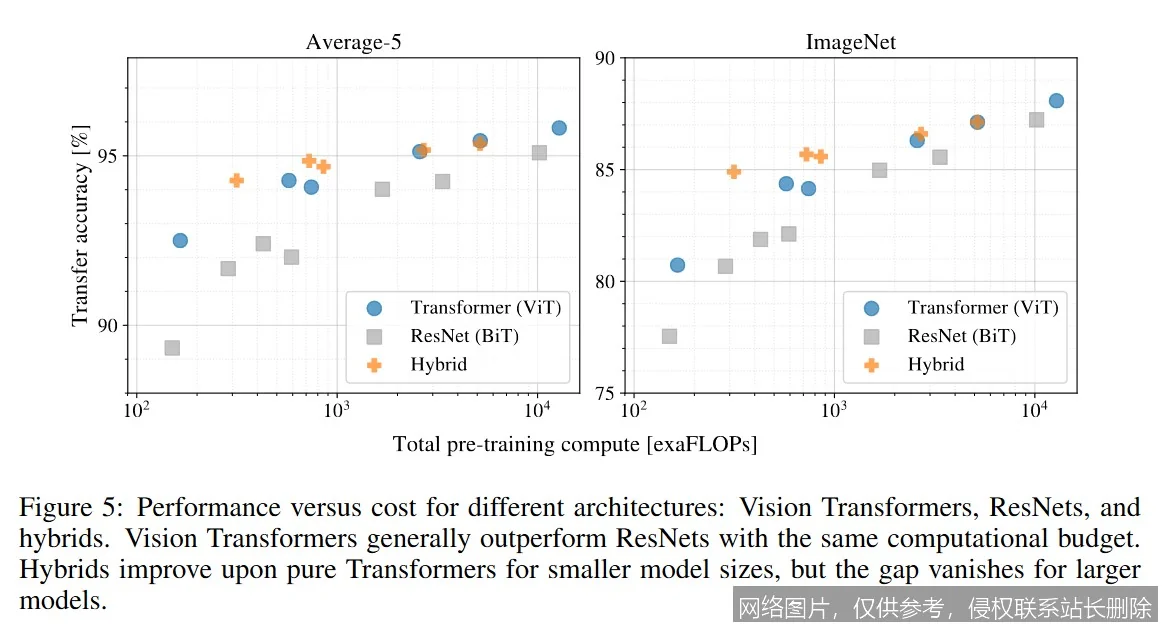
这种全局感受野(Global Receptive Field)是 ViT 相对于 CNN 的最大理论优势。然而,这也带来了代价:CNN 具有强烈的归纳偏置(Inductive Bias),如平移不变性(物体移动位置不影响识别)和局部性,这使得 CNN 在小数据集上也能表现良好。而 ViT 缺乏这种先天偏置,它更像是一张白纸,需要海量的数据(如 JFT-300M 或 ImageNet-21K)来“学习”这些规律。因此,ViT 是什么?它本质上是一个数据饥渴型但上限极高的模型架构。
核心概念:构建视觉理解的基石
在探讨 ViT 是什么及其衍生应用时,理清相关术语和概念关系至关重要。这部分将帮助读者建立起完整的知识图谱。
关键术语解释
1. Patch(图块):
ViT 处理图像的基本单元。不同于像素(Pixel),Patch 是一小块包含多个像素的区域。Patch 的大小(如 $16 \times 16$)是一个重要的超参数:Patch 越小,序列越长,计算量越大,但保留的细节越多;Patch 越大,计算越快,但可能丢失细粒度特征。
2. Self-Attention(自注意力):
一种机制,用于计算序列中每个元素与其他所有元素的相关性权重。在 ViT 中,它决定了某个图块在生成特征时,应该“重视”哪些其他图块的信息。数学上,它通过查询(Query)、键(Key)和值(Value)矩阵的运算来实现。
3. Inductive Bias(归纳偏置):
机器学习模型对数据分布的预先假设。CNN 的归纳偏置是“局部相关”和“平移不变”,这让它擅长处理图像。ViT 的归纳偏置很少,主要假设是“序列中任意两点都可能相关”。这使得 ViT 更灵活,但也更难训练。
4. Pre-training(预训练):
由于 ViT 缺乏归纳偏置,它通常需要在大规模数据集上进行预训练,学习通用的视觉表示,然后再在特定任务(如医学图像分类)上进行微调(Fine-tuning)。这是 ViT 成功的必要条件。
概念之间的关系图谱
理解 ViT 是什么,不能孤立地看它,而要将其置于技术演进的脉络中:
- Transformer (NLP) $\rightarrow$ ViT (CV):这是跨领域的迁移。Transformer 证明了序列建模的威力,ViT 将其成功移植到视觉领域。
- ViT $\rightarrow$ Swin Transformer / DeiT:ViT 是鼻祖,但存在计算复杂度随图像分辨率平方级增长的问题。后续的 Swin Transformer 引入了滑动窗口机制,恢复了局部性,降低了计算量;DeiT 则改进了蒸馏策略,让小数据训练成为可能。它们是 ViT 的进化形态。
- ViT + LLM $\rightarrow$ VLM (视觉语言模型):这是当前的终极形态。ViT 作为“眼睛”提取视觉特征,LLM 作为“大脑”进行推理和生成。二者结合诞生了如 CLIP、Flamingo 以及未来的多模态助手。
常见误解澄清
在学习过程中,关于 ViT 是什么,常存在一些误区,需要在此澄清:
- 误解一:"ViT 完全抛弃了卷积。”
- 真相:纯粹的 ViT 确实不包含卷积层。但在实际工程应用中,许多改进版的 ViT(如 ConvNeXt 或混合架构)会重新引入卷积操作来处理下采样或增强局部特征提取。卷积并未死亡,而是与注意力机制融合了。
- 误解二:"ViT 在任何情况下都比 CNN 好。”
- 真相:并非如此。在数据量较小、计算资源受限或对实时性要求极高的边缘设备场景中,经过高度优化的 CNN(如 EfficientNet)往往仍然优于 ViT。ViT 的优势主要在大数据规模和复杂场景理解上。
- 误解三:“图块切得越细越好。”
- 真相:切分过细会导致序列长度急剧增加,自注意力机制的计算复杂度是序列长度的平方级($O(N^2)$),这会带来巨大的显存和算力负担,可能导致模型无法训练或推理过慢。
实际应用:从实验室走向 2026 年的智能世界
ViT 不仅仅是一个学术概念,它已经深刻改变了工业界,并将持续引领未来几年的技术浪潮。从自动驾驶到医疗诊断,再到即将到来的通用人工智能(AGI)雏形,ViT 的应用版图正在极速扩张。
典型应用场景列举
1. 高精度图像分类与识别:
这是 ViT 的“老家”。在 ImageNet 等基准测试中,ViT 及其变体屡屡刷新纪录。在电商领域,它被用于海量商品图的自动归类;在安防领域,用于复杂背景下的人脸与行为识别。由于其全局建模能力,它在处理遮挡、形变等大难度场景时表现尤为出色。
2. 目标检测与语义分割:
通过适配不同的解码器(如 DETR - Detection Transformer),ViT 可以直接输出物体的边界框和类别,甚至对图像的每个像素进行分类(分割)。这在自动驾驶中至关重要,车辆需要精确识别道路、行人、交通标志的轮廓,ViT 的全局视野能有效减少误检。
3. 多模态检索与生成(AIGC):
这是目前最火热的应用方向。以 DALL-E 3、Midjourney v6 为代表的文生图模型,其底层往往利用了类似 ViT 的架构(如 VQ-GAN 中的 Transformer 部分或 DiT - Diffusion Transformer)来理解文本提示并生成高质量图像。ViT 作为视觉编码器,能够将图像转化为机器可理解的向量,实现“以图搜图”或“图文互译”。
4. 医疗影像分析:
在病理切片分析、CT/MRI 影像诊断中,病灶往往微小且分散。CNN 容易漏掉长距离的关联特征,而 ViT 能够同时关注切片的不同区域,发现潜在的病变模式,辅助医生进行早期癌症筛查。
代表性产品与项目案例
- CLIP (Contrastive Language-Image Pre-training):由 OpenAI 推出。它利用 ViT 作为图像编码器,将图像和文本映射到同一向量空间。这使得模型具备了惊人的“零样本”(Zero-shot)学习能力,无需专门训练即可识别从未见过的物体。它是当前多模态大模型的基石。
- Segment Anything Model (SAM):Meta 发布的重磅模型。SAM 基于 ViT 架构,具备了强大的泛化分割能力。用户只需点击一下,它就能精准分割出图中的任何物体。这标志着计算机视觉从“专用模型”向“通用基础模型”的跨越。
- 特斯拉 FSD (Full Self-Driving):虽然特斯拉的具体架构细节保密,但其最新的端到端神经网络方案大量借鉴了 Transformer 思想,利用类似 ViT 的机制处理多摄像头输入的时序视频流,实现了对周围环境的 3D 重构和路径规划。
展望 2026:视觉语言应用的全面爆发
当我们把目光投向 2026 年,ViT 将不再仅仅是一个独立的视觉模型,它将彻底融入视觉语言模型(VLM, Vision-Language Models)的血液中,成为 AI 感知世界的标准器官。
届时,我们将看到以下趋势:
1. 原生多模态交互:未来的 AI 助手将不再区分“看图”和“读字”。基于 ViT 的视觉编码将与大语言模型(LLM)深度耦合。你可以指着冰箱里的食材问 AI:“这些能做什么菜?”AI 不仅能识别食材,还能结合你的口味偏好生成食谱,甚至控制智能厨具开始烹饪。
2. 具身智能(Embodied AI)的核心:机器人将普遍搭载基于 ViT 的视觉系统。不同于现在的规则式编程,2026 年的机器人将通过 ViT 理解复杂的家庭环境,执行“把桌子上那个红色的杯子拿给我”这类模糊指令。ViT 的全局理解能力让机器人能像人一样“眼观六路”。
3. 实时视频理解与预测:随着硬件算力的提升和稀疏注意力机制(Sparse Attention)的成熟,ViT 将能够实时处理高分辨率视频流。监控系统将不再是事后查证的工具,而是能实时预测异常行为(如跌倒、打架)并报警的智能卫士。
使用门槛和条件
尽管前景广阔,但要落地应用 ViT,仍需考虑以下条件:
- 算力需求:训练大型 ViT 需要昂贵的 GPU 集群(如 NVIDIA A100/H100)。对于中小企业,通常选择使用预训练好的开源模型进行微调,而非从头训练。
- 数据规模:如果没有千万级的数据,直接训练 ViT 效果可能不如成熟的 CNN。此时需采用知识蒸馏(Knowledge Distillation)技术,用大模型教小模型,或使用强数据增强策略。
- 工程优化:在生产环境中部署 ViT,需要进行量化(Quantization)、剪枝(Pruning)等优化,以适应移动端或边缘设备的延迟要求。
延伸阅读:通往专家之路
如果你已经理解了 ViT 是什么,并希望在这一领域继续深耕,以下路径和资源将助你一臂之力。
相关概念推荐
为了构建更完整的知识体系,建议进一步研究以下概念:
- Swin Transformer:了解如何通过移位窗口机制解决 ViT 的计算复杂度问题,恢复层级结构。
- Masked Autoencoders (MAE):一种高效的自监督学习方法,通过随机掩码图像图块并让模型重建,大幅降低了对标注数据的依赖。
- Diffusion Transformers (DiT):探索 Transformer 如何在扩散模型(当前最强的生成模型架构)中替代传统的 U-Net,成为图像生成的新引擎。
- Multimodal Large Language Models (MLLM):研究 ViT 如何与 LLaMA、Qwen 等语言模型对接,形成像 LLaVA 这样的多模态系统。
进阶学习路径
1. 基础阶段:熟练掌握 Python 和 PyTorch/TensorFlow 框架。重温线性代数中的矩阵运算,特别是注意力机制背后的 $Q, K, V$ 矩阵推导。
2. 复现阶段:不要只读论文。尝试在 GitHub 上找到 ViT 的官方或高星实现代码(如 `rwightman/pytorch-image-models`),在 CIFAR-10 或 ImageNet 子集上跑通训练流程。亲手调整 Patch Size、层数等超参数,观察效果变化。
3. 进阶阶段:阅读最新的 ArXiv 论文,关注 CVPR、ICCV、NeurIPS 等顶级会议的口头报告。尝试修改现有架构,例如设计新的位置编码方式,或将 ViT 应用于非图像数据(如时间序列预测)。
4. 实战阶段:参与 Kaggle 竞赛或开源项目,解决实际的工业问题。尝试将一个大模型蒸馏到手机端,体验工程落地的挑战。
推荐资源和文献
- 奠基之作:
- 论文:*"An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale"* (Dosovitskiy et al., ICLR 2021)。这是 ViT 的开山之作,必读。
- 经典综述:
- 文章:*"A Survey on Vision Transformer"* (IEEE TPAMI 2022)。全面梳理了 ViT 的各类变体和发展脉络。
- 在线课程与教程:
- Hugging Face Course:提供了关于 Transformer 和 ViT 的免费交互式教程,代码示例丰富,适合初学者上手。
- Stanford CS231n / CS325B:斯坦福大学的计算机视觉课程,近年来已大幅增加 Transformer 相关内容。
- 代码库:
- timm (PyTorch Image Models):由 Ross Wightman 维护,是目前最全面的 PyTorch 视觉模型库,包含了几乎所有主流的 ViT 变体,代码质量极高,是学习实现的绝佳范本。
- Google Research Vision Transformer Repository:官方原始代码实现,适合对照论文研读。
ViT 的出现标志着计算机视觉进入了一个新的纪元。它告诉我们,有时候,打破常规、跨界融合(将 NLP 的方法用于 CV),往往能迸发出最耀眼的创新火花。从 2020 年的横空出世到 2026 年的无处不在,ViT 不仅是技术的革新,更是我们理解机器如何“看”世界的一把钥匙。希望这篇解析能帮助你不仅知道 ViT 是什么,更能洞察其背后的逻辑与未来。





