直接答案:GPT-6.2 Astra 和 GPT-6.2 Sol 已经发布,但“发布了”不等于每个 ChatGPT 聊天窗口都会出现。按照 OpenAI 2026 年 11 月 17 日至 18 日的当前说明,它们首先面向 ChatGPT Work、Codex 和 API:Astra 偏向最难、约束最多的专业任务;Sol 偏向日常多模态工作和工具调用。普通 ChatGPT 的常规聊天入口不应和 ChatGPT Work 混为一谈。如果你的模型选择器里没有 6.2,先查入口、套餐、地区和管理员设置,不要先判断账号故障。
适用对象:想知道自己能不能用、该选哪一个的个人与办公用户,使用 Codex 的开发者,以及管理团队模型权限的人。本文核验日期为 2026 年 11 月 18 日。本站没有完成多套餐、多地区的受控账号矩阵,也没有运行 Astra 与 Sol 的同输入性能评测;下文会把官方事实、确定性检查和需要你在自己账号里验证的部分分开。
先分清四个入口,最容易误解的是 Work 和普通 Chat
| 你正在使用的入口 | 当前该怎么理解 GPT-6.2 | 先检查什么 |
|---|---|---|
| 普通 ChatGPT 聊天 | 不要因为看到发布新闻就认定常规聊天选择器必然已有 6.2 | 产品入口名称、当前套餐与官方发布说明 |
| ChatGPT Work | OpenAI 把 Astra 和 Sol 放入 Work 的模型选择范围,实际可见性仍受推出进度和管理设置影响 | Work 模式、套餐、管理员是否允许、模型选择器 |
| Codex | 两款模型用于编码与专业工作;应按任务难度、速度和成本选择 | Codex 当前模型列表、版本、组织策略和任务验收 |
| OpenAI API | 可按官方模型 ID 调用;带工具的工作流要核对 Responses API 要求 | 模型 ID、API 端点、参数兼容、预算和数据要求 |
ChatGPT Work 是面向任务执行的工作入口,不是给普通 Chat 换了一个名字。OpenAI 当前帮助页把 6.2 的 Work 与 Codex 可用性、套餐和模型选择放在同一条产品说明里;这也是为什么有些人能在 Work 或 Codex 看到模型,却在日常聊天窗口找不到。
Astra 和 Sol 的选择,不是“强”和“弱”的单线排名
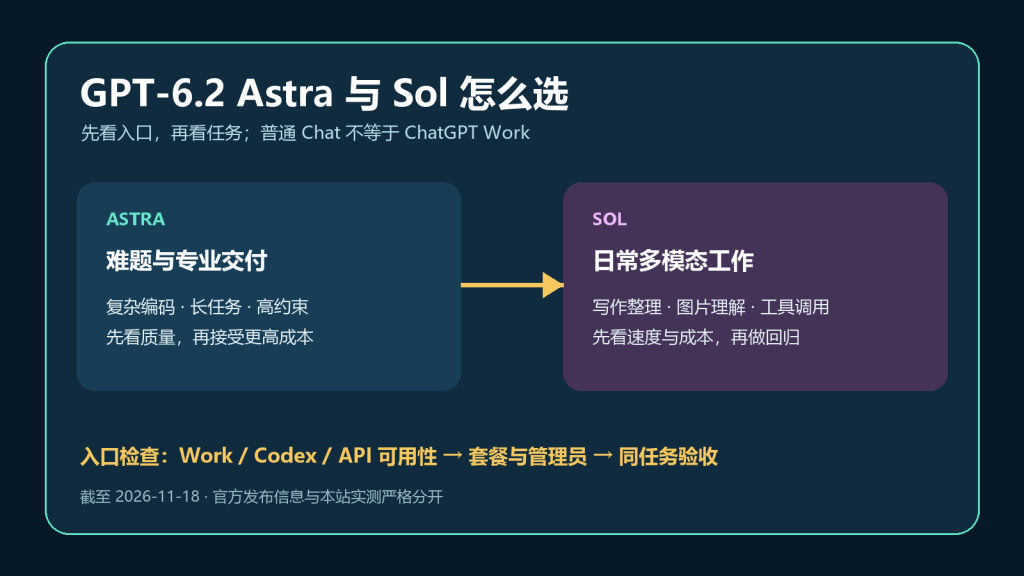
更实用的判断是:这次任务失败的代价有多高,以及你愿意为一次更深的推理付出多少时间和成本。OpenAI 将 Astra 放在高难度、专业交付和长程任务一侧;Sol 则承担更广泛的日常工作、多模态理解和工具流程。两者的定位不同,并不意味着 Sol 不能做复杂任务,也不意味着 Astra 在每个短任务上都更划算。
| 任务特征 | 优先试 Astra | 优先试 Sol |
|---|---|---|
| 难度与约束 | 跨文件重构、复杂分析、长链路代理、要求严格的专业成品 | 日常写作整理、常规编码、图片理解、重复性工具任务 |
| 失败代价 | 错误会造成高额返工,愿意先换更强能力再控制范围 | 任务可快速复核,吞吐、响应速度或预算更重要 |
| 验证方式 | 用真实高难任务检查正确性、边界遵守和完整交付 | 用高频样本检查速度、稳定性、格式和单位成本 |
| 不该只看 | 模型名称、一次漂亮回答、官方演示或别人账号里的选择器截图 | |
如果你拿不准,可以先用 Sol 跑一条熟悉任务;当它在推理深度、长程一致性或复杂约束上达不到验收线,再把相同输入、相同文件和相同标准交给 Astra。这样得到的是与你工作有关的选择,而不是把发布会定位当成自己的测试结果。
个人和办公用户:先用三步排除“为什么我没有”
- 确认入口。先看界面是否明确写着 ChatGPT Work 或 Codex。仅在普通聊天窗口查看,不足以判断 6.2 是否对你的产品入口开放。
- 确认套餐与推出状态。查看 OpenAI 当前帮助页,而不是只看社交平台截图。分批推出、地区和计划差异都可能让两个账号出现时间不同。
- 确认组织控制。工作账号还可能受管理员模型策略限制。个人能看到、同事看不到,不一定是浏览器缓存问题。
如果三项都符合但仍不可见,再做退出重登、更新客户端和查看服务状态等常规检查。不要为了追新模型把敏感资料复制到个人账号;公司文件仍应遵守组织的数据和访问政策。
团队管理员:开放模型前先确定谁能用、用来做什么
团队不宜把“所有人立即切 Astra”当作上线方案。先选两到四类真实任务,写清输入数据等级、允许调用的工具、预算、人工复核点和失败回退。然后确认 Work、Codex 与 API 的权限分别由谁管理,避免员工以为聊天选择器里的权限自动等于 API 或编码代理权限。
一条最小团队回执可以包含:入口、套餐或组织、模型、任务、工具权限、数据类别、结果是否通过、耗时或成本、失败原因、复核人和日期。它比“模型已经上线”的群公告更能回答是否真的可用。
API 开发者:模型 ID 只是迁移的第一步
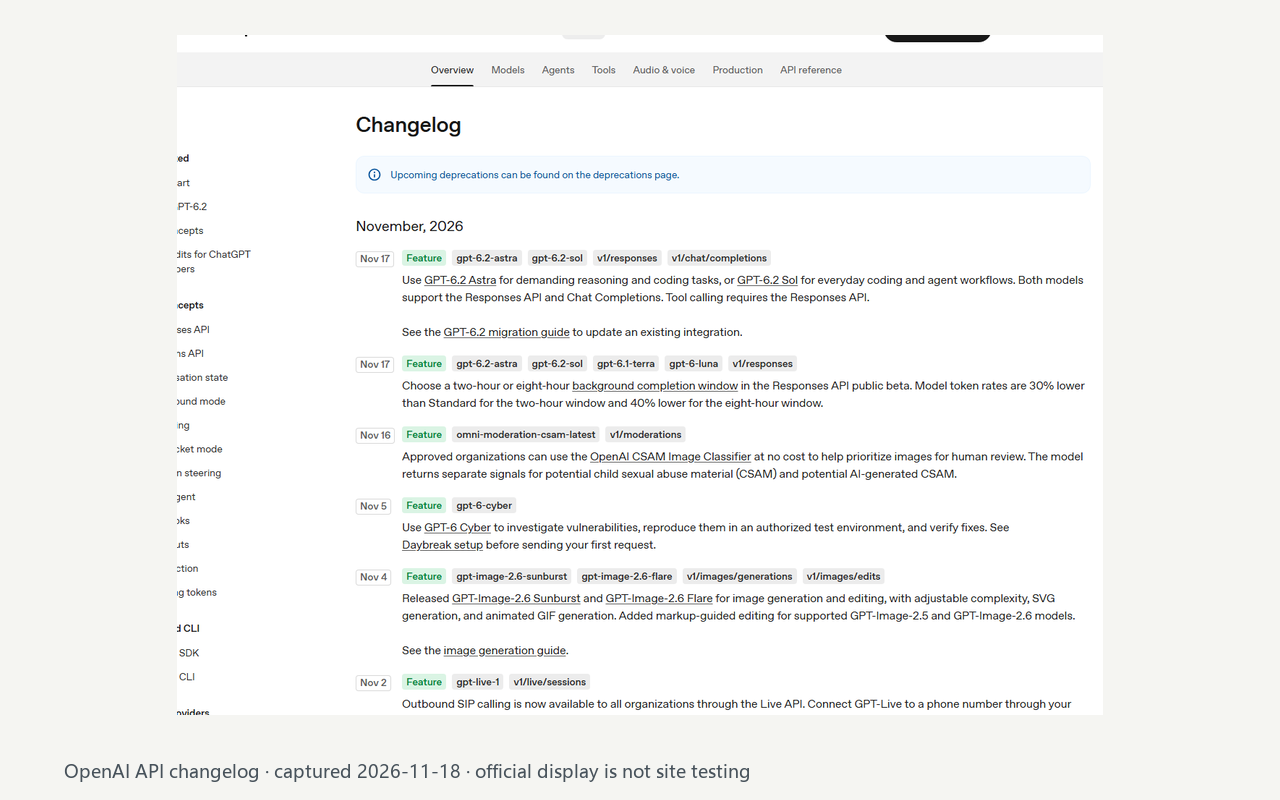
OpenAI 当前 API 文档列出 gpt-6.2-astra 与 gpt-6.2-sol。基础文本调用可以从官方模型页和变更日志核对;如果工作流需要网页搜索、文件搜索、计算机操作或其他内置工具,应优先检查 Responses API 的要求。不要只替换模型字符串后就宣布迁移完成。
迁移时至少复核四项:旧参数是否仍兼容、reasoning 设置是否适合任务、缓存与长上下文是否改变成本、数据驻留或零数据保留是否满足组织要求。本站已有一篇更偏技术实施的 GPT-6 API 迁移与模型选择指南;本页不重复展开完整代码和参数表。
怎样做一次不冒充“实测”的账号内验证
下面是读者可执行的验收方法,不是本站已经替你跑过的结果:
- 同输入:保存一条你已经知道合格答案的真实任务,避免临时编一个无法判断对错的问题。
- 同环境:使用相同文件、工具权限、上下文和输出格式,分别运行可用模型。
- 先定标准:在看到结果前写下事实正确、遗漏、格式、可执行性、耗时与成本等指标。
- 记录失败:工具没有执行、权限不足、输出中断或模型不可见,都应作为结果保留,而不是只截成功页面。
- 人工复核:涉及代码部署、合同、财务、医疗或安全决定时,模型输出不能替代相应责任人。
如果你只想完成日常总结、图片说明或常规工具流,先试 Sol 往往更便于观察速度与预算;如果任务跨越多个文件、需要长程规划或对错误非常敏感,再用 Astra 做同条件对照。最终选择应来自你的通过率和返工成本,而不是本文替你下结论。