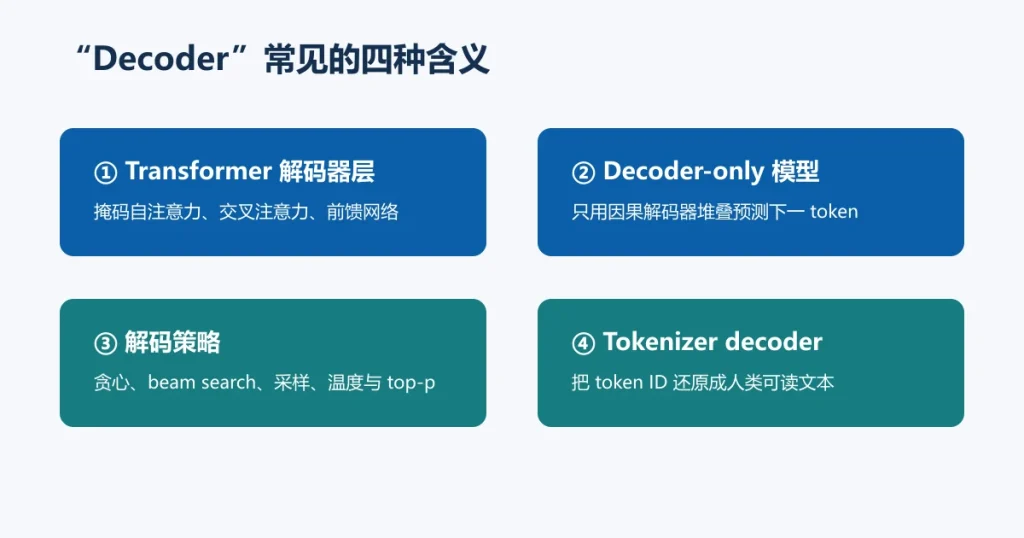
直接答案:在大模型语境里,Decoder 最常指 Transformer 解码器:它通过因果掩码只读取当前位置之前的 token,并预测下一个 token。GPT 类“decoder-only”模型就是把这种模块堆叠起来。但工程文档中的 decoder 也可能指编码器—解码器架构的后半部分、把概率变成文本的解码策略,或把 token ID 还原字符串的 tokenizer decoder。先判断语境,才能避免把四个不同概念混为一谈。
本文面向需要读懂模型架构、推理参数或技术文档的读者,依据 Transformer、BERT、T5、GPT-3、Multi-Query Attention 与 Hugging Face 当前文档复核,日期为 2026-09-15。
先分清 Decoder 的四种含义
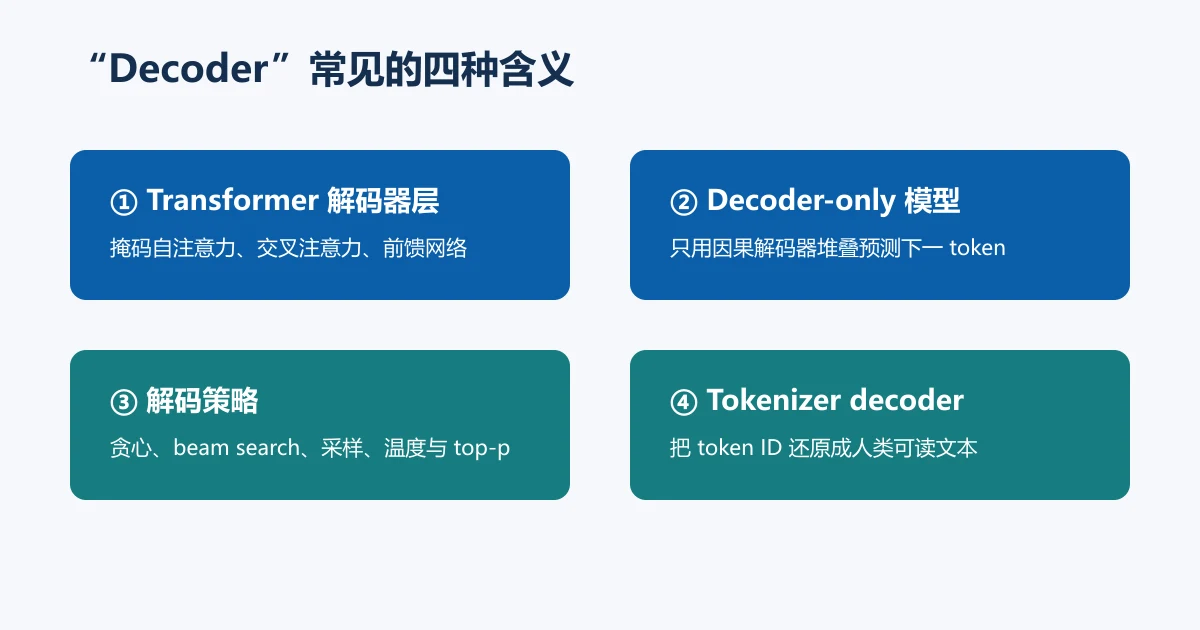
| 语境 | Decoder 指什么 | 常见线索 |
|---|---|---|
| Transformer 架构图 | 由注意力、前馈网络、残差与归一化组成的解码器层 | masked self-attention、cross-attention |
| 模型家族 | 只使用因果解码器堆叠的语言模型 | decoder-only、causal LM |
| 生成参数 | 从下一 token 概率中选择输出的算法 | greedy、beam、temperature、top-p |
| Tokenizer | 把 token ID 序列还原成文本的组件 | decode、skip special tokens |
“模型采用 decoder-only 架构”不代表它只有一个名叫 Decoder 的软件模块;“更换 decoder 参数”也可能只是在改变采样策略,而不是修改神经网络结构。
Transformer 原论文里的解码器
2017 年《Attention Is All You Need》提出的 Transformer 是编码器—解码器架构。编码器读取源序列并产生表示;解码器一边读取已经生成的目标 token,一边通过交叉注意力读取编码器输出,最后预测下一个目标 token。
掩码自注意力
训练时目标句子的多个位置可以并行计算,但位置 t 不能偷看位置 t+1 的正确答案。因果掩码把未来位置的注意力分数屏蔽掉,使训练条件与生成条件一致。直观地说,在预测“天”时,模型可以利用“今”“天”之前已经出现的 token,却不能读取尚未生成的后文。
交叉注意力
在原始编码器—解码器中,查询来自解码器当前状态,键和值来自编码器输出。因此翻译模型生成目标语言时,可以有选择地关注源句不同位置。decoder-only 模型没有独立编码器,也就没有这层标准意义上的编码器—解码器交叉注意力;上下文被放在同一因果序列中处理。
前馈网络、残差与归一化
注意力负责跨位置汇聚信息,逐位置前馈网络负责非线性变换;残差连接和归一化帮助深层网络训练。实际模型可能采用 pre-norm、不同激活函数、旋转位置编码或其他变体,但“因果地预测下一 token”仍是理解生成式解码器的主线。
三类主流架构怎么选择
| 架构 | 信息流 | 典型训练目标 | 常见任务 |
|---|---|---|---|
| Encoder-only | 每个位置通常可双向读取上下文 | 掩码语言建模等 | 分类、检索表示、序列标注 |
| Encoder-decoder | 编码器双向读取输入,解码器因果生成并交叉关注输入 | 输入到目标序列转换 | 翻译、摘要、结构化转换 |
| Decoder-only | 所有上下文放入同一因果序列 | 下一 token 预测 | 开放生成、对话、代码与通用提示任务 |
BERT 是 encoder-only 代表之一;T5 把多种任务统一为文本到文本的 encoder-decoder 形式;GPT-3 展示了大型自回归语言模型通过上下文示例完成多种任务的能力。架构并非质量排行榜:选择取决于输入输出形式、延迟、训练数据、部署工具链和目标指标。
Decoder-only 模型怎样生成文本
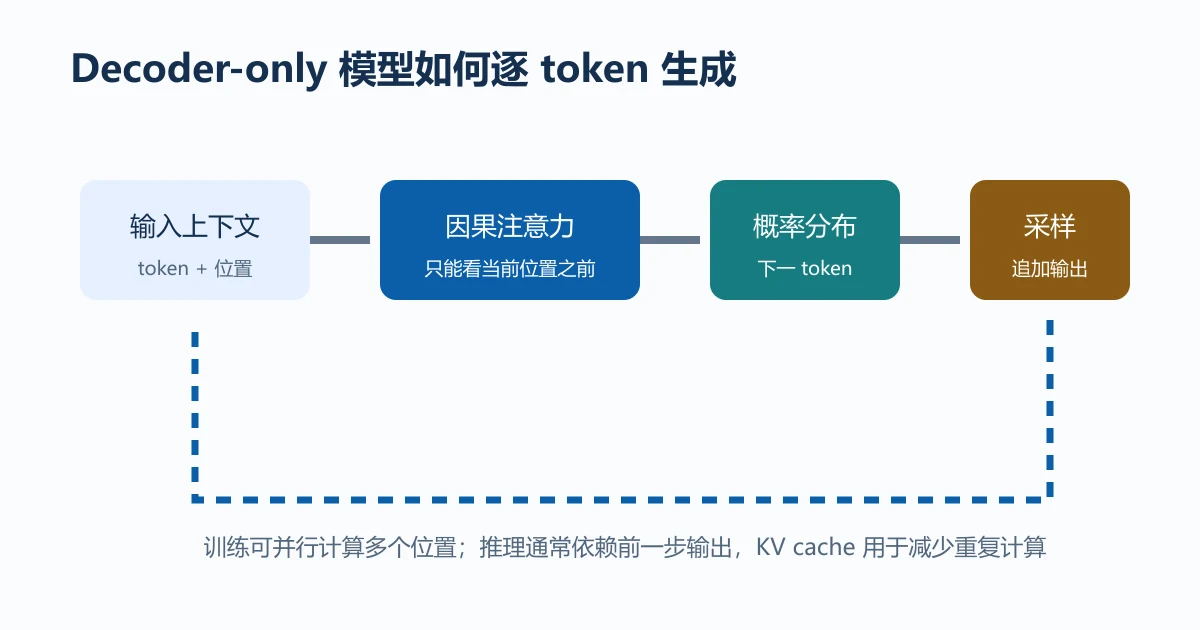
- Tokenizer 把输入文本变成 token ID,并加入模型需要的特殊标记。
- 嵌入层把 token 与位置信息转换为向量。
- 多层因果注意力和前馈网络计算当前上下文表示。
- 输出头把最后位置表示转换为词表上的 logits,再归一化为概率。
- 解码策略选择下一个 token,把它追加到序列。
- 遇到结束标记、达到长度上限或满足停止条件时结束。
训练阶段已知完整目标序列,可以通过移位标签并行计算多个位置的损失;在线生成阶段后一个 token 依赖前一个输出,因此通常是串行的。这也是推理延迟与吞吐优化的关键背景。
KV Cache、MQA 与 GQA 为什么重要
如果每生成一个 token 都重新计算全部历史 token 的键和值,会造成大量重复计算。KV cache 保存每层已经计算的 key/value,新一步只计算新 token 并与缓存交互。Hugging Face 文档提醒,不同 cache 实现对内存、编译兼容和卸载策略有不同取舍。
Multi-Query Attention(MQA)让多个查询头共享一组 key/value,从而减少增量解码时需要读取的缓存和内存带宽;Grouped-Query Attention(GQA)在多头与单组共享之间折中,让若干查询头共享一组 key/value。它们主要改变推理效率与容量取舍,不会把自回归生成变成一次性并行完成。
| 机制 | 核心作用 | 代价或边界 |
|---|---|---|
| KV cache | 避免对历史 token 重复计算 K/V | 长上下文会占用显存或内存 |
| MQA | 所有查询头共享 K/V,降低带宽和缓存 | 可能影响模型质量,需要训练验证 |
| GQA | 按组共享 K/V,在质量与效率间折中 | 组数是架构配置,不是生成参数 |
| Speculative decoding | 用较小草稿模型提出多个候选,由目标模型验证 | 收益依赖草稿与目标分布匹配及实现开销 |
解码策略不是神经网络 Decoder
模型输出 logits 后,还要决定怎样选 token。贪心解码每次选最高概率;beam search 保留若干候选序列,常用于有明确序列目标的任务;随机采样按概率抽取,temperature 调整分布尖锐程度,top-k 或 top-p 限制候选集合。改变这些参数不会重新训练模型,但会改变稳定性、多样性和复现性。
| 策略 | 优点 | 风险 | 适用起点 |
|---|---|---|---|
| Greedy | 简单、可重复 | 可能过早落入局部高概率表达 | 分类式输出、基线测试 |
| Beam search | 系统比较多条序列 | 成本更高,开放对话未必更好 | 翻译等序列转换 |
| Temperature + top-p | 可调多样性 | 随机性增加,不能保证事实正确 | 创意生成与对话 |
| 受约束解码 | 限制格式或词法范围 | 约束冲突可能导致失败 | JSON、语法或结构化输出 |
事实正确性不能靠把 temperature 调低来保证。低温度只让输出更集中;如果模型的高概率答案本身错误,它会更稳定地重复错误。需要结合检索证据、工具校验、结构约束与人工门禁。
一个最小可验证例子
假设输入是“法国的首都是”。Tokenizer 将其切成若干 token。模型根据上下文计算下一个 token 的分布,“巴黎”相关 token 可能得到较高概率。解码策略选中后追加到序列,再预测标点或后续词。因果掩码保证每一步只依赖已有上下文;tokenizer decoder 最后把 ID 序列拼回可读文本。这里至少同时出现了“模型解码器”“解码策略”和“tokenizer decoder”三种概念。
读模型文档时的检查清单
- 配置中的
is_encoder_decoder是否为真,是否存在独立 encoder 输出; - 任务头是 causal language modeling 还是 sequence-to-sequence;
- 上下文长度、位置编码和特殊 token 怎样定义;
- 注意力采用 MHA、MQA 还是 GQA,KV cache 支持哪些实现;
- 生成参数的默认值、随机种子和停止条件;
- 吞吐、首 token 延迟、每 token 延迟与峰值内存分别怎样测;
- 输出格式、事实核验和工具调用是否有独立门禁。
更多基础概念可查看AI 概念与词典,动手配置模型可进入AI 教程,涉及上线评测时应同时参考AI Red Teaming 指南和本站核验规范。
如何用配置和输出验证你的判断
不要只依据营销页面判断架构。开源模型可查看配置中的模型类型、是否存在 encoder、注意力头与 key/value 头数量、位置编码和缓存实现;再用固定提示、固定随机种子和明确停止条件记录输出。闭源 API 只能验证公开接口行为,不能据此断言内部一定采用某种未公开结构。
性能测试应至少拆分输入 token 数、输出 token 数、首 token 延迟、生成阶段每 token 延迟、吞吐和峰值内存。KV cache 主要影响增量生成,不应拿短输入的单次总耗时直接证明缓存方案优劣。比较不同解码策略时,保持模型、提示、硬件和最大输出长度一致,并把事实正确率与文本多样性分开评价。
常见问题
ChatGPT 一类模型都是 encoder-decoder 吗?
不能仅凭产品名称判断具体实现,但 GPT 论文所代表的语言模型路线通常称为 decoder-only:输入和已生成内容放在同一因果序列中。不同商业产品可能还组合检索、工具、视觉编码器和其他模块。
Decoder-only 为什么也能理解输入?
“only”表示没有独立的 Transformer encoder 堆栈,不表示模型看不到输入。提示词、资料与历史消息都作为上下文 token 进入因果解码器,后续位置可以关注此前位置。
KV cache 会改变模型答案吗?
标准缓存的目标是复用已计算的键和值,理论上不改变同一数值实现下的分布。但量化、滑动窗口、缓存截断或不同内核可能引入差异,需要以目标硬件上的回归测试为准。
来源与复核记录
- Attention Is All You Need
- BERT: Pre-training of Deep Bidirectional Transformers
- T5: Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer
- Language Models are Few-Shot Learners(GPT-3)
- Fast Transformer Decoding: One Write-Head is All You Need(MQA)
- GQA: Training Generalized Multi-Query Transformer Models
- Accelerating Large Language Model Decoding with Speculative Sampling
- Hugging Face:Encoder Decoder Models
- Hugging Face:KV cache strategies
兰塞 AI 编辑部于 2026-09-15 复核。论文用于说明公开架构和算法,具体商业模型的未公开实现不从产品表现反推。